Wie man ein zweites Gehirn für KI-Agenten strukturiert
Jede je geschriebene Wissensmethode setzt voraus, dass man morgen noch dieselbe Person ist. Ein Agent ist das nicht — und das ändert das ganze Design.

TL;DR
PARA und Zettelkasten setzen einen Leser voraus, der sich an gestern erinnert. Ein Agent tut das nicht — er bekommt einen kalten Abruf pro Run, browst nie und bezahlt für jedes Zeichen, das er lädt. Struktur geht damit nicht mehr darum, Dinge zu finden, sondern darum, gefunden zu werden. Was folgt, ist das Design-Review vor dem Umbau unseres eigenen Speichers: was die Forschung baut, die fünf Formen zur Auswahl, der indexierte Hub über atomaren Dokumenten, für den wir uns entschieden haben, die fünf Regeln, die ihn ehrlich halten, und das Zielbild, auf das wir zusteuern. Der Stand der Technik ist hier kein Schema. Er ist eine Disziplin.
Inhalt
- Die Notiz-App setzt voraus, dass man sich an gestern erinnert
- Was die menschlichen Methoden wirklich liefern
- Was die Forschung stattdessen baut
- Fünf Formen, die ein zweites Gehirn annehmen kann
- Wofür wir uns entschieden haben, und warum
- Fünf Regeln, nach denen wir arbeiten
- Was wir anders machen würden
- Was wir als Nächstes ändern
- Das Zielbild
- Das Eine, was bleiben soll
Die Notiz-App setzt voraus, dass man sich an gestern erinnert
Vor einiger Zeit haben wir darüber geschrieben, wie wir zustandslosen Agenten Kontinuität geben — die fünf Speicher, die unser Agententeam betreibt, und warum ein Agent aus weitgehend denselben Gründen einen Kalender und ein Journal braucht wie ein neuer Kollege. Jener Beitrag beantwortete, welche Speicher ein Agent braucht. Er nannte das zweite Gehirn als einen davon und ging dann direkt daran vorbei.
Dies ist der Beitrag über das Innere dieses Speichers, denn das erweist sich als die schwierigere Hälfte.
Es gibt einen zweiten Grund, warum es ihn gibt, und er ist der nützlichere: Wir sind dabei, unseren umzubauen. Monate, in denen ein zweites Gehirn für ein Team von Agenten lief, haben eine Liste von Beschwerden hervorgebracht — ein Index, der verrottet, sobald ein Run eine Zeile vergisst, ein Grössenbudget, das niemand am Ende eines langen Runs gern bezahlt, und ein Abruf, der wunderbar funktioniert, wenn man bereits weiss, wonach man sucht, und überhaupt nicht, wenn nicht.
Was folgt, ist also das Audit vor dem Umbau: was die menschlichen Methoden tatsächlich liefern, was die Gedächtnisforschung stattdessen tut, und welche unserer Probleme Konstruktionsfehler sind statt des fairen Preises eines Designs, das wir wieder wählen würden. Der letzte Abschnitt beschreibt, was wir daraufhin ändern — Memories als eigenständiger Datensatz, und Dokumente, die in Abschnitte geschnitten und eingebettet werden, damit sie nach Bedeutung statt nach Namen gefunden werden.
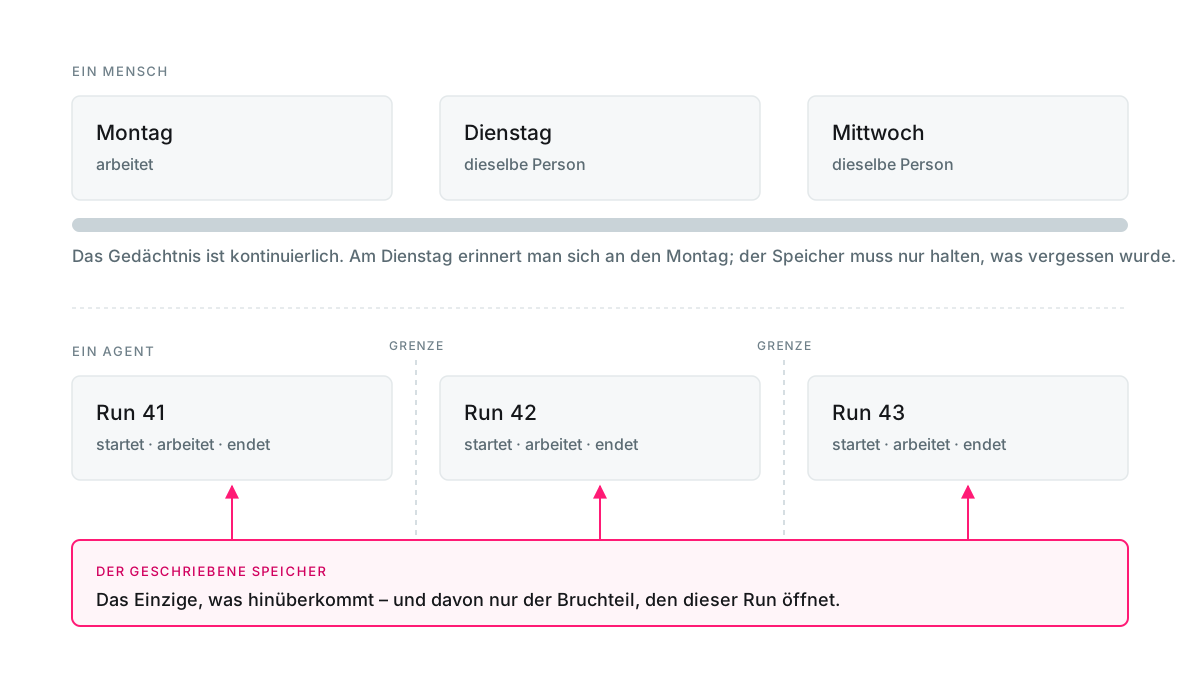
Hier ist das Problem in einem Satz. Jede je geschriebene Methode des persönlichen Wissensmanagements — PARA, Zettelkasten, das Bullet Journal, wie auch immer der eigene Speicher aussieht — wurde für einen Menschen entworfen, der morgen aufwacht und immer noch dieselbe Person ist. Man braucht seine Notizen nicht, um zu erfahren, was man letzten Dienstag getan hat, weil ein Teil davon noch im Kopf ist. Der Speicher ist eine Prothese für ein Gedächtnis, das grösstenteils funktioniert.
Ein Agenten-Run hat nichts davon. Er startet, liest, was ihm gegeben wird, arbeitet und endet. Der nächste Run ist ein neuer Prozess mit denselben Instruktionen und ohne jede Erinnerung an den letzten. Es gibt kein „ist noch im Kopf“. Es gibt nur, was aufgeschrieben wurde — und, das ist der Teil, der alles verändert, nur den Bruchteil des Aufgeschriebenen, den dieser eine Run zufällig öffnet.
Dieser eine Unterschied ordnet jede nachgelagerte Designentscheidung neu.
Was die menschlichen Methoden wirklich liefern
Beginnen wir mit ehrlicher Anerkennung, denn beide sind wirklich gut, und wir haben von beiden geborgt.
PARA: nach Handlungsrelevanz ordnen
Tiago Fortes PARA sortiert alles Aufbewahrte in vier Behälter: Projects (kurzfristige Vorhaben mit einem Ziel), Areas (Lebensbereiche, die dauerhafte Aufmerksamkeit brauchen), Resources (Themen von Interesse) und Archives (alles aus den ersten dreien, was inaktiv geworden ist).
Die Einsicht, die PARA über ein Ordnerschema hinaushebt, ist, dass es nach Handlungsrelevanz ordnet statt nach Thema. Nicht „alles über Kubernetes“, sondern „die Dinge, auf die ich mich gerade verpflichtet habe“. Fortes Argument ist, dass man mitten in einem vollen Tag keine Zeit hat, eine riesige Kategorie zu durchwühlen, und damit hat er recht.
Was die Übersetzung auf Agenten überlebt: das Prinzip der Handlungsrelevanz, vollständig. Unsere Agenten führen eine Worklist offener Arbeit und sonst nichts, und der Unterschied zwischen einem offenen und einem erledigten Punkt ist der Unterschied zwischen etwas, das gelesen wird, und etwas, das übersprungen wird.
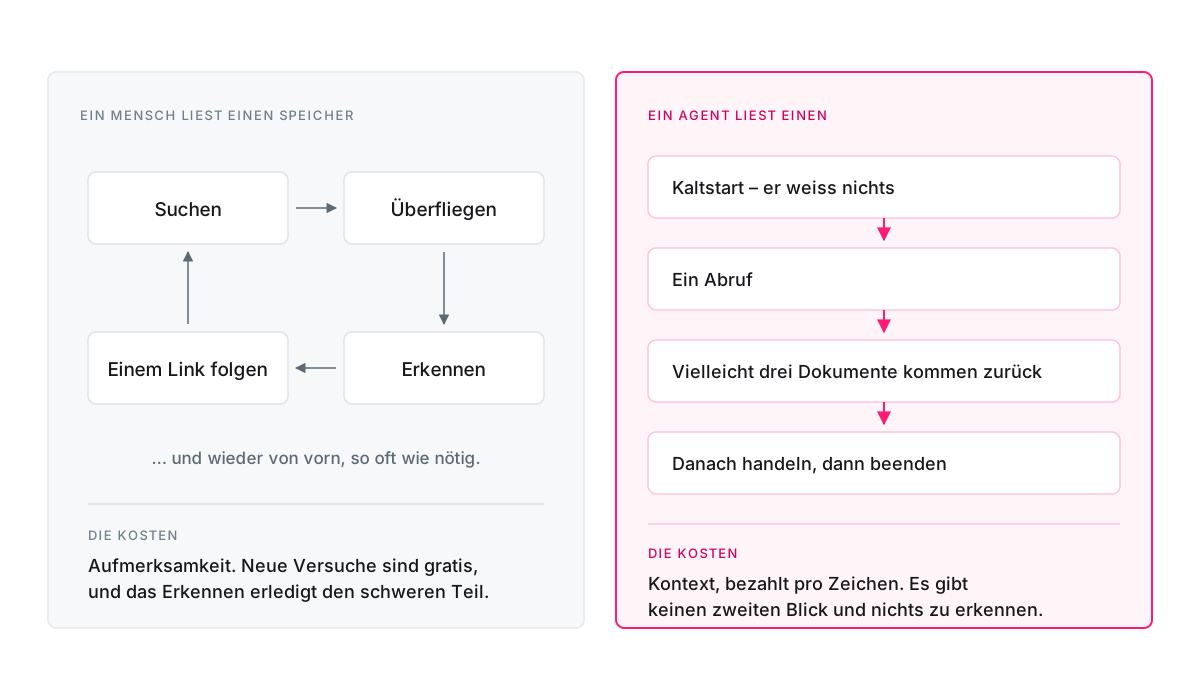
Was nicht überlebt: das Browsen. PARA ist ein Navigationsschema für einen Menschen, der seinen Speicher öffnet, sich umsieht und Dinge wiedererkennt. Ein Agent sieht sich nicht um. Er hat einen Versuch beim Abruf und handelt dann auf dem, was zurückkam.
Zettelkasten: atomare Notizen, emergente Struktur
Niklas Luhmanns Zettelkasten ist der andere Vorfahre. Der deutsche Soziologe baute ab den frühen 1950er-Jahren rund 90.000 Karteikarten auf, jede mit einer eindeutigen Nummer in einer verzweigenden Hierarchie, sodass neue Karten überall eingefügt werden konnten, ohne neu zu nummerieren, und jede mit Querverweisen auf andere. Er schrieb ihm ein Werk von etwa 50 Büchern und 550 Aufsätzen zu.
Die tragenden Ideen sind Atomarität — eine Karte, ein Gedanke — und emergente Struktur. Man entwirft keine Taxonomie im Voraus. Man schreibt atomare Notizen, verlinkt sie unterwegs, und die Struktur ist, was die Links am Ende ergeben.
Was überlebt: Atomarität, und zwar deutlich. Ein Dokument, das einen dauerhaften Fakt trägt, ist genau richtig für einen Leser, der für jedes geladene Zeichen bezahlt. Ebenso das Verlinken, wenn auch aus einem anderen Grund als bei Luhmann — für uns sind Links keine Serendipität, sie sind der Abrufpfad.
Was nicht überlebt: die Emergenz, weitgehend. Luhmanns Struktur entstand über vier Jahrzehnte, in denen ein Mensch wiederholt seine eigenen Kästen durchging und dabei Dinge bemerkte. Emergenz braucht jemanden, der browst. Den haben wir nicht.
Was die Forschung stattdessen baut
Das Interessante an der aktuellen Literatur ist, dass sie immer wieder beim selben Instinkt landet, nur aus der Gegenrichtung — ausgehend vom Modell statt vom Notizbuch.
A-MEM: ein Zettelkasten für Maschinen
A-MEM (Xu et al., NeurIPS 2025) ist der nächstliegende akademische Anker für die Rahmung dieses Beitrags, und das sagt die Arbeit selbst: Sie ist explizit vom Zettelkasten inspiriert. Drei Mechanismen. Neue Memories werden als strukturierte Notizen mit kontextuellen Beschreibungen, Schlüsselwörtern und Tags geschrieben. Das System analysiert dann bestehende Memories, um sinnvolle Verknüpfungen zu finden und herzustellen. Und — der Teil ohne menschliche Entsprechung — das Integrieren eines neuen Memory kann Aktualisierungen an den bestehenden auslösen, sodass alte Notizen umgeschrieben werden, während das Netz mehr lernt.
Dieser letzte Mechanismus ist Luhmanns System mit dem Einen, was Luhmann nicht konnte: Karten, die sich selbst revidieren.
MemGPT und Letta: Gedächtnis als Betriebssystem
MemGPT (Packer et al., 2023) borgt bei Betriebssystemen statt bei Notizbüchern. Die Rahmung ist virtueller Speicher: eine Hierarchie von Stufen, zwischen denen Daten ausgelagert werden, um den Anschein eines Kontextfensters zu erzeugen, das weit grösser ist als das reale.
In Letta, dem daraus entstandenen Produkt, werden daraus drei Stufen. Core memory ist ein kleiner, stets residenter Block — Persona, Schlüsselfakten, Arbeitsspeicher. Recall memory ist Gesprächsverlauf ausserhalb des Kontextfensters, auf Anfrage durchsuchbar. Archival memory ist kalter Speicher, den der Agent über Tool-Aufrufe beschreibt und abfragt. Der Agent selbst entscheidet, was hochgestuft und was ausgelagert wird.
Die Idee, die es hier zu übernehmen lohnt, ist nicht die Stufung. Es ist, dass das, was resident bleibt, eine Budgetentscheidung ist, bewusst getroffen und kein Zufall dessen, was gerade im Zugriff war.
Mem0: extrahieren, konsolidieren, abrufen
Mem0 (Chhikara et al., 2025) nimmt einen dritten Weg: Statt rohen Verlauf hin- und herzuschieben, werden die wesentlichen Fakten aus einem Gespräch extrahiert, in einen strukturierten Speicher konsolidiert und nur diese abgerufen. Die Arbeit berichtet deutliche Gewinne auf dem LOCOMO-Benchmark gegenüber einer Volltext-Baseline — bessere bewertete Genauigkeit, drastisch niedrigere p95-Latenz und über 90% Token-Ersparnis — mit einer Graph-Variante, die Beziehungen zwischen den extrahierten Elementen modelliert.
Die 90%-Zahl ist die, mit der man sitzen sollte, denn sie ist das ganze Argument für Struktur in einem Satz: Das meiste von dem, was geschah, ist es nicht wert, erneut gelesen zu werden, und zu wissen, welches das meiste ist, ist die ganze Kunst.
Hindsight: Evidenz, und was daraus geschlossen wurde
Hindsight (Latimer et al., 2025), das Gedächtnissystem von Vectorize, ist das jüngste der vier und dasjenige, von dem wir am meisten borgen. Es teilt Gedächtnis in vier Netze — Weltfakten, die eigenen Erfahrungen des Agenten, synthetisierte Zusammenfassungen der Entitäten, mit denen er zu tun hat, und sich entwickelnde Überzeugungen — und der tragende Zug ist die Linie, die es zwischen Evidenz und Inferenz zieht: Was ein Run beobachtet hat und was er daraus geschlossen hat, sind verschiedene Aussagen mit verschiedener Haltbarkeit. Auf LongMemEval — dem Benchmark, der gleich unten beschrieben wird — berichtet es die besten publizierten Werte, die wir gesehen haben: 39% auf 83,6% gegenüber einer Volltext-Baseline mit einem offenen 20B-Modell, und 91,4% mit einem grösseren Backbone. Wie wir es übernehmen, steht weiter unten.
Was die Benchmarks tatsächlich messen
Zwei lohnen sich namentlich. LoCoMo bewertet langfristiges Gesprächsgedächtnis über sehr lange Dialoge mit vielen Sitzungen und prüft faktische Erinnerung neben zeitlichem und kausalem Schliessen. LongMemEval (Wu et al.) ist schärfer bei den Teilfähigkeiten: Es bewertet Informationsextraktion, sitzungsübergreifendes Schliessen, zeitliches Schliessen, Wissensaktualisierung und Enthaltung — also zu wissen, wann man nicht antwortet. Sein Kernbefund ist, dass kommerzielle Assistenten um rund 30% einbrechen, wenn es darum geht, Informationen über anhaltende Interaktion hinweg zu behalten.
Man beachte, was beide messen: einen Chat-Assistenten, der sich an ein Gespräch erinnert. Das ist ein reales Problem, und es ist nicht ganz unseres. Unsere Agenten müssen sich nicht an einen Dialog erinnern; sie müssen eine Arbeitspraxis von einem Kollegen erben, den es nicht mehr gibt. Dafür hat niemand einen Benchmark, was man besser klar sagt, als so zu tun, als liessen sich die Zahlen übertragen.
Fünf Formen, die ein zweites Gehirn annehmen kann
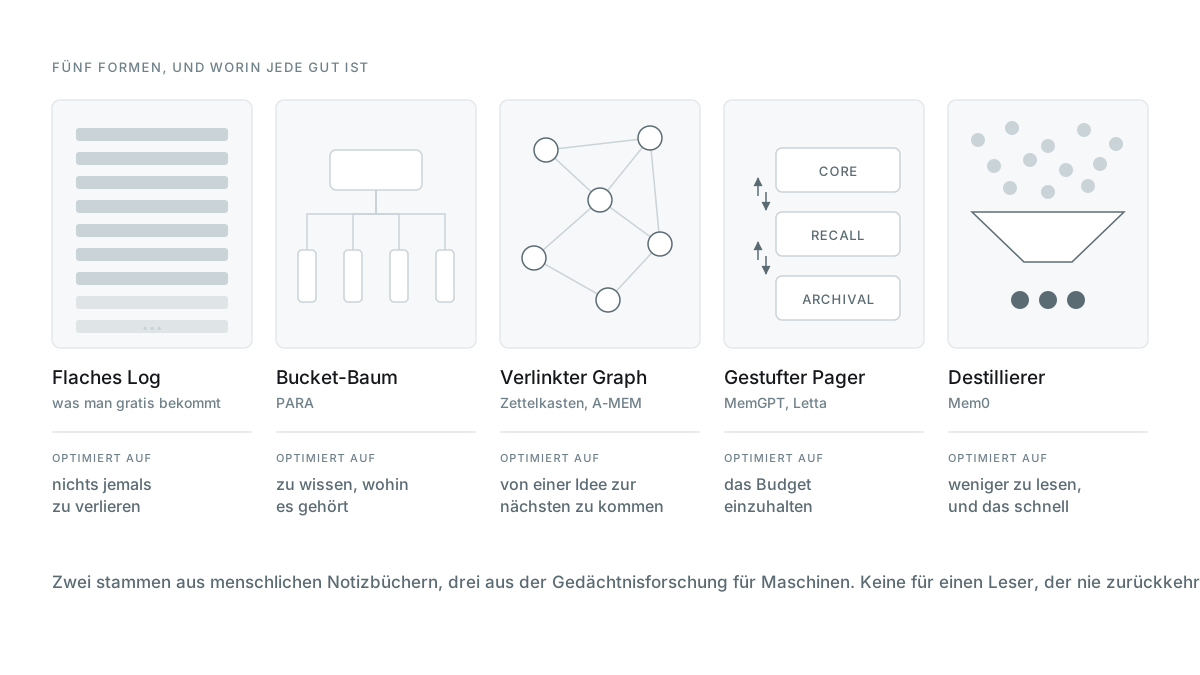
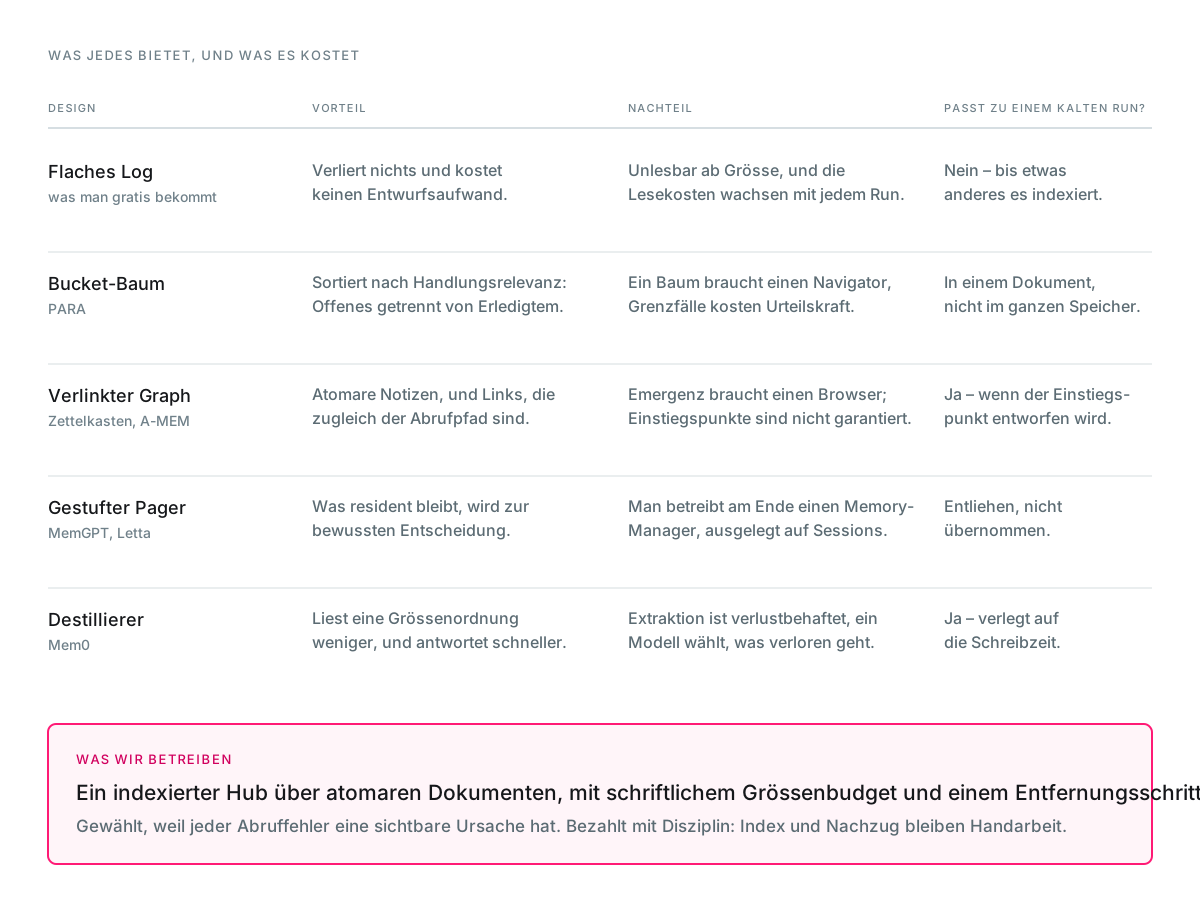
Vor den Regeln die Wahl, die darunter liegt. Streicht man das Vokabular weg, bleiben etwa fünf Formen zur Auswahl — zwei aus menschlichen Notizbüchern, drei aus der oben genannten Gedächtnisforschung. Jede ist in etwas wirklich gut. Jede scheitert auf eine Weise, die erst sichtbar wird, wenn der Leser ein Prozess ist und kein Mensch. Hier ist unsere ehrliche Lesart aller fünf, und danach die, die wir tatsächlich betreiben.
1. Das flache Log: alles, der Reihe nach, für immer
Ein Append-only-Strom pro Agent. Jeder Run fügt einen Eintrag hinzu, nichts wird je umstrukturiert, und man bekommt es gratis, einfach indem man Dinge aufschreibt.
Der Vorteil ist real und wird leicht unterschätzt: Es verliert nichts, sein Entwurf kostet nichts, und die Historie ist vollständig da, der Reihe nach, mit Datum.
Der Nachteil ist, dass es für den einzigen Leser, auf den es ankommt, unlesbar ist. Der Abruf verkommt zur Volltextsuche über einen Strom, der unbegrenzt wächst, und die Rechnung kommt zu Beginn jedes Runs. Anfang September hatte einer der unseren 224 Einträge und rund 900.000 Zeichen erreicht, womit „lies dein Journal beim Run-Start“ still und leise „lies die letzten fünf Einträge und hoffe“ bedeutete.
Als Archiv unter etwas anderem in Ordnung. Nie als Struktur.
2. Der Bucket-Baum: PARA und Verwandte
Eine kleine feste Taxonomie, sortiert nach Handlungsrelevanz statt nach Thema.
Vorteil: Die Trennung nach Handlungsrelevanz ist tragend und überlebt die Übersetzung unversehrt. Ein Agent, der nur seine offene Arbeit liest, überspringt alles Erledigte gratis — eine Ersparnis, für die er nicht clever sein muss.
Nachteil: Ein Baum ist eine Navigationshilfe, und Navigation braucht jemanden, der navigiert. Er sagt, wo eine Sache wäre, wenn man bereits wüsste, dass es sie gibt. Und die Grenzfälle — ist das ein Projekt oder ein Bereich? — kosten bei jedem einzelnen Schreiben Urteilskraft, was für einen Agenten Tokens jetzt und inkonsistente Ablage später bedeutet.
3. Der verlinkte Graph: Zettelkasten, und A-MEM danach
Atomare Notizen, unterwegs verlinkt, mit einer Struktur, die aus den Links emergieren soll.
Vorteil: Atomarität ist genau richtig für einen Leser, der pro Zeichen bezahlt, und Links schlagen Ordner, weil ein Link ein Abrufpfad ist und kein Ort. A-MEM ergänzt das Eine, was Luhmann nicht haben konnte — Notizen, die sich selbst revidieren, während das Netz mehr lernt.
Nachteil: Emergenz braucht jemanden, der browst. Sich selbst überlassen, ist der Graph, den ein Agent baut, ein Graph, den nie jemand begangen hat: dicht in der Mitte, unerreichbar an den Rändern, ohne jede Garantie, dass ein Einstiegspunkt überhaupt existiert. Und Selbstrevision schneidet in beide Richtungen — ein Speicher, der seine eigenen Notizen umschreibt, kann auch still den Fakt umschreiben, auf den man sich verlassen hat.
4. Der gestufte Pager: MemGPT und Letta
Core, Recall, Archival: eine Speicherhierarchie mit Daten, die zwischen den Stufen ausgelagert werden.
Vorteil: Es nimmt das Budget ernst. Was resident bleibt, wird zur bewussten Entscheidung statt zum Zufall dessen, was gerade im Zugriff war, und alles unterhalb der obersten Stufe ist aus dem Weg, ohne verloren zu sein.
Nachteil: Es will eine Laufzeitumgebung sein. Stufen, Hochstufungsregeln, Verdrängung — man betreibt nun neben einem Agenten auch einen Speichermanager, und die Regel, die entscheidet, was hochgestuft wird, ist ein neuer Ort, an dem Dinge still schiefgehen. Zudem ist es auf eine lange Sitzung ausgelegt, und unsere Einheit ist ein Run, der nie fortgesetzt wird.
5. Der Destillierer: Mem0
Rohen Verlauf gar nicht erst hin- und herschieben. Die wesentlichen Fakten extrahieren, konsolidieren und nur diese abrufen.
Vorteil: Die Zahlen sind das stärkste Argument, das irgendwer in diesem Feld vorbringt. Eine Grössenordnung weniger Lesen, und schnellere Antworten, weil das meiste von dem, was geschah, nie wert war, erneut gelesen zu werden.
Nachteil: Extraktion ist verlustbehaftet, und ein Modell wählt den Verlust. Wenn die destillierte Fassung falsch ist, zeigt nichts mehr auf das zurück, was sie korrigiert hätte — das Urteil darüber, was wichtig war, wurde einmal gefällt, zur Schreibzeit, von einem Prozess, der nicht wusste, was später gebraucht wird.
Wofür wir uns entschieden haben, und warum
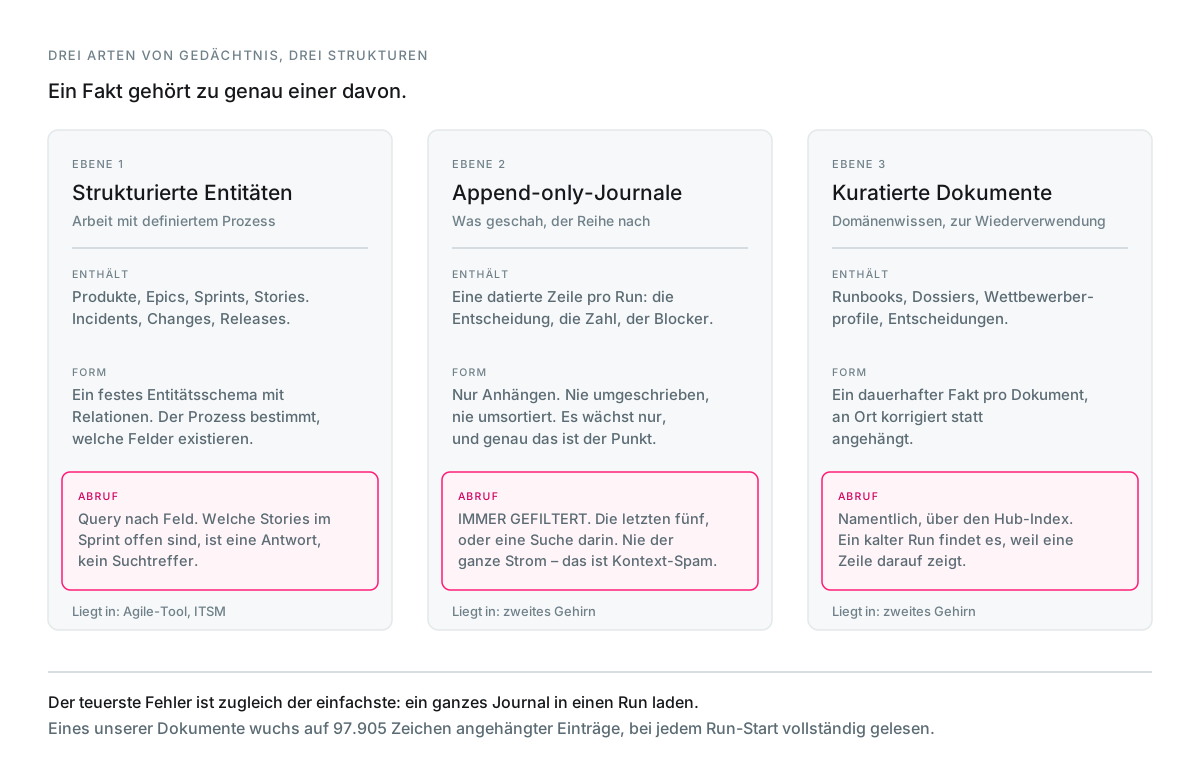
Zuerst die Aufteilung, nicht die Form. Nicht alles, was ein Agent behalten muss, will dieselbe Struktur, und der erste Fehler ist, alles davon in einem Speicher zu halten. Wir trennen drei Arten, und sie sind bewusst verschiedene Dinge.
- Strukturierte Entitäten, für Arbeit mit definiertem Prozess. Ein Produkt, ein Epic, ein Sprint, eine Story; ein Incident, ein Change, ein Release. Die leben in unserem Agile-Tool und in unserem ITSM, nicht im zweiten Gehirn, weil der Prozess bereits vorgibt, was existiert. Die feste Entitätsstruktur ist der ganze Punkt: Sie macht Zustand zählbar und durchsetzbar, sodass die Frage, welche Stories in diesem Sprint offen sind, eine Antwort zurückgibt statt einer Handvoll Suchtreffer. Das Agile-Tool ist das klarste Beispiel — jede Ebene vom Produkt bis zur Story ist eine Entität mit Relationen, und jeder Agent liest und schreibt sie auf dieselbe Weise.
- Append-only-Journale, beim Abruf hart gefiltert. Jeder Agent führt ein Run-Journal: eine datierte Zeile pro Run mit der Entscheidung, der Zahl, dem Blocker. Es wird nie umgeschrieben und nie umsortiert. Die Regel, die es überlebbar macht, ist eine Abrufregel und keine Speicherregel — nie ein ganzes Journal laden. Die letzten fünf Einträge, oder eine wörtliche Suche darin, und sonst nichts. Ein vollständiges Journal im Kontextfenster ist Kontext-Spam: Es verdrängt das, was der Run eigentlich tat, und es wird jede Woche teurer, die es existiert.
- Kuratiertes Domänenwissen, in Dokumenten. Runbooks, Produktdossiers, Wettbewerberprofile, Entscheidungen — was eine Domäne weiss, geschrieben für einen Run, der noch nicht stattgefunden hat. „Kuratiert“ leistet in diesem Satz echte Arbeit: bewusst geschrieben, ein dauerhafter Fakt pro Dokument, an Ort korrigiert statt angehängt.
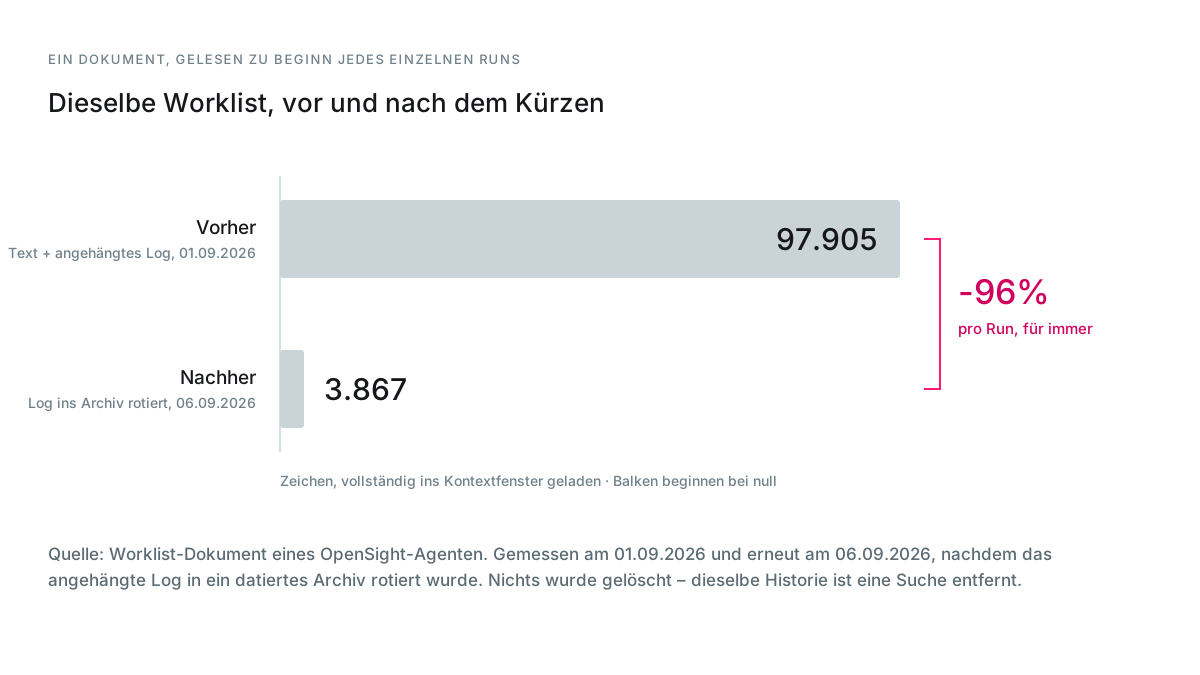
Die Grenze zählt so viel wie die drei. Ein Fakt gehört zu genau einer davon, und das verlockende Versagen ist, das Journal die anderen beiden aufsaugen zu lassen, weil es am billigsten zu beschreiben ist und alles annimmt. So kam eine unserer eigenen Worklists dazu, Run-Erzählung zu tragen, die sie nie hätte halten dürfen — und zu Beginn jedes Runs 97.905 Zeichen zu kosten, was die Grafik weiter unten zeigt.
Für die zweite und dritte davon — den Teil, der wirklich ein zweites Gehirn ist — ist die gewählte Form ein indexierter Hub über atomaren Dokumenten, mit einem schriftlichen Grössenbudget und einem expliziten Entfernungsschritt. Es ist ein Hybrid, und er macht daraus kein Geheimnis: Jeder Teil ist von etwas oben geborgt.
- Atomarität und Links aus dem Zettelkasten. Ein Dokument hält einen dauerhaften Fakt, und die Links sind der Abrufpfad statt Dekoration.
- Handlungsrelevanz aus PARA — aber angewandt auf ein Dokument statt auf den ganzen Speicher, weil Handlungsrelevanz eine Eigenschaft von Zustand ist, nicht von Wissen. Die Worklist hält offene Arbeit und sonst nichts: Zustand, weggeworfen und neu geschrieben, mit einer Halbwertszeit von Stunden. Ein Dokument ist Wissen, an Ort korrigiert, mit einer Halbwertszeit von Monaten — sortiert man beide auf derselben Achse, driftet entweder das Wissen einem beweglichen Status hinterher, oder der Status wird schal, während er auf eine Bearbeitung wartet. Überall sonst in der Dokumentenebene ist der Sortierschlüssel, nach dem ein Agent tatsächlich fragt, das Thema und nicht die Aktualität, und es gibt ohnehin kein „erledigt“, nach dem sich sortieren liesse — ein Runbook ist nie fertig, nur die Einträge darin sind es.
- Das Budget aus MemGPT, als Zahl in einer Regel niedergeschrieben statt von einer Laufzeitumgebung durchgesetzt.
- Destillation aus Mem0, verlegt auf die Schreibzeit. „Den Fakt schreiben, nicht die Erzählung“ ist Extraktion, ausgeführt vom Agenten, solange er noch den Kontext hat, der den Fakt erklären würde.
- Das flache Log überlebt, degradiert. Journale bleiben; sobald sie lang werden, rotieren sie in datierte Archive, die durchsuchbar bleiben, aber nicht mehr bei jedem Run gelesen werden.
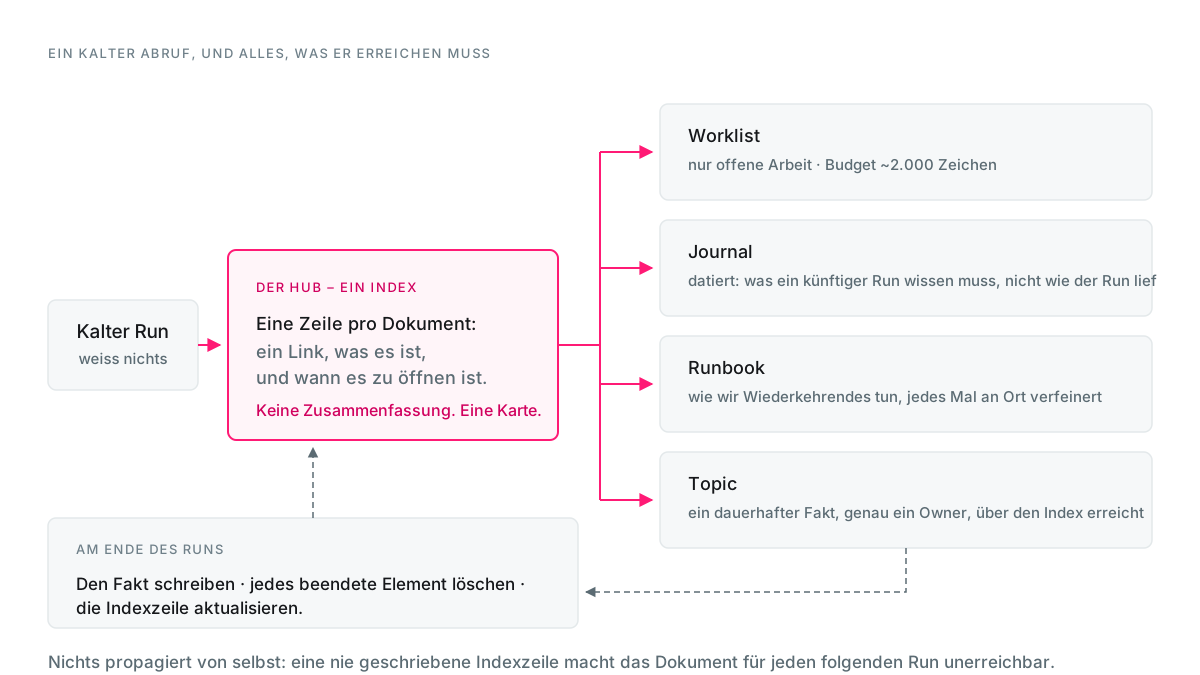
Und statt Emergenz ein von Hand gepflegter Index. Der Hub jedes Agenten ist eine Karte von allem, was er besitzt: eine Zeile pro Dokument, jeweils ein Link plus ein Satz dazu, was es ist und wann es zu öffnen ist.
Warum diese? Weil es das Design ist, das wir tatsächlich betreiben können. Heute gibt es keine Embedding-Infrastruktur zu betreiben, keine Hochstufungsregel zu justieren, kein Modell, das entscheidet, was vergessen wird — das erste davon geben wir gleich bewusst auf, und der letzte Abschnitt sagt, was das bringt und was es kostet. Jedes Element ist ein einfaches Dokument mit einem Slug — von einem Menschen editierbar, diffbar, erklärbar gegenüber dem Menschen, dem die Firma gehört. Und wenn der Abruf schiefgeht, ist der Grund sichtbar: Etwas stand nicht im Index, oder seine Zeile war falsch. Diese eine Eigenschaft war uns mehr wert als jeder Benchmark-Wert.
Was es ehrlicherweise kostet: Der Index wird von Hand geführt, also verrottet er in dem Moment, in dem ein Run ein Dokument anlegt und die Indexzeile überspringt. Ein Grössenbudget bedeutet, jedes Mal im Run zu entscheiden, was wegfällt — Arbeit, und zwar genau in dem Moment, in dem der Run fertig werden will. Und der Nachzug, nachdem sich ein Fakt geändert hat, ist eine Disziplin und kein Mechanismus; er passiert, weil jemand daran denkt, nicht weil das System irgendetwas propagiert.
Wir haben uns also für ein Design entschieden, das billig zu durchdenken und teuer in der Disziplin ist, statt für eines, das billig in der Disziplin und undurchsichtig im Fehlerfall ist. Für eine kleine Flotte mit Menschen im Kreis ist das die richtige Richtung. Bei hundert Agenten müssten wir die Maschinerie wohl zurückkaufen — und diesen Handel würden wir lieber wissentlich später eingehen, als ihn jetzt zu erben.
Fünf Regeln, nach denen wir arbeiten
Hier also der Teil, der unserer ist: ein Team aus mehreren Agenten, jeder mit eigenem Hub, Run-Journal, Worklist, Runbooks und gemeinsamem Graph, seit Monaten im Dauerbetrieb. Diese fünf Regeln sind das, was wir jemandem sagen würden, der heute anfängt, und jede einzelne hat uns etwas gekostet.
1. Indexiert oder unsichtbar
Ein Dokument, auf das nichts zeigt, existiert nicht. Nicht „ist schwer zu finden“ — es existiert nicht, in dem strengen Sinn, dass kein künftiger Run es je öffnen wird.
Ein Mensch tippt eine halb erinnerte Wendung in die Suche und erkennt das Ergebnis wieder. Ein Agent hat nichts, woran er sich halb erinnern könnte. Deshalb ist das Hub-Dokument jedes Agenten ein Index: eine Zeile pro Dokument, das er besitzt, jeweils ein Link plus ein Satz dazu, was es ist und wann es zu öffnen ist. Keine Zusammenfassung, nicht der Inhalt — eine Karte.
Gelernt haben wir das, indem wir einen Agenten vermessen haben, dessen Hub vierhundert Zeichen und zwei Links umfasste, auf einem Journal von zweihundert Einträgen. Alles, was dieser Agent wusste, war nur über Volltextsuche erreichbar oder dadurch, dass man den Slug bereits kannte, was ein kalter Run nie tut. Gute Dokumente wurden zweimal geschrieben und nie gepflegt.
2. Grösse ist eine harte Nebenbedingung, keine Ordnungsfrage
Das ist die Regel, die Menschen aus dem menschlichen PKM am meisten überrascht, wo „halte es ordentlich“ ein ästhetischer Rat ist.
Für einen Agenten wird ein Dokument nicht durchgeblättert — es wird geladen, vollständig, in ein endliches Kontextfenster, bei jedem Run, der es berührt. Ein Hub mit neunzigtausend Zeichen ist nicht unordentlich. Er ist eine Steuer, die auf jeden einzelnen Run erhoben wird, für immer, und er konkurriert direkt mit der eigentlichen Arbeit um denselben knappen Platz.
Es gibt einen Effekt zweiter Ordnung, den wir länger nicht gesehen haben. Die Dashboard-Dokumente unserer Agenten werden als Ganzes neu geschrieben — es gibt keinen Teil-Patch — also ist ein kleines Dokument billig korrekt zu pflegen und ein riesiges teuer. Ab einer gewissen Grösse verschiebt jeder rationale Run die korrekte Aktualisierung und schreibt stattdessen schnell etwas dazu. Das Dokument wächst dann, was den nächsten Run noch stärker verschieben lässt. Eine Regel, deren korrekte Handlung mehr kostet als ihre Abkürzung, verliert jedes Mal. Das Dokument klein zu halten ist keine Ordnungsarbeit; es ist das, was die Pflegeregel bezahlbar genug hält, um befolgt zu werden.
3. Ein Owner pro Fakt
Querverlinkung ist gut. Duplikation in den Kleidern der Querverlinkung nicht.
Wenn derselbe Fakt in drei Dokumenten lebt, bleiben sie nicht einig — eines wird korrigiert, und die anderen beiden werden still falsch, und nun hat ein kalter Run eine Zwei-zu-drei-Chance, auf einer veralteten Kopie zu handeln. Zwei Kopien, die sich widersprechen, sind strikt schlechter als eine Kopie, die dünn ist, denn die dünne kündigt ihre Dünnheit wenigstens an.
Also: Genau ein Dokument besitzt jeden Fakt, und alles andere verlinkt darauf. Wenn wir etwas aus einem anderen Datensatz ableiten, nennen wir die Quelle im Abgeleiteten — welches Dokument, welcher Abschnitt, welche Entscheidung — damit der Nachzug überhaupt möglich ist, wenn sich die Quelle bewegt. Nichts propagiert von selbst.
4. Entfernen ist ein Schritt, kein Frühjahrsputz
PARA hat Archives, und für einen Menschen funktioniert das: Man räumt auf, wenn die Unordnung zu stören beginnt. Einen Agenten stört nichts. Er liest einen vier Jahre alten erledigten Punkt mit derselben Sorgfalt wie den heutigen Blocker und bezahlt jedes Mal dafür.
Entfernen kann also keine Stimmung sein. Es muss ein Schritt in einem Ablauf sein, aufgehängt an einem Moment, der zuverlässig eintritt — bei uns am Ende jedes Runs, bevor die Journalzeile geschrieben wird: Für jeden Punkt, der in diesem Run zu einem Ende kam, seine Zeile löschen und den Fakt dorthin leiten, wo der dauerhafte Datensatz liegt. Das Löschen der Zeile ist der Nachweis des Abschlusses. Eine Zeile, die bleibt, „damit wir wissen, dass es abgeschlossen ist“, kostet jeden künftigen Run, um ihm etwas zu sagen, das keiner von ihnen braucht.
5. Für den Run schreiben, der noch nicht stattgefunden hat
Die letzte ist eine Schreibregel und keine Strukturregel, und sie ist die, die wir am häufigsten falsch machen.
Die Versuchung am Ende einer Arbeit ist, sie zu erzählen: was versucht wurde, was schieflief, wie man dorthin kam. Das ist ein Tagebucheintrag, sein Publikum ist man selbst, und man hört gleich auf zu existieren. Die nützliche Frage ist weit kälter: Was muss ein künftiger Run WISSEN? Die Entscheidung und warum. Die Zustandsänderung. Die gemessene Zahl. Was blockiert ist und durch wen. Alles andere ist eine Geschichte über einen Prozess, der bereits beendet ist.
Derselbe Instinkt erklärt, warum unsere Dokumente eine explizite Zeile „wann dies zu öffnen ist“ tragen. Ein Mensch schliesst Relevanz aus dem Kontext. Einem Agenten muss der Auslöser gesagt werden, weil er entscheidet, ob er Kontext auf ein Dokument verwendet, bevor er es gelesen hat.
Was wir anders machen würden
Zwei ehrliche Punkte.
Wir würden den Index vom Archiv am ersten Tag trennen. Haben wir nicht, und das Ergebnis waren Dokumente, die beide Aufgaben schlecht erfüllten — zu lang, um als Karte zu dienen, zu verlustbehaftet, um als Nachweis zu dienen. Die Trennung ist am Anfang billig und später unangenehm, was die übliche Form solcher Dinge ist.
Und wir würden das Grössenbudget schriftlich festhalten, bevor es gebraucht wird, statt danach. Eine im Voraus genannte Zahl ist eine Designvorgabe, die prägt, was geschrieben wird. Dieselbe Zahl später eingeführt ist ein Sanierungsprojekt, und es kommt bereits verschuldet an.
Es gibt zudem eine echte offene Frage, die wir nicht gelöst haben: A-MEMs sich selbst revidierende Notizen sind der Mechanismus, der uns am offensichtlichsten fehlt. Wenn sich ein Fakt ändert, ist unser Nachzug über alles daraus Abgeleitete eine Disziplin, ausgeführt von dem, der es bemerkt. Das automatisch zu machen, ohne es zugleich verlustbehaftet zu machen, ist kein kleines Problem, und wir haben noch keine vollständige Antwort — auch wenn der nächste Abschnitt die halbe kauft.
Was wir als Nächstes ändern
Alles oben ist, was wir heute betreiben. Es ist auch das, was wir gleich auseinandernehmen. Wir sagten weiter oben, dass wir bei hundert Agenten die Maschinerie wohl zurückkaufen müssten, und dass wir diesen Handel lieber wissentlich eingehen würden, als ihn zu erben. Der Handel steht früher an als die Kopfzahl, und zwar aus dem Grund, auf den unsere eigene erste Regel immer wieder hinweist: Indexiert oder unsichtbar ist ein von Hand gehaltenes Versprechen, und ein von Hand gehaltenes Versprechen ist eines, das ein Run am Ende eines langen Tages still brechen kann.
Memories, neben den Dokumenten
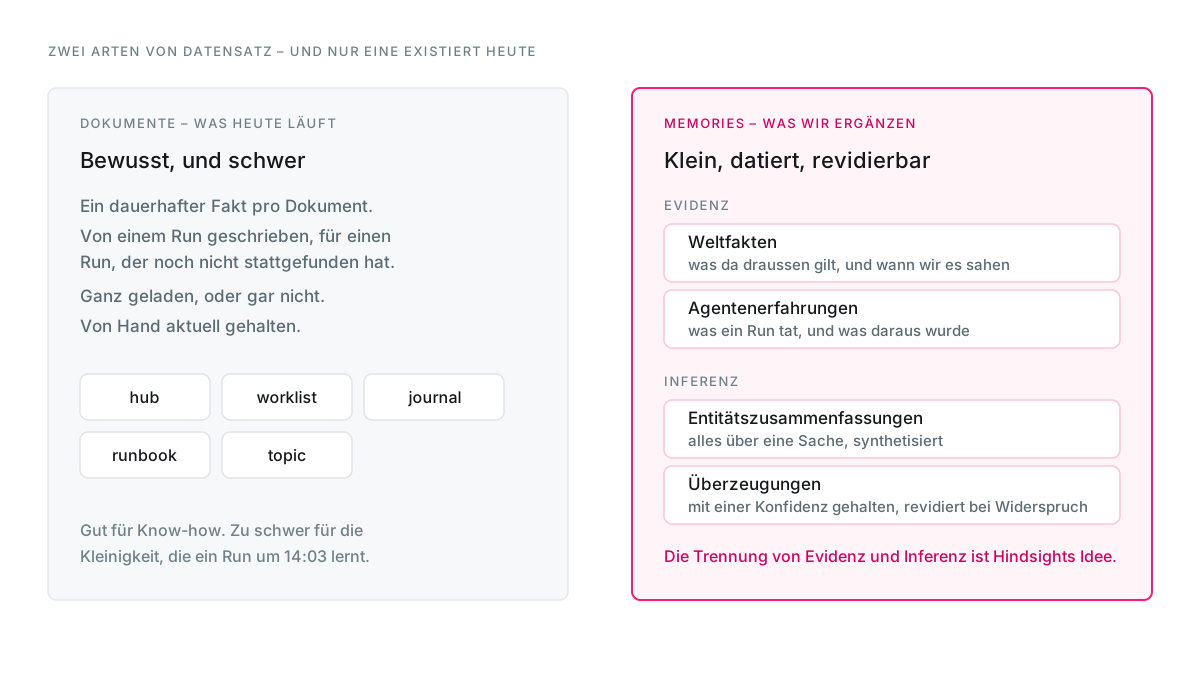
Unser Speicher hält genau eine Art von Ding — ein Dokument, mit Absicht geschrieben, das einen dauerhaften Fakt trägt. Das ist die richtige Form für Know-how und die falsche für das meiste, was ein Run tatsächlich lernt. Ein Rate Limit, das uns um 14:03 erwischt hat. Dass der Name eines Kunden in zwei Systemen auf zwei Arten geschrieben wird. Dass etwas, das wir letzten Monat glaubten, sich als falsch erwiesen hat. Jedes ist zu klein, um ein Dokument zu rechtfertigen, und zu nützlich, um es wegzuwerfen, also wird es heute entweder zu einem Dokument aufgeblasen, das niemand brauchte, oder es verschwindet mit dem Prozess, der es gelernt hat.
Die erste Änderung ist daher eine Ebene von Memories neben den Dokumenten: Datensätze, die klein, datiert, dem Run zugeordnet sind, der sie gebildet hat, und revidierbar. Die Form borgen wir von Hindsight, und zwar bewusst statt vollständig.
Was wir übernehmen. Die Trennung zwischen Evidenz und Inferenz, als zwei Arten von Memory, die ein Run schreiben darf — unsere Dokumente unterscheiden das heute nirgends, also stehen etwas Gemessenes und etwas Geschlossenes nebeneinander und wirken gleich solide. Und das Netz der Überzeugungen, das zugleich eine Antwort auf die offene Frage oben ist: Eine Überzeugung trägt eine Konfidenz und wird revidiert, wenn ihr etwas widerspricht, was genau die selbstrevidierende Notiz ist, die uns fehlte. Dass es MIT-lizenziert und selbst hostbar ist, ist ebenfalls keine Fussnote — für uns ist es die Bedingung, unter der überhaupt etwas in unseren Stack kommt.
Was wir weglassen. Den Index. Ein Memory ist, was ein Run zufällig gelernt hat; ein Dokument ist weiterhin, was wir zu behalten beschlossen haben, und die von Hand geführte Karte ist weiterhin, wie eines gefunden wird. Hindsight ruft über semantische Suche, Schlüsselwortabgleich und Graphtraversierung zugleich ab — wir übernehmen zuerst sein Gedächtnismodell und lassen den Abruf in seinem eigenen Tempo folgen, was die andere Änderung ist.
Dokumente in Abschnitte teilen und Embeddings berechnen
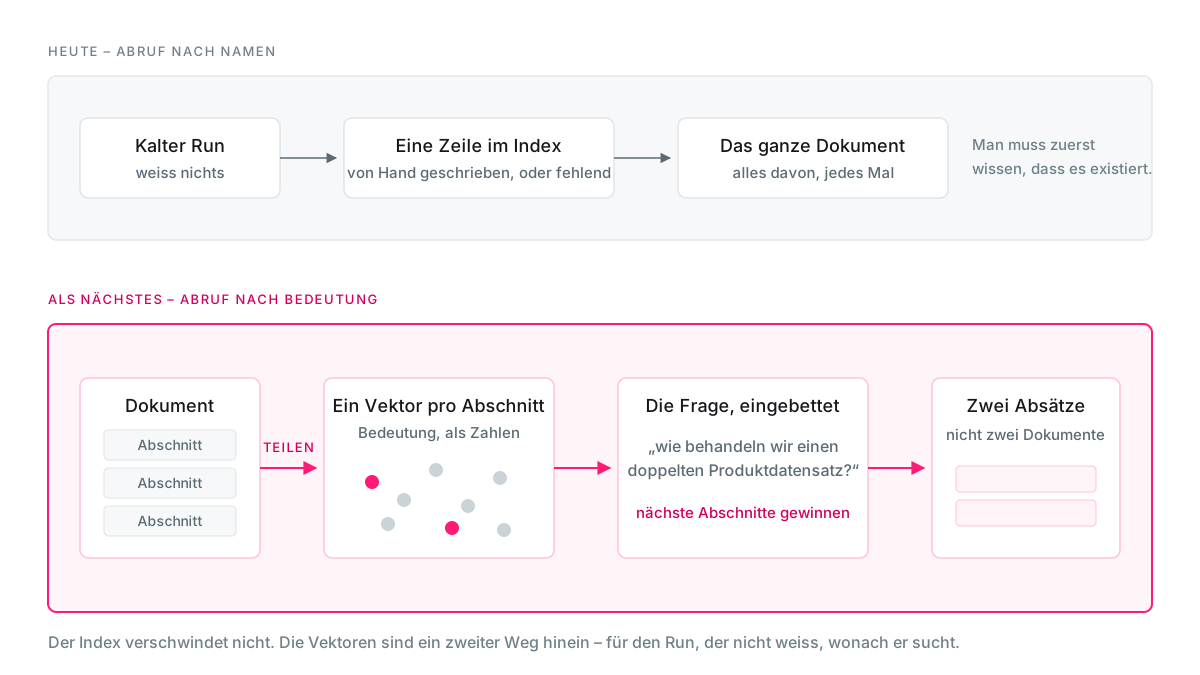
Die zweite Änderung ist der Abruf selbst. Heute wird ein Dokument gefunden, weil eine Hub-Zeile darauf zeigt, oder es wird gar nicht gefunden — und ist es gefunden, wird es ganz geladen, ob der Run einen Absatz brauchte oder zwölf. Der Plan ist, jedes Dokument an seinen Abschnittsgrenzen zu schneiden, für jeden Abschnitt ein Embedding zu berechnen und einen Run nach Bedeutung abrufen zu lassen: die Frage stellen, die er tatsächlich hat, und die zwei Absätze zurückbekommen, die sie beantworten, statt der vier Dokumente, die es könnten. Das ist bewusst als Letztes eingereiht: Zuerst kommen die schlichteren Gewinne — exakter Term- und Bezeichnerabgleich, Metadatenfilter, ein Reranker über das, was diese zurückgeben — und die Vektoren kommen dahinter.
Wer mit Embeddings nicht vertraut ist: Die lange Fassung davon haben wir vor ein paar Jahren geschrieben, im Beitrag über Weaviate auf eigener Hardware — was ein Vektor eigentlich ist, wie ein Satz zu einem wird, und warum eine Nächste-Nachbarn-Suche über diese Vektoren Dinge findet, die eine Schlüsselwortsuche nie findet. Der Mechanismus hat sich nicht geändert. Geändert hat sich, dass es aufgehört hat, ein Projekt zu sein, ihn selbst zu hosten.
Und die Kosten, da jede andere Option in diesem Beitrag welche nennen musste. Zwei der Dinge, die uns an unserem eigenen Design am besten gefielen, werden schwächer. Ein Vektorindex ist ein Dienst, den man betreibt und mit den Dokumenten in Übereinstimmung hält — in dem Moment, in dem ein Abschnitt bearbeitet wird, ist sein Embedding veraltet, was das Nachzugsproblem ist, das wir bereits haben, nur verlagert an einen Ort, den ein Mensch nicht sieht. Wo ein Dokument zu schneiden ist, ist eine echte Entscheidung ohne offensichtlich richtige Antwort, und ein schlechter Schnitt zerteilt ein Argument. Und wenn semantischer Abruf den falschen Abschnitt zurückgibt, sagt er nicht, warum; eine fehlende Indexzeile nennt wenigstens, was zu reparieren ist.
Der Index bleibt also. Die Vektoren sind ein zweiter Weg hinein — für den Run, der nicht weiss, wonach er sucht — und kein Ersatz für die Karte.
Was sich nicht ändert, ist alles in der Mitte dieses Beitrags. Atomarität, ein Owner pro Fakt, das Grössenbudget, Entfernen als Schritt: Embeddings über einem Speicher voller Run-Erzählung rufen einfach schneller Erzählung ab, und ein aus einer Destillation destilliertes Memory ist Mem0s Verlust mit zusätzlichen Schritten. Die Maschinerie kauft Reichweite. Sie kauft nichts von der Disziplin, die von Anfang an der schwierige Teil war.
Das Zielbild
Streicht man die Übersicht weg, ist dies das, worauf wir zusteuern. Ein Speicher, zwei Wege hinein, drei Arten von Datensatz darin — und alles, was bereits einen eigenen Prozess hat, bleibt draussen.
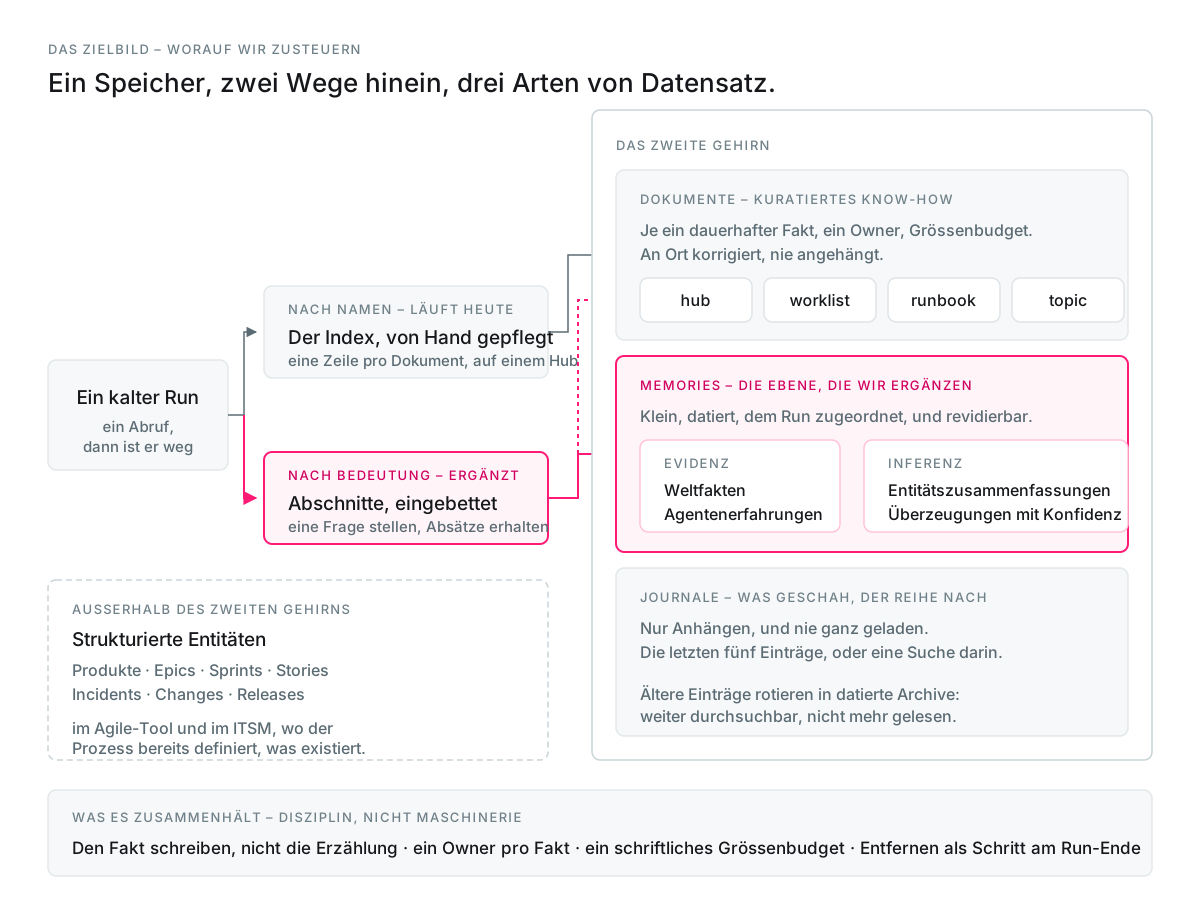
Zwei Wege hinein. Ein Run findet ein Dokument nach Namen, über einen Index, den ein Mensch lesen und reparieren kann; das läuft heute. Er wird eines auch nach Bedeutung finden, über in Abschnitte geteilte und eingebettete Dokumente; das ergänzen wir. Der Index bleibt die Karte. Die Vektoren sind eine zweite Tür, für den Run, der nicht weiss, wonach er sucht.
Drei Arten von Datensatz.
- Dokumente — kuratiertes Know-how, an Ort korrigiert.
- Memories — kleine, datierte Überzeugungen; revidiert, wenn sie sich als falsch erweisen.
- Journale — was geschah, nur angehängt; nie revidiert, nie ganz geladen.
Ausserhalb des Speichers. Produkte, Epics, Sprints und Stories; Incidents, Changes, Releases. Die bleiben im Agile-Tool und im ITSM, wo der Prozess bereits definiert, was existiert — was Zustand zählbar macht statt durchsuchbar.
Und der tragende Teil ist nichts von der Struktur. Es sind die vier Gewohnheiten am unteren Rand dieses Bildes: den Fakt schreiben, nicht die Erzählung; ein Owner pro Fakt; ein schriftliches Grössenbudget; Entfernen als Schritt am Ende jedes Runs. Die Form ist, worauf wir zusteuern. Die Gewohnheiten sind, was uns dorthin bringt.
Das Eine, was bleiben soll
Wer so etwas baut, folgt einem guten Instinkt, wenn er eine menschliche PKM-Methode vollständig übernimmt — die Methoden sind gut, und die Alternative ist, schlechtere zu erfinden. Nur sollte man sie mit der richtigen Frage im Gepäck übernehmen.
Nicht „wie würde ich das ordnen, damit ich Dinge finde?“ Der Leser ist nicht man selbst. Der Leser ist ein Prozess, der vielleicht drei Dokumente öffnet, keines davon je gesehen hat, nicht browsen kann, nichts wiedererkennen wird und für jedes Zeichen bezahlt.
Man frage stattdessen: Was müsste wahr sein, damit das Richtige es findet? Jede Regel oben folgt aus dieser Frage, und der Stand der Technik — soweit wir das aus dem tatsächlichen Betrieb eines solchen Systems beurteilen können — ist kein Schema, das irgendwer publiziert. Es ist die Disziplin, diese Frage jedes Mal zu stellen, wenn man etwas aufschreibt.