Kubernetes Monitoring: Ein Leitfaden Schicht für Schicht
Was man in Kubernetes überwachen sollte, von Control Plane und etcd bis zu den Workloads, dazu eBPF-Tracing mit einem DaemonSet, Collection-Muster und Alerting, das funktioniert.

Dieser Artikel ist auch auf Englisch verfügbar: Kubernetes Monitoring: A Layer-by-Layer Guide.
Mit diesem Artikel wollte ich einen kompakten Überblick geben, welche Komponenten man bei Kubernetes Observability berücksichtigen sollte: von der Hardware bis zu den Workloads, und wie man das alles einsammelt.
— Roman Hüsler, OpenSight
Dieser Leitfaden behandelt Kubernetes Monitoring Schicht für Schicht: was man auf jeder Ebene des Clusters beobachten sollte, wie man es mit OpenTelemetry und eBPF einsammelt und worauf man alarmieren sollte.
Inhalt
- Warum Kubernetes Monitoring anders ist
- Teil 1: Was überwachen
- Teil 2: Wie einsammeln
- Teil 3: Alarmieren, planen und handeln
- Quellen und weitere Literatur
Warum Kubernetes Monitoring anders ist
Kubernetes nimmt einem viel Komplexität ab, damit Teams schneller liefern können. Der Preis ist die Sichtbarkeit: Man verliert leicht den Überblick darüber, was läuft, was es verbraucht und was die Plattform im eigenen Namen getan hat. Eine klassische Infrastruktur hat zwei Dinge zu beobachten, Hosts und Applikationen. Kubernetes bringt einen Scheduler dazu, einen replizierten State Store, eine API, über die jede Komponente spricht, eine Container Runtime, ein Overlay-Netzwerk und Cluster-DNS. Wenn etwas ausfällt, kann die Ursache in jedem davon liegen, und das Symptom zeigt selten darauf.
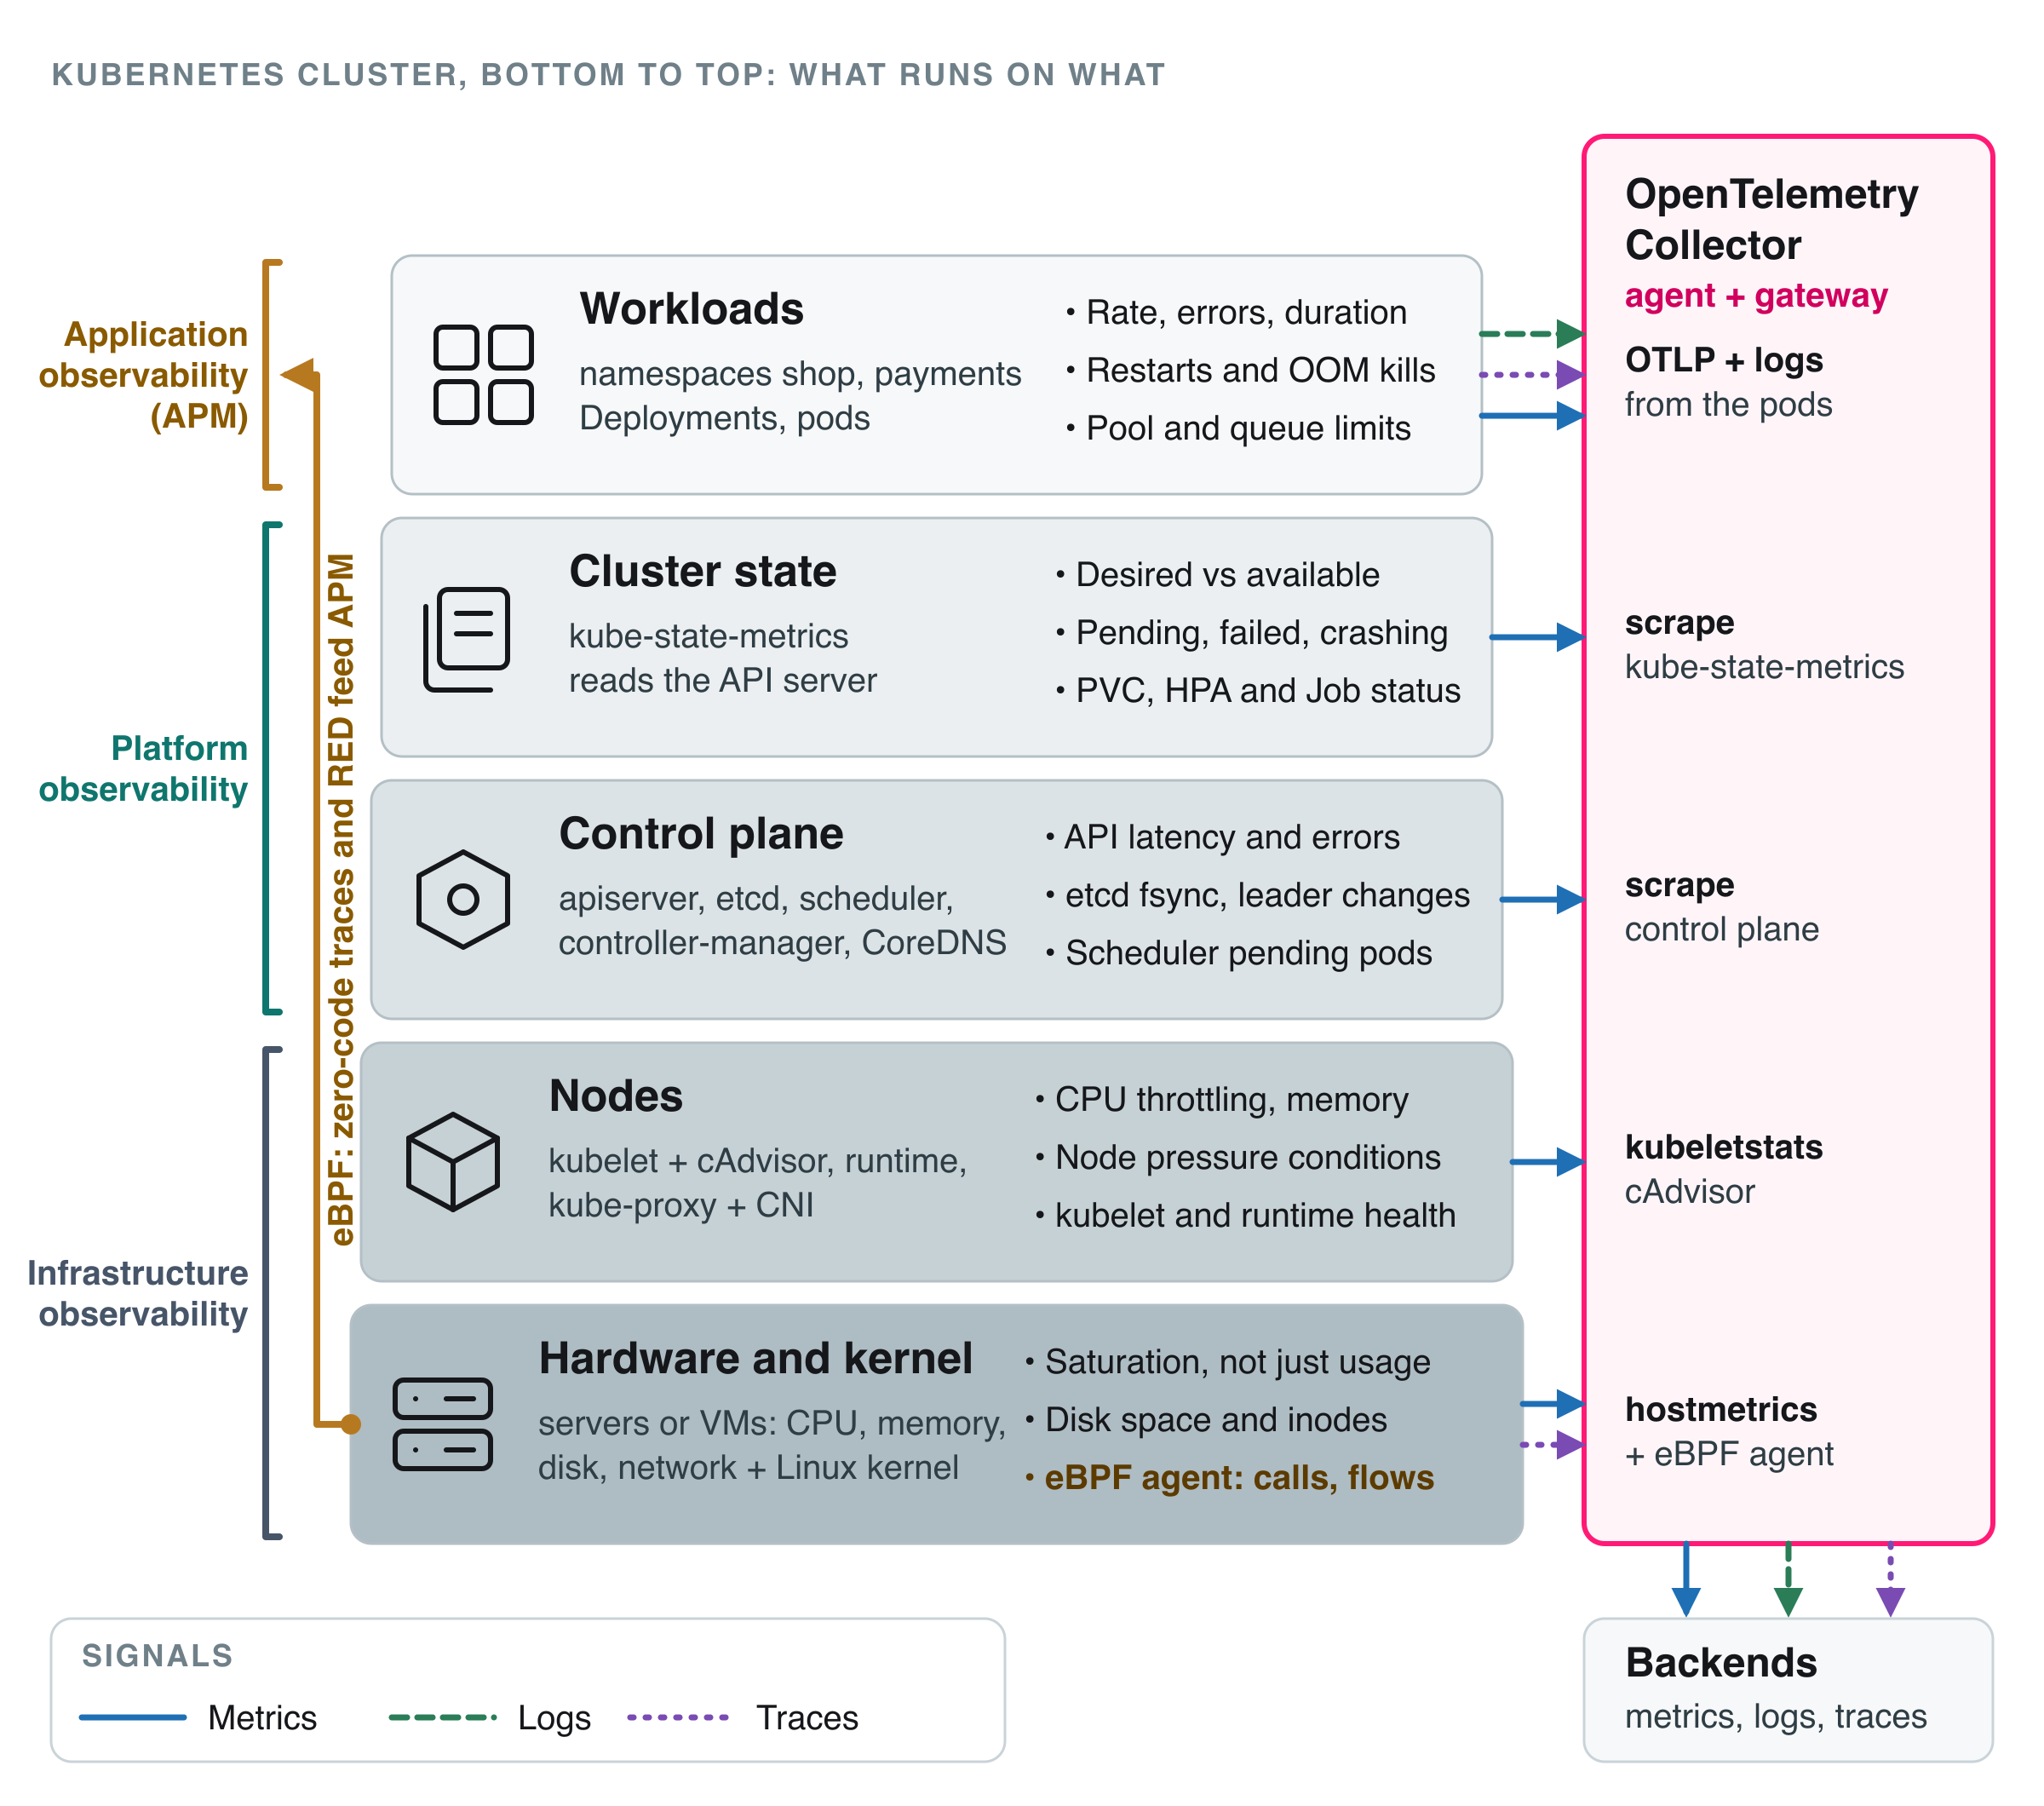
Deshalb beginnt Monitoring mit einer Karte, und Abbildung 1 ist diese Karte: fünf Layer, jeder mit eigener Signalquelle, und ein Collector, der sie einsammelt. Man liest sie von unten nach oben als «was läuft worauf». Die Benutzer spüren Probleme in den Workloads, während die Ursachen oft weiter unten liegen. Deshalb sammelt man alle fünf Layer ein und alarmiert hauptsächlich auf dem obersten. Die Empfehlungen sind herstellerneutral; jedes hier genannte Signal lässt sich mit Open-Source-Werkzeugen erfassen.
Signale und Fragen
Kubernetes-Komponenten liefern Tausende von Zeitreihen; die Arbeit besteht darin zu entscheiden, welche Aufmerksamkeit verdienen. Drei Rahmenwerke halten das ehrlich: die vier Golden Signals (Latency, Traffic, Errors, Saturation) für jeden benutzernahen Service, RED (Rate, Errors, Duration) für alles, was Requests bedient, und USE (Utilization, Saturation, Errors) für alles, was verbraucht wird, etwa Nodes, Disks und etcd. Bei jedem Panel und jedem Alert sollte man sagen können, ob es die Frage «ist der Service gesund?» (ein Symptom) oder «warum ist er ungesund?» (eine Ursache) beantwortet. Symptome sind für Alerts, Ursachen für die Diagnose.
Wie dieser Leitfaden aufgebaut ist
Die fünf Layer fallen in drei Sichten, die meist unterschiedlichen Teams gehören: Application Observability inklusive APM ist Layer 5 (Applikationsteams); Platform Observability sind die Layer 3 und 4, Control Plane und Cluster State (Plattformteam); Infrastructure Observability sind die Layer 1 und 2, Hardware und Nodes (Infrastruktur und Betrieb).
Teil 1 hat ein Kapitel pro Layer, von unten nach oben, jeweils mit demselben Grundgerüst: Worum es geht, Wichtige Signale (eine Tabelle), Woher die Daten kommen und Stolperfallen. Die Kapitel erklären, warum ein Signal wichtig ist; die konkreten Metriknamen stehen einmal gesammelt im Kapitel Das minimale Metrik-Set. Ein abschliessendes Kapitel ordnet das Netzwerk über die Layer hinweg ein. Teil 2 behandelt den Collector: Topologie, Kubernetes-Kontext, eBPF sowie Kardinalität und Kosten. Seine Faustregel: Cluster-weite Ziele genau einmal scrapen. Teil 3 macht aus den Daten Alerts, ergänzt die Kapazitätsplanung und endet mit einer Checkliste.
Teil 1: Was überwachen
Teil 1 folgt den drei Sichten: Infrastructure Observability (Layer 1 und 2), Platform Observability (Layer 3 und 4) und Application Observability (Layer 5).
Layer 1: Hardware und Kernel
Worum es geht
Die Server oder VMs unter dem Cluster, mit CPU, Memory, Disk, Netzwerk und dem Linux-Kernel obendrauf. Sättigung zeigt sich hier als Langsamkeit der Applikation. Auch bei Managed Node Pools bleiben die Maschinen Ihre Sache.
Wichtige Signale
| Signal | Metrikbeispiel | Warum es wichtig ist |
|---|---|---|
| CPU-Sättigung | node_cpu_seconds_total, Run Queue, PSI | Die Auslastung allein verbirgt Contention |
| Memory-Verfügbarkeit | node_memory_MemAvailable_bytes | Der Kernel kann per OOM-Kill eingreifen, bevor Kubernetes evictet |
| Disk-Platz und Inodes | node_filesystem_avail_bytes, _files_free | Images und Logs füllen Disks; DiskPressure evictet Pods |
| Disk-I/O | node_disk_io_time_weighted_seconds_total | etcd und Datenbanken sind latenzempfindlich |
| Netzwerk | node_network_receive_drop_total, Conntrack-Einträge gegenüber dem Limit | Eine volle Conntrack-Tabelle verursacht zufällige Verbindungsabbrüche |
| Uhr und Descriptors | node_timex_offset_seconds, File Descriptors | Zertifikate und etcd vertragen keinen Clock Drift |
Woher die Daten kommen
- node-exporter als DaemonSet oder der
hostmetrics-Receiver des Collectors; beide brauchen Lesezugriff auf/proc,/sysund die Dateisysteme des Hosts. Die unverzichtbaren Serien stehen im Kapitel Das minimale Metrik-Set. - Node-Logs aus journald: Kubelet und Container Runtime laufen als systemd-Units, ihre Logs (und die OOM- und Disk-Meldungen des Kernels) stehen deshalb in keinem Pod-stdout. Man sammelt sie aus dem Journal ein, gefiltert auf die relevanten Units. Die am Schluss beschriebene Referenzimplementierung liest dafür
/var/log/journal. - Auch eBPF-Probes leben in diesem Layer; siehe eBPF-Auto-Instrumentierung und Profiling.
Stolperfallen
- Cluster-Durchschnitte verbergen den einen heissen Node; das Node-Label behalten. Dateisystem-Metriken für tmpfs- und overlay-Mounts sind Rauschen.
- Der Hypervisor kann eine Disk oder NIC drosseln, wo der Gast es nicht sieht; die Volume-Metriken des Cloud-Providers ergänzen.
Layer 2: Nodes
Worum es geht
Die Node-Software, die Ihre Pods ausführt: das Kubelet (mit eingebautem cAdvisor), die Container Runtime, kube-proxy und das Netzwerk-Plugin (CNI). Sie fällt auf eine Art aus, die wie ein Applikationsfehler aussieht: langsame Starts, Restarts ohne Crash, Pods, die in ContainerCreating hängen.
Wichtige Signale
| Signal | Metrikbeispiel | Warum es wichtig ist |
|---|---|---|
| CPU-Throttling | container_cpu_cfs_throttled_periods_total über _periods_total | Hohe Tail Latency bei tiefer durchschnittlicher CPU |
| Container-Pressure (PSI) | container_pressure_cpu_waiting_seconds_total und die Memory- und I/O-Varianten | Durch Contention verlorene Zeit, die Auslastung und Throttling nicht zeigen |
| Memory Working Set | container_memory_working_set_bytes | Die Zahl, auf die der OOM Killer reagiert |
| Node Conditions | kube_node_status_condition (Ready, MemoryPressure, DiskPressure, PIDPressure) | Frühwarnung vor Evictions |
| Pod-Lifecycle | kubelet_pleg_relist_duration_seconds, kubelet_pod_start_duration_seconds | Ein langsamer PLEG geht dem Wechsel eines Nodes auf NotReady voraus |
| Runtime und Volumes | kubelet_runtime_operations_errors_total, kubelet_volume_stats_* | Startfehler; die Basis für PVC-Disk-voll-Alerts |
| Service Programming und CNI | kubeproxy_sync_proxy_rules_duration_seconds, FailedCreatePodSandBox-Events | CNIs ohne freie Adressen lassen Pods stranden |
Unter Pressure evictet das Kubelet Pods, sobald harte Schwellenwerte überschritten sind (Defaults sind unter anderem memory.available<100Mi und nodefs.available<10%); eine Pressure Condition bedeutet also, dass Workloads gleich beendet werden. Man alarmiert auf Ready=false und auf anhaltende Pressure, nicht auf einen kurzen Ausschlag. Wie viel von einem Node für Pods übrig bleibt, behandelt das Kapitel Kapazität und Headroom.
Woher die Daten kommen
- Das Kubelet bietet auf Port 10250 mehrere Endpoints an (Authentifizierung erforderlich):
/metrics,/metrics/cadvisorfür die Nutzung pro Container,/metrics/resourceund/metrics/probes. Derkubeletstats-Receiver des Collectors liest die Pod- und Container-Nutzung aus derselben Quelle. - Node Conditions kommen von kube-state-metrics (Layer 4). Die 19 behaltenswerten cAdvisor-Serien und die Container-PSI-Familie stehen im Kapitel Das minimale Metrik-Set.
Stolperfallen
- Serien mit leeren Labels zählen doppelt. cAdvisor meldet auch Aggregate auf cgroup-Ebene mit leerem
container- oderimage-Label; wer ohne Filter summiert, zählt die Nutzung zweimal. Die Referenzimplementierung verwirft sie beim Scrape und behält nur physische Disk- und Netzwerk-Devices. - Die Serving-Zertifikate des Kubelets sind oft selbst signiert;
insecure_skip_verifyist eine Abkürzung fürs Labor, kein Design. kube-proxy-Metriken gibt es nicht, wenn Ihr CNI kube-proxy ersetzt. - Ob man überhaupt CPU Limits setzen soll, ist umstritten; auf welcher Seite man auch steht, man sollte das Throttling messen, um zu wissen, was es kostet.
Layer 3: Control Plane
Worum es geht
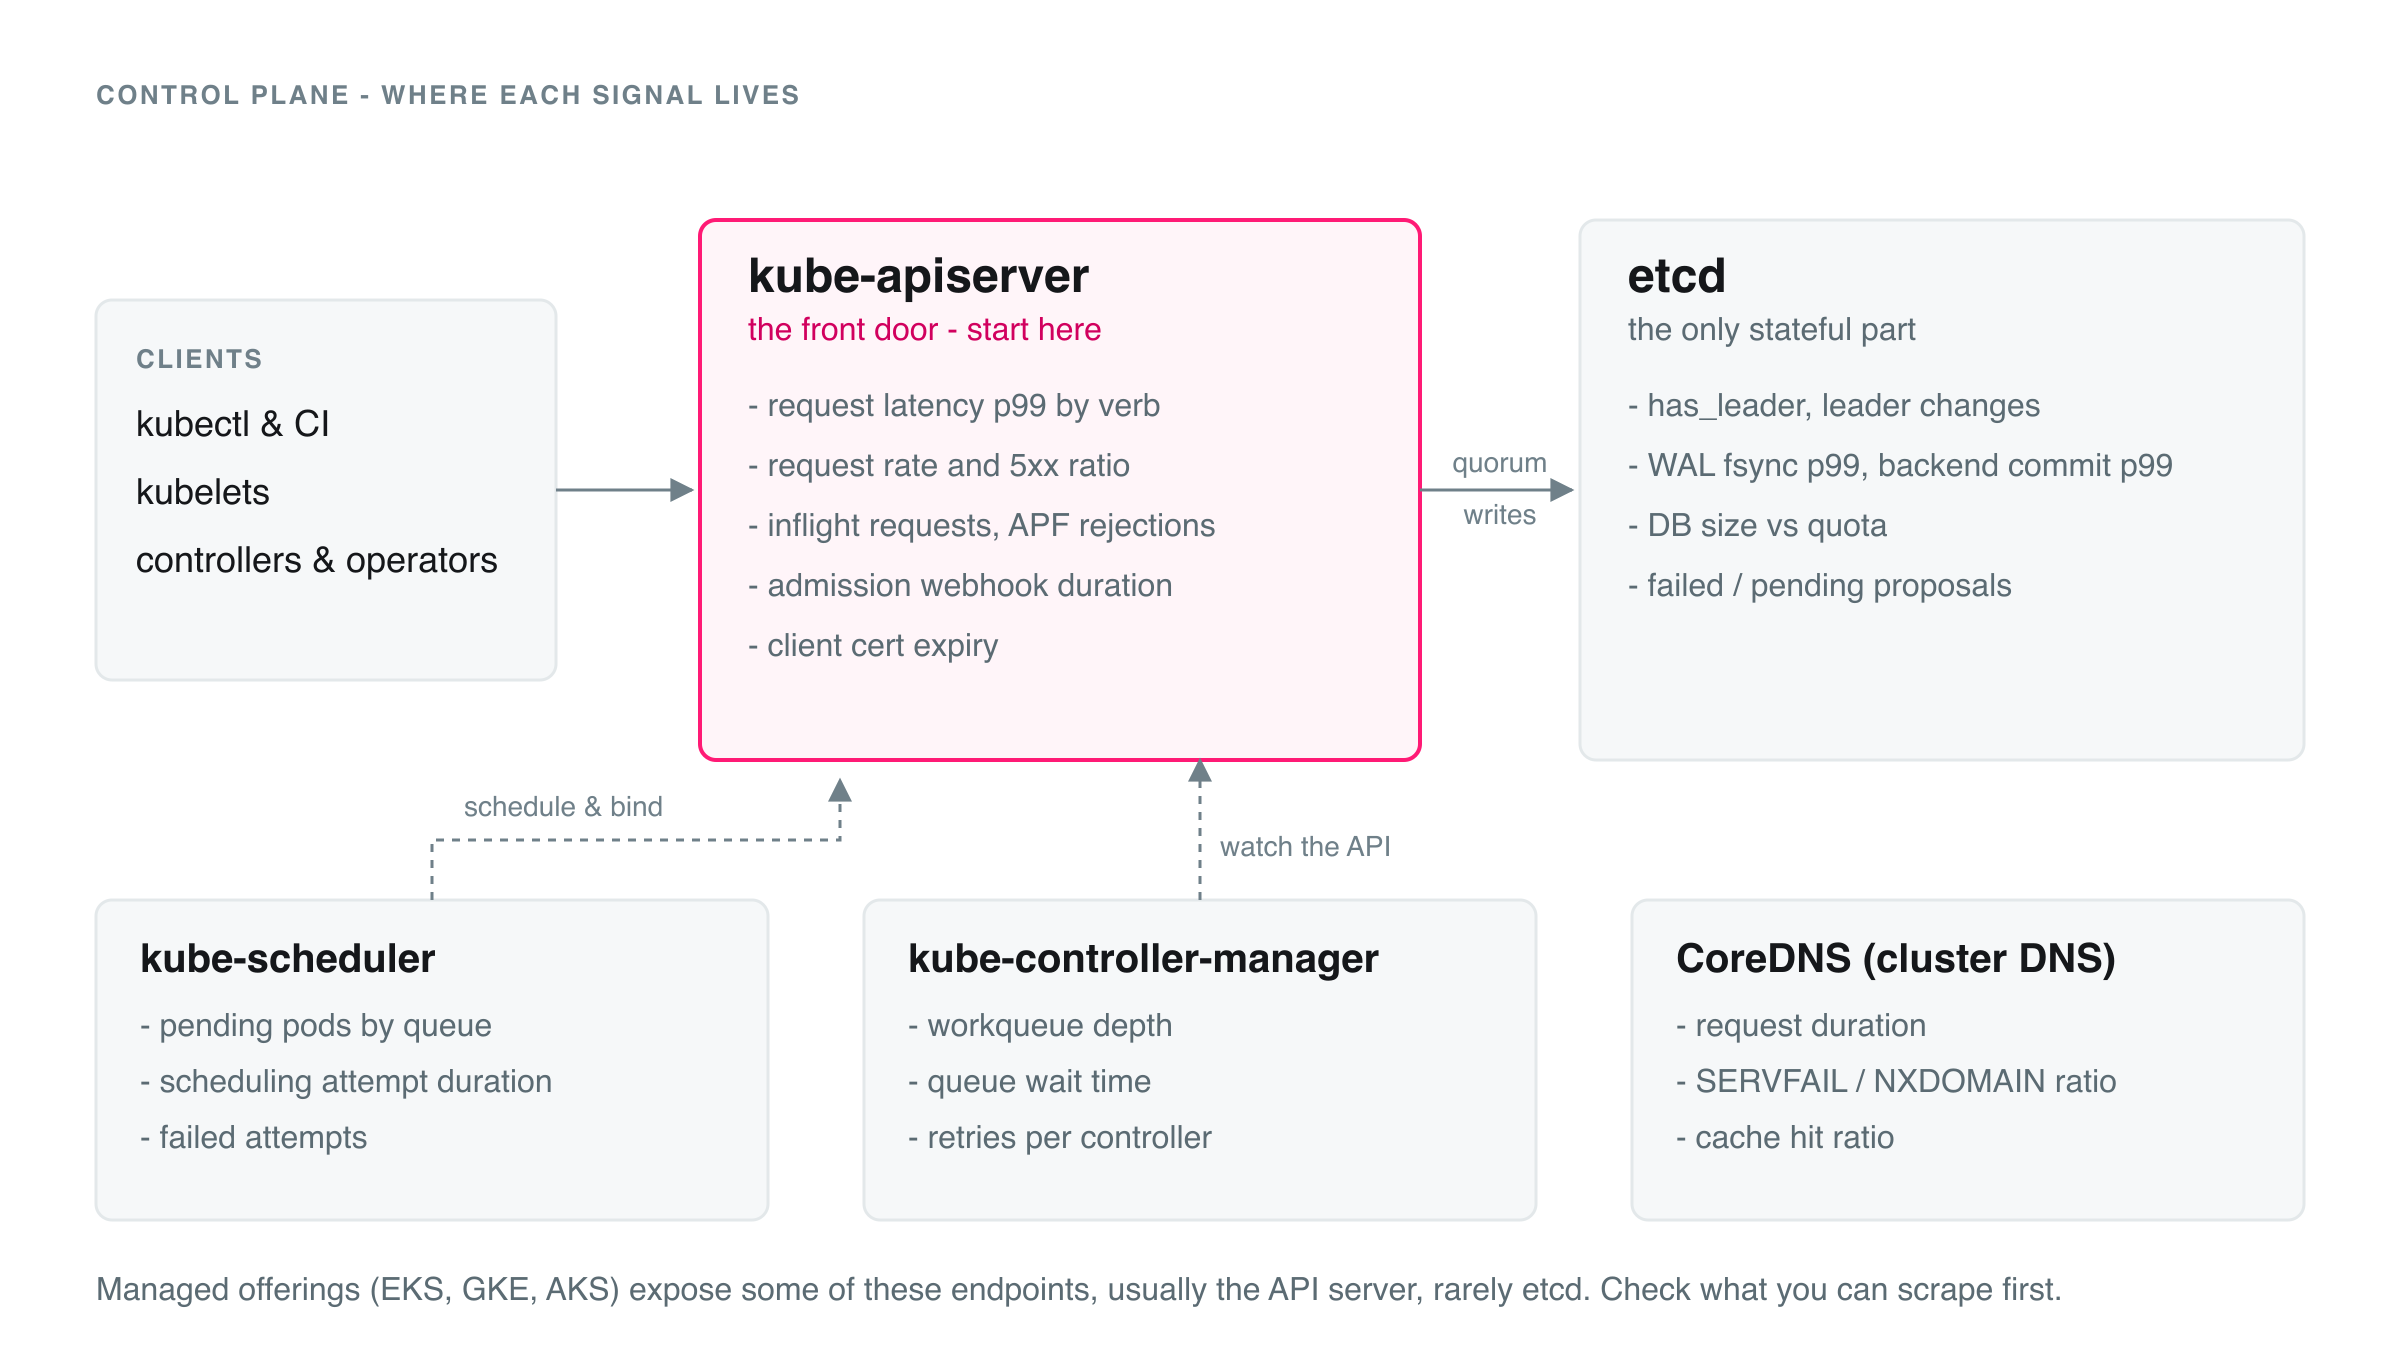
Der Teil von Kubernetes, der entscheidet: der API Server (alles läuft darüber), etcd (der einzige zustandsbehaftete Teil, ein Quorum Store: drei Mitglieder tolerieren einen Ausfall, fünf tolerieren zwei), der Scheduler, der Controller Manager und das Cluster-DNS (CoreDNS, technisch ein Workload, aber etwas, von dem jeder Aufruf abhängt). Ist dieser Layer ungesund, lässt sich nichts Neues mehr schedulen oder ändern, auch wenn bestehende Pods weiter Traffic bedienen.
Wichtige Signale
| Signal | Metrikbeispiel | Warum es wichtig ist |
|---|---|---|
| API-Server-Latenz | apiserver_request_duration_seconds p99 pro Verb, ohne WATCH und CONNECT | Die Gesundheit des Clusters; LIST und GET getrennt beurteilen |
| API-Server-Fehler und Ablehnung | apiserver_request_total nach code, apiserver_flowcontrol_rejected_requests_total | 5xx bedeutet Probleme bei API oder etcd; 429 bedeutet gedrosselte Clients |
| Admission Webhooks | apiserver_admission_webhook_admission_duration_seconds | Ein langsamer Webhook mit failurePolicy: Fail blockiert Deployments im ganzen Cluster |
| Zertifikatsablauf | apiserver_client_certificate_expiration_seconds | Ein klassischer selbstverschuldeter Ausfall |
| etcd-Leader | etcd_server_has_leader, etcd_server_leader_changes_seen_total | Kein Leader heisst keine Writes; häufige Wechsel deuten auf langsame Disk oder Netzwerk |
| etcd-Disk-Latenz | etcd_disk_wal_fsync_duration_seconds, etcd_disk_backend_commit_duration_seconds | etcd-Doku: p99 unter etwa 10 ms (WAL fsync) und 25 ms (Commit) |
| etcd-Grösse gegenüber Quota | etcd_mvcc_db_total_size_in_bytes, etcd_server_quota_backend_bytes | Die Standard-Quota von 2 GiB macht den Cluster read-only, sobald sie erreicht ist |
| Scheduler | scheduler_pending_pods nach Queue, scheduler_scheduling_attempt_duration_seconds | Eine wachsende Unschedulable Queue heisst, dass Pods nicht mehr hineinpassen |
| Controller Manager | workqueue_depth, workqueue_queue_duration_seconds | Wachsende Queues heissen, dass ein Controller nicht nachkommt |
| CoreDNS | coredns_dns_request_duration_seconds, SERVFAIL-Anteil in coredns_dns_responses_total | DNS-Probleme sehen aus wie sporadische Latenz in der Applikation |
Woher die Daten kommen
- Prometheus-Format-
/metrics-Endpoints auf jeder Komponente, dazu/livezund/readyzauf dem API Server (das ältere/healthzist deprecated). Ob man sie erreichen kann, hängt von der Plattform ab, siehe nächster Abschnitt. - Man sollte nicht erwarten, dass das Scraping standardmässig funktioniert. Die Referenzimplementierung liefert das Control-Plane-Scraping ausgeschaltet aus (
controlPlane.enabled: false); eingeschaltet deckt es API Server, Scheduler, Controller Manager und Cluster-DNS ab. etcd ist eine separate Integration mit eigenem Metrik-Port (2381 im Default der Referenz, gesetzt über etcds--listen-metrics-urls), getrennt vom Client-Port 2379, der normalerweise durch TLS-Client-Zertifikate geschützt ist. - Wo man nicht hineinsehen kann, misst man von aussen:
/readyzproben, die API-Latenz so tracken, wie die eigenen Clients sie sehen, und ein Canary Deployment betreiben, dessen Scheduling- und Rollout-Zeit man aufzeichnet. - Control-Plane-Logs. Wo die Komponenten als Static Pods in
kube-systemlaufen, erfasst die gewöhnliche Pod-Log-Sammlung sie bereits; Kubelet- und containerd-Logs stehen in journald (Layer 1). Wo der Provider die Control Plane betreibt, erreichen die Logs Ihre Nodes nie, und man muss den Export des Providers einschalten: EKS Control Plane Logging (api,audit,authenticator,controllerManager,scheduler, standardmässig alle aus) nach CloudWatch Logs, GKE-Control-Plane-Logs nach Cloud Logging (das Ändern der Einstellung startet die Control Plane neu, ein kurzer Ausfall bei zonalen Clustern), AKS-Diagnostic-Settings in einen Log-Analytics-Workspace (Kategorien wiekube-apiserver,kube-controller-manager,kube-scheduler,kube-audit). - Was sich zu lesen lohnt: etcd-Warnungen zu langsamen Requests («apply request took too long») und Leader-Wahlen; API-Server-Fehler und Webhook-Timeouts; die Gründe des Schedulers für nicht schedulbare Pods (auch in den Events); Reconcile-Fehler des Controller Managers.
- Audit-Logs sind ein eigenes Signal: Sie beantworten, wer was getan hat, auch wer ein Deployment gelöscht hat. Der API Server schreibt sie nur mit einer Audit Policy (
--audit-policy-file) und einem Backend, einer Logdatei (--audit-log-path) oder einem Webhook (--audit-webhook-config-file). Regeln setzen einen Level (None,Metadata,Request,RequestResponse), und die erste passende Regel gewinnt. Für die meisten Ressourcen loggt manMetadata, und für Secrets nieRequestResponse, weil deren Bodies die Secret-Werte in Ihre Logs kopieren würden. Das Volumen ist hoch:None-Regeln für lärmige Requests ergänzen und die StageRequestReceivedweglassen. Bei Managed Clusters kommen sie über den Export des Providers (AKS bietetkube-audit-admin, das get- und list-Events weglässt).
Verwaltete, gehostete und selbstverwaltete Control Planes
Wer die Control Plane betreibt, bestimmt, was man sehen kann. Diese Fähigkeiten ändern sich schnell, prüfen Sie sie deshalb für Ihre Version.
| Plattform | Control Plane für Sie sichtbar? | Mitgelieferter Monitoring-Stack | Worauf man achten muss |
|---|---|---|---|
| EKS, GKE, AKS | Teilweise. EKS: nur API-Server-Metriken. GKE: API Server, Scheduler, Controller Manager, wenn aktiviert. AKS: inklusive etcd, über Managed Prometheus | Der Monitoring-Service des Providers | Logs und Audit-Logs gibt es erst, nachdem man den Export aktiviert hat |
| OpenShift | Ja, im Cluster | Platform Monitoring in openshift-monitoring (Prometheus, Alertmanager, node-exporter, kube-state-metrics, Thanos Querier), plus optionales User Workload Monitoring | Kein zweites kube-state-metrics oder node-exporter deployen; aus dem bestehenden Stack lesen. Privilegierte Collectors und eBPF-Agents brauchen eine Security Context Constraint, die sie erlaubt |
| Rancher (RKE2, K3s) | Rancher ist eine Management-Schicht; die Sichtbarkeit richtet sich nach dem Cluster-Typ. RKE2: etcd-Metriken brauchen etcd-expose-metrics (Default false). K3s: Die Control Plane läuft in einem Prozess, standardmässig SQLite (kine), für HA embedded etcd | Rancher Monitoring: Prometheus Operator, Prometheus, Alertmanager, Grafana, node-exporter, kube-state-metrics, pro Cluster (neuere Versionen bieten auch ein Chart nur mit Dashboards; prüfen Sie Ihre Version) | Wie bei OpenShift: nicht doppelt einsammeln. Gehostete und K3s-Cluster brauchen eine eigene Scrape-Konfiguration; mit SQLite gibt es kein etcd zum Scrapen |
| Kubermatic Kubernetes Platform (KKP) | Die Control Planes der User Cluster laufen als Pods in einem Seed Cluster, von innen verhält sie sich daher wie ein gehosteter Service | Ein eigener Monitoring-, Logging- und Alerting-Stack (MLA), für die Plattform und für User Cluster | Prüfen, welche Teile man schon bekommt, bevor man eigene ergänzt |
| Selbstverwaltet (kubeadm) | Alles | Keiner | Scheduler und Controller Manager binden an 127.0.0.1, und etcd liefert Metriken standardmässig auf 127.0.0.1:2381; ein Collector im Pod-Netzwerk erreicht sie deshalb nicht ohne Anpassungen |
Stolperfallen
- API-Server-Histogramme sind gross; die verwendeten Metriken und Buckets per Allow List freigeben und langlebige
WATCH- undCONNECT-Requests aus den Latenz-Quantilen ausschliessen. - Auf gehosteten Clustern sieht man von den Control-Plane-Logs nichts, bis man den Export aktiviert, und Audit-Logs können die Log-Rechnung dominieren; filtern.
- Ein lärmiger Controller oder Operator zeigt sich als Inflight- und abgelehnte Requests, bevor irgendetwas anderes kaputtgeht.
Layer 4: Cluster State
Worum es geht
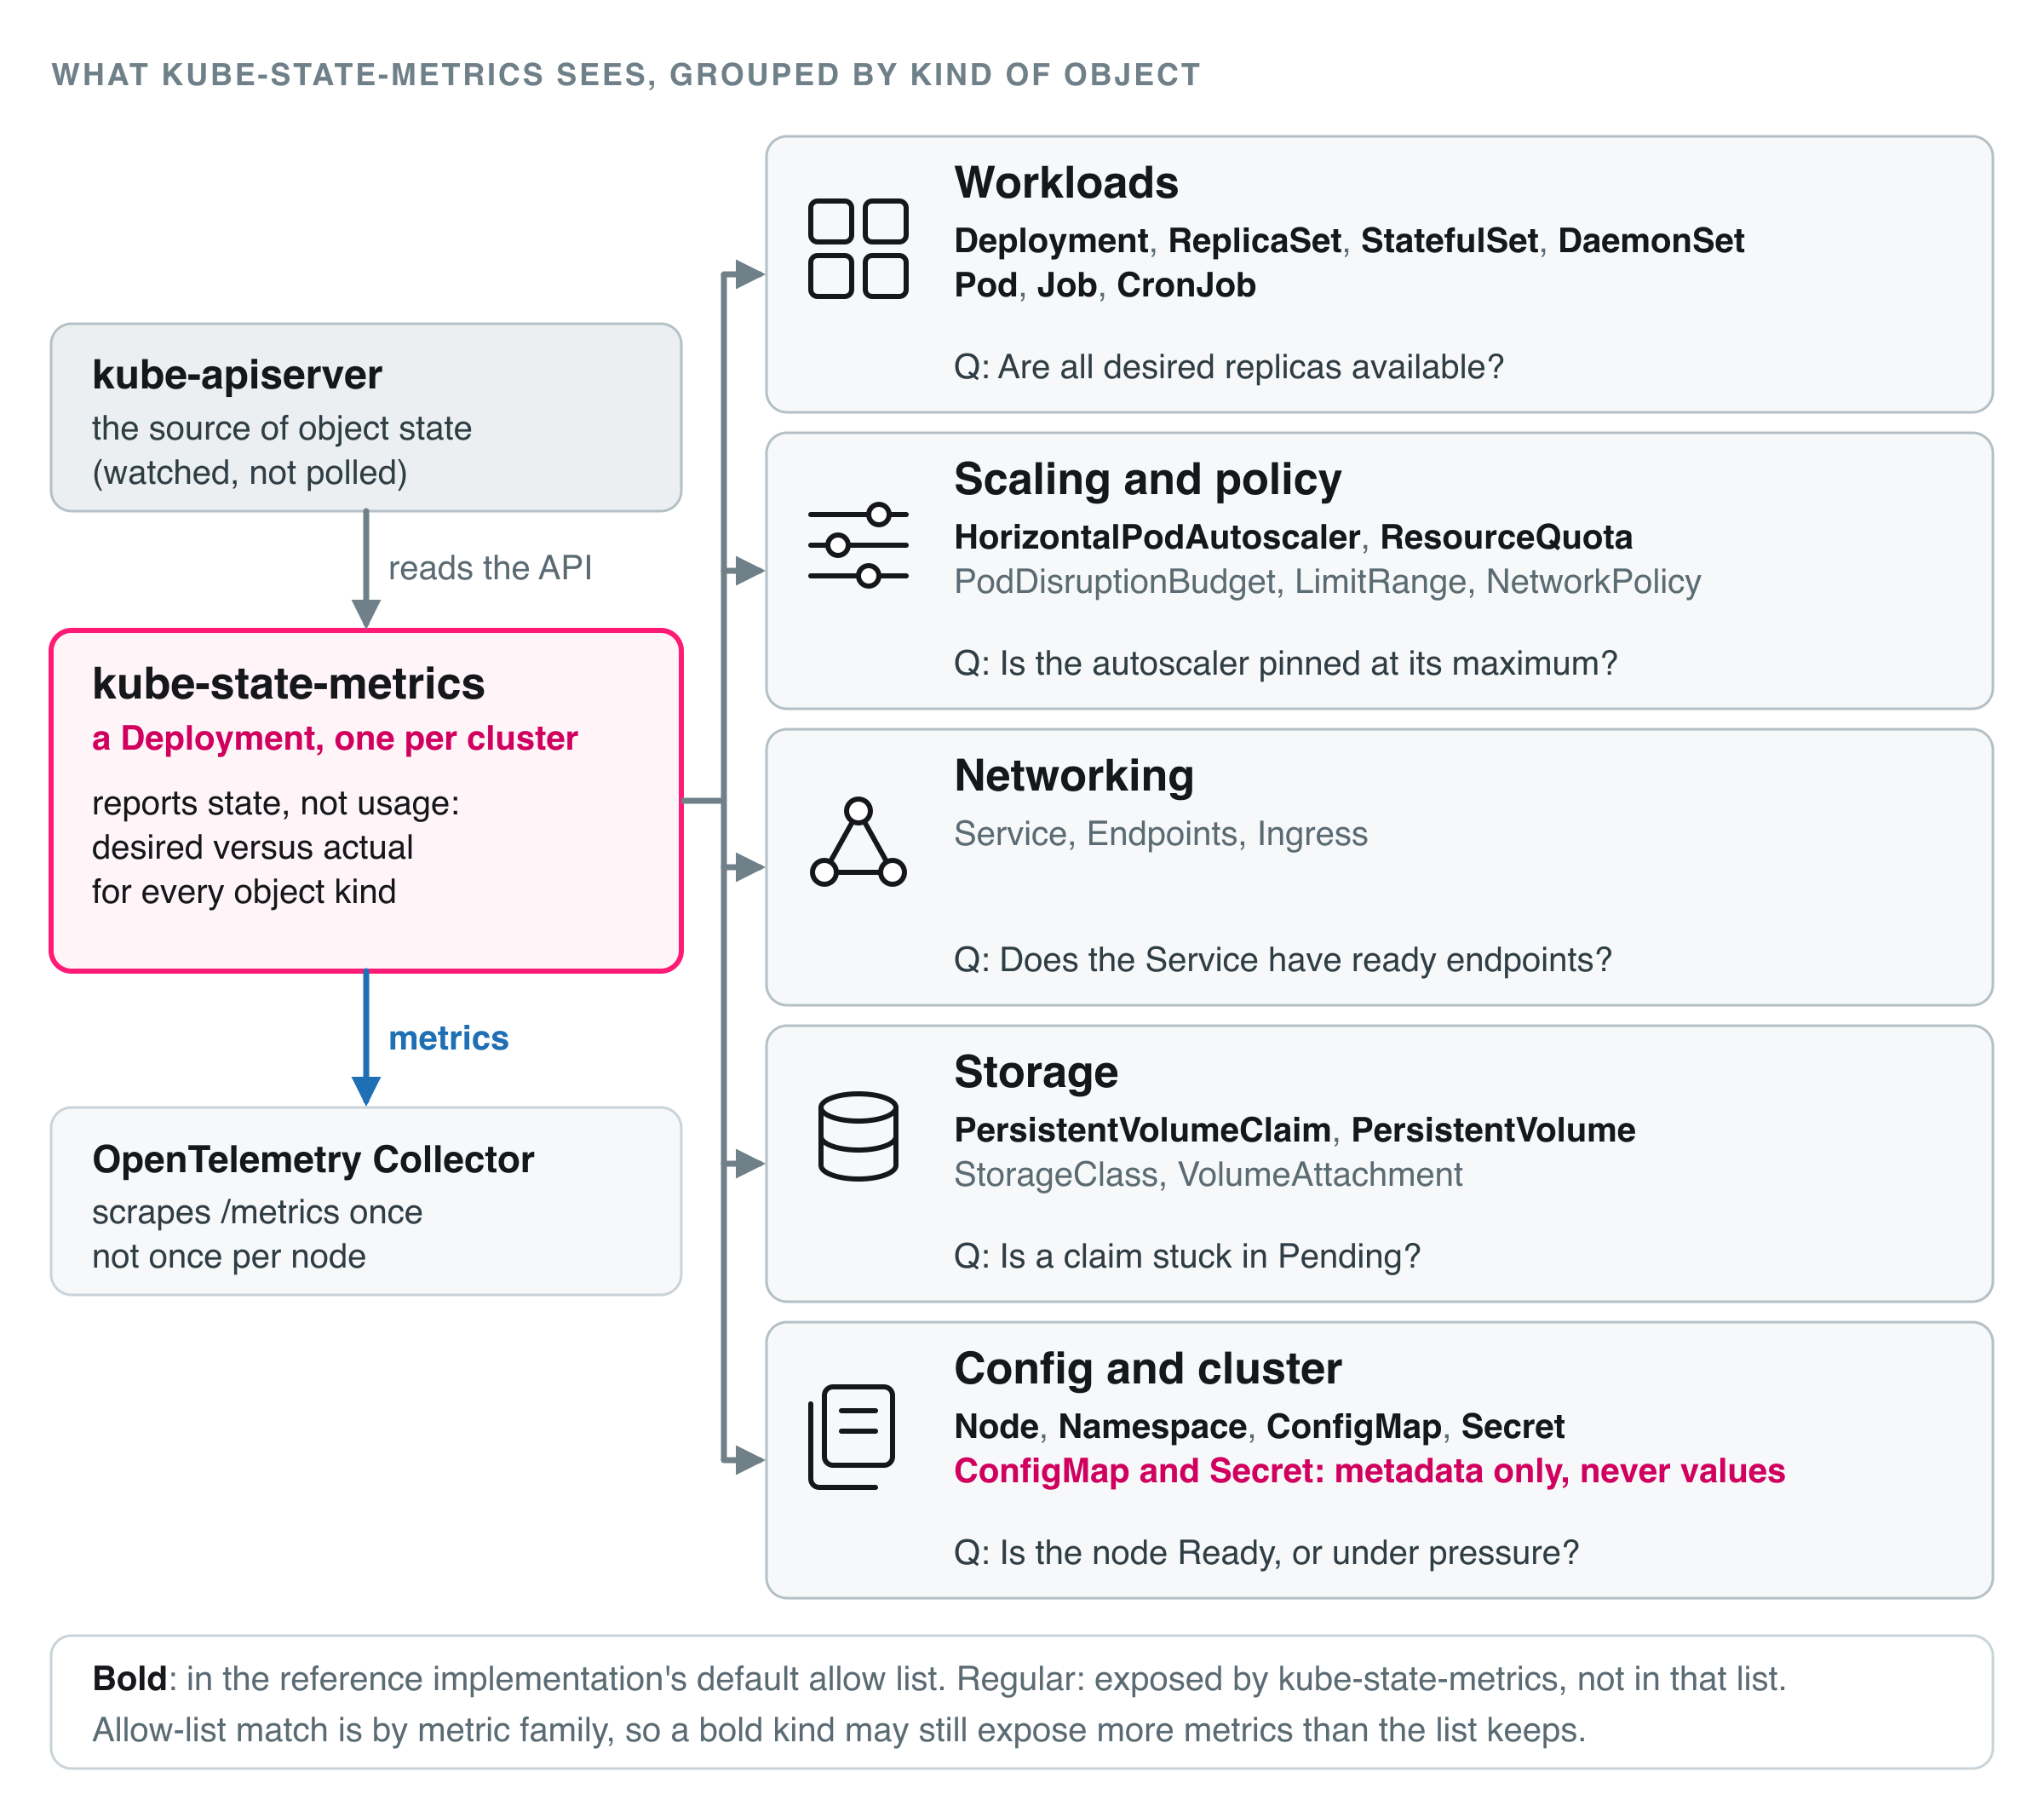
Was Kubernetes über seine Objekte glaubt: gewünschte gegenüber tatsächlichen Replicas, Pod-Phasen, Volume Claims, Autoscaler und Jobs (Abbildung 3 gruppiert die Arten). Das beantwortet die Frage «entspricht die Realität dem, was bestellt wurde?» und ist die nützlichste Quelle für Kubernetes-spezifische Alerts. Sie stammt von kube-state-metrics und von den Events. Die dort gemeldeten Requests und Quotas sind zugleich das Rohmaterial für Kapazität und Headroom.
Wichtige Signale
| Signal | Metrikbeispiel | Warum es wichtig ist |
|---|---|---|
| Rollout-Lücke | kube_deployment_spec_replicas gegenüber _status_replicas_available | Eine dauerhafte Lücke ist ein gescheiterter Rollout |
| Pod-Phase | kube_pod_status_phase (Pending, Failed, Unknown) | Hängende Pods |
| Crash Loops, OOM, Restarts | kube_pod_container_status_waiting_reason, _last_terminated_reason, _restarts_total | Unterscheidet OOMKilled von einem Applikationsabsturz |
| Storage | kube_persistentvolumeclaim_status_phase | Ein Pending PVC blockiert seine Pods |
| Autoscaling | HPA Current Replicas gegenüber _spec_max_replicas | Ein HPA am Maximum ist eine Kapazitätswarnung |
| Quotas | kube_resourcequota (used gegenüber hard) | Deployments scheitern leise, wenn eine Quota erreicht ist |
| Jobs | kube_job_status_failed | Fehlgeschlagene Jobs scheitern still, solange man sie nicht beobachtet |
| Events | FailedScheduling, BackOff, Unhealthy, FailedMount, Evicted, NodeNotReady | Sie erklären, warum |
Woher die Daten kommen
- kube-state-metrics ist ein kleines Deployment, das die API beobachtet und den Objektzustand in Metriken umwandelt; es meldet Zustand, nicht Nutzung. Die Default Allow List der Referenzimplementierung behält 43 Muster (siehe Das minimale Metrik-Set);
kube_pod_ownerist diejenige, die man für Owner-Joins braucht. - Events sind ein eigenes Signal, und die API behält sie standardmässig etwa eine Stunde. Man sammelt sie als Logs mit einem einzelnen Collector ein und filtert nach Reason und Level, weil Normal-Events geschwätzig sind. Der OpenTelemetry-
k8sobjects-Receiver kann sie beobachten (er braucht list- und watch-Berechtigung auf Events und genau eine Replica, siehe Collector-Topologie):
receivers:
  k8sobjects:
    auth_type: serviceAccount
    objects:
      - name: events
        mode: watch
        field_selector: type=Warning    # Warning events only
service:
  pipelines:
    logs: { receivers: [ k8sobjects ], exporters: [ otlp ] }   # singleton Deployment, one replica
Die API fasst Wiederholungen zu einem einzigen Event mit einem count- (oder series-)Feld zusammen; Logzeilen zu zählen unterschätzt also die Anzahl, man liest stattdessen den Count.
Stolperfallen
- kube-state-metrics gibt es einmal pro Cluster; scrapt es jeder Agent, bekommt man N Kopien jeder Serie (siehe Collector-Topologie). Labels werden standardmässig nicht exportiert; sparsam per Allow List freigeben.
- Ein Quota-Fehler ist leise: Pods werden nie erstellt, also ist nichts Pending. Das Signal steckt in den Events und den ReplicaSet Conditions.
Layer 5: Workloads
Worum es geht
Ihre Applikationen: Namespaces, Deployments, StatefulSets und ihre Pods. Das ist der Layer, den die Benutzer spüren, und die Heimat von Application Observability und APM; er braucht die Golden Signals plus die Kubernetes-Sicht auf dieselben Pods.
Wichtige Signale
| Signal | Metrikbeispiel | Warum es wichtig ist |
|---|---|---|
| Rate, Errors, Duration | Applikations-Histogramme und -Counter pro Endpoint (oder aus eBPF abgeleitete RED-Metriken) | Das Symptom und die Basis für SLOs |
| Saturation | Thread Pools, Connection Pools, Queue-Tiefe | Zeigt die Verlangsamung, bevor Fehler auftreten |
| Throttling, Pressure und OOM | Container-Metriken aus Layer 2 pro Workload | Die stillen Killer (siehe unten) |
| Probes und Rollouts | prober_probe_total, kube_pod_status_ready, PodDisruptionBudget-Headroom | Falsch konfigurierte Probes verursachen selbstverschuldete Incidents; Budgets entscheiden, ob ein Node Drain weitergehen kann |
| Business-Signale | Bestellungen, Logins, Queue-Alter | Wofür das Produkt da ist |
Requests, Limits und tatsächliche Nutzung. Ein Request ist das, was der Scheduler reserviert, ein Limit ist das, was der Kernel durchsetzt, und die tatsächliche Nutzung dazwischen braucht die Kapazitätsplanung. Die drei vergleicht man über Tage, nicht über Minuten.
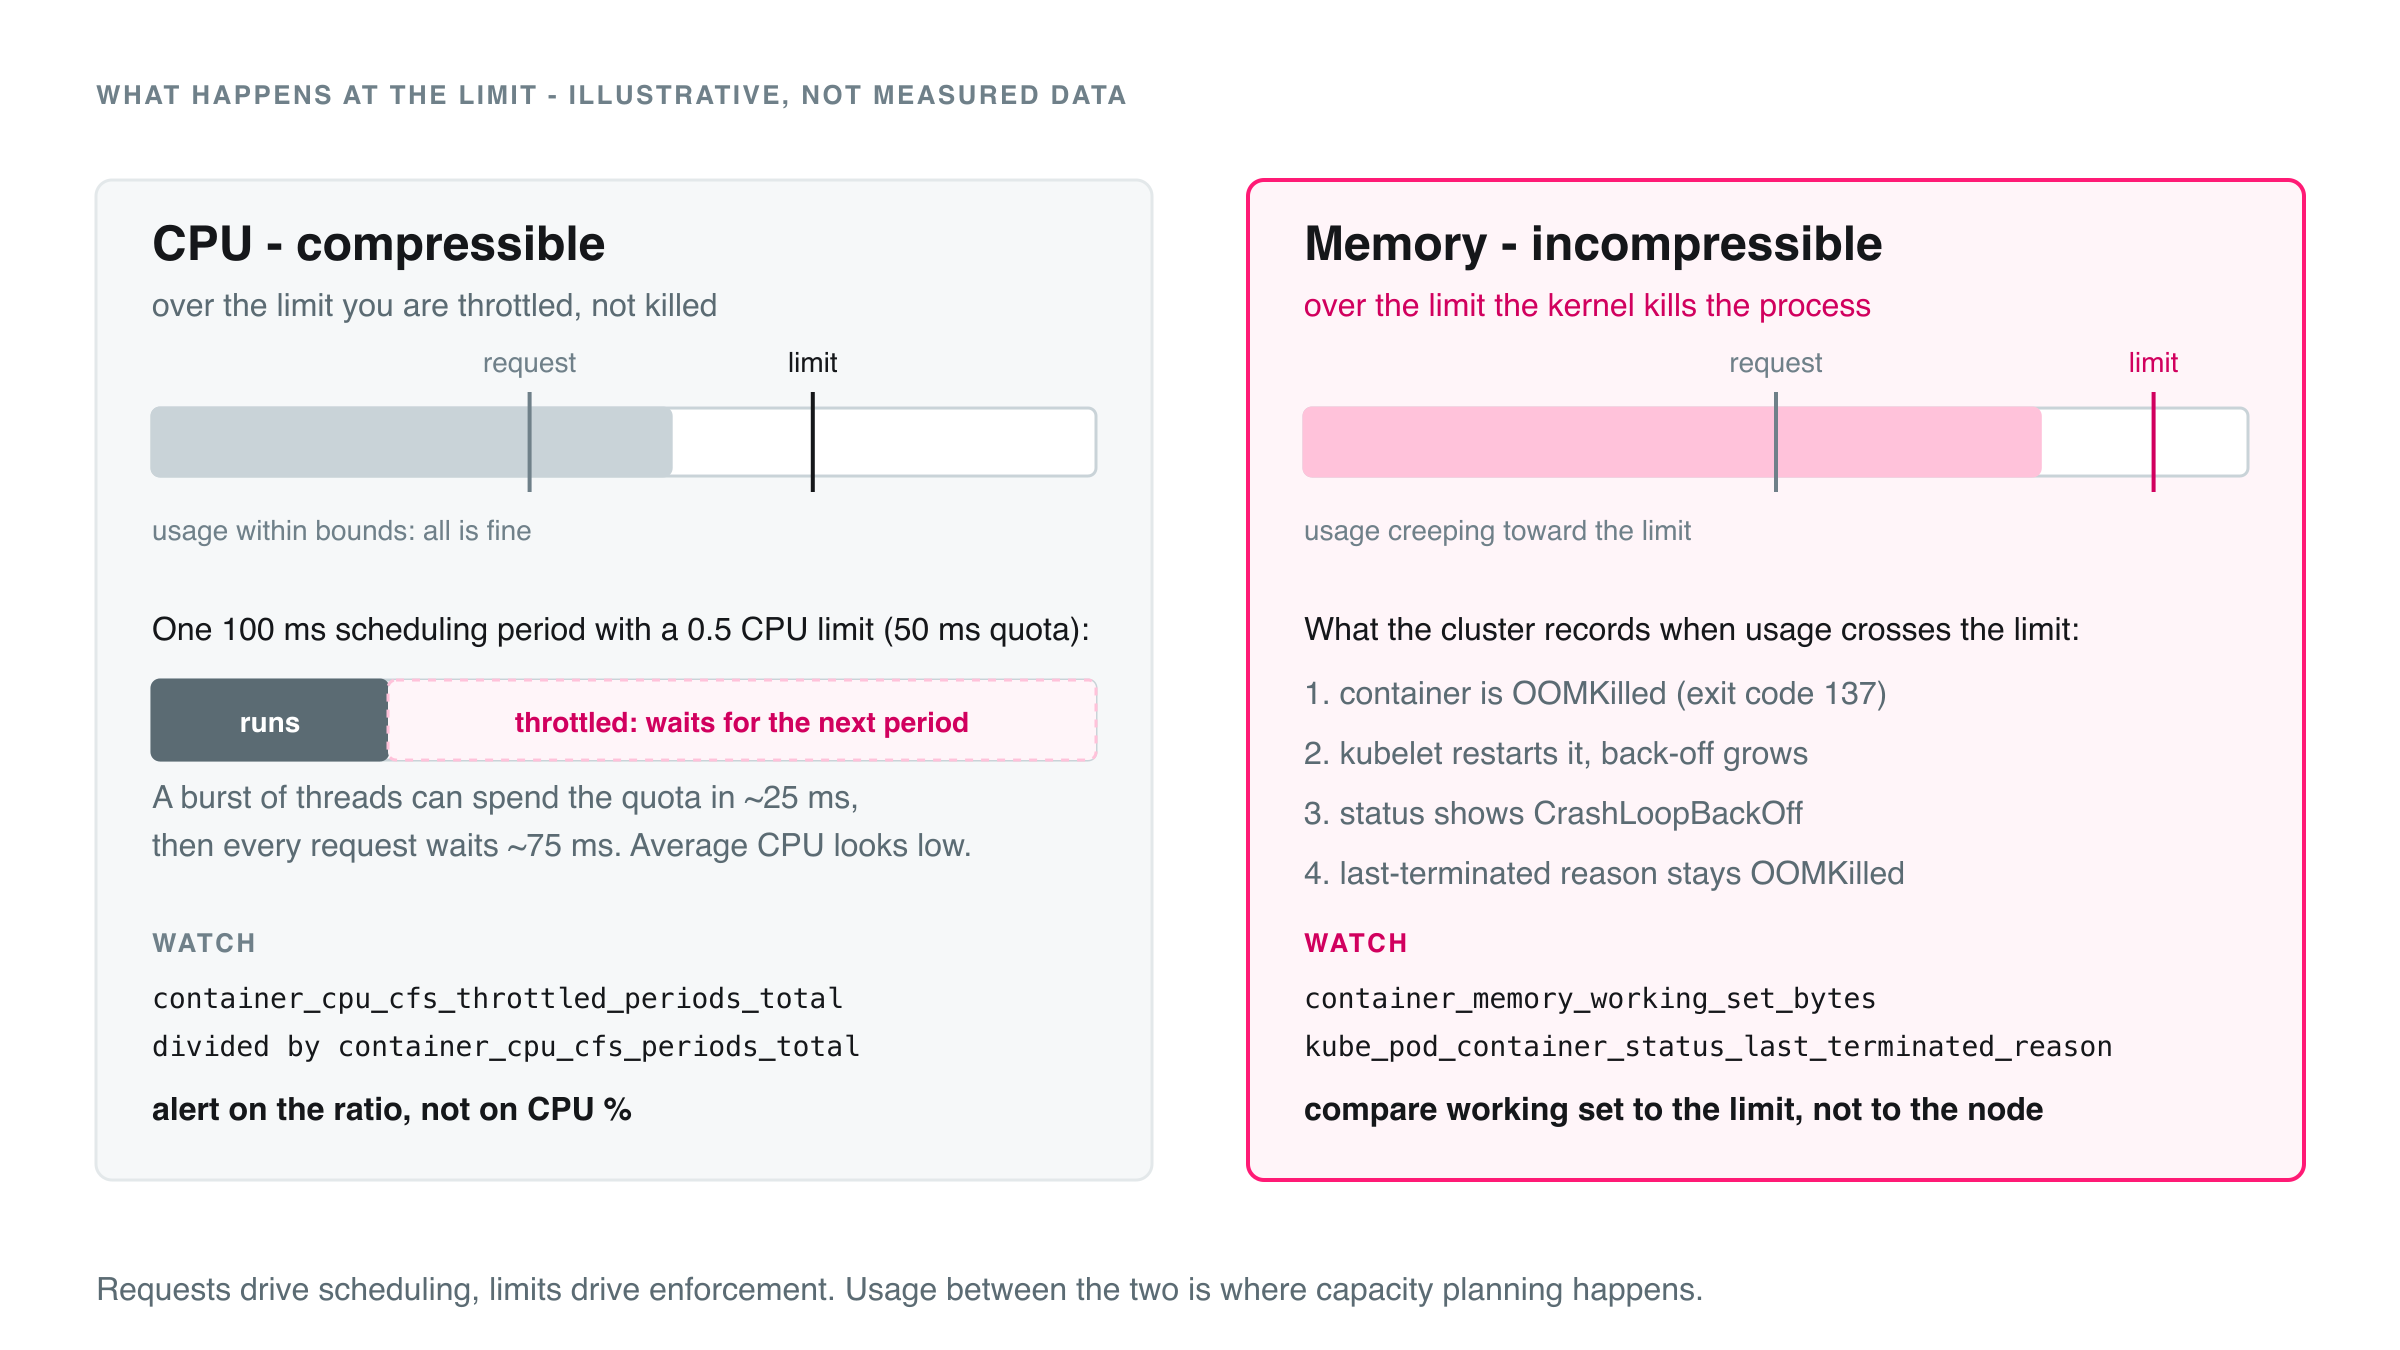
CPU ist komprimierbar, Memory nicht. Ein Container am CPU-Limit wird für den Rest der 100-ms-Periode angehalten; ein burstender Service kann so in jeder Periode einen grossen Teil eingefroren verbringen, während die durchschnittliche CPU harmlos aussieht. Man beobachtet den gedrosselten Anteil statt der CPU-Prozente und liest ihn neben der Container-PSI: Waiting-Zeit zeigt Verhungern auch dort, wo kein Throttling auftritt. Ein Container am Memory-Limit wird beendet (Exit Code 137, OOMKilled) und mit wachsendem Back-off neu gestartet, was zu CrashLoopBackOff wird. Man trackt das Working Set gegenüber dem Limit und alarmiert auf den letzten Terminated Reason, nicht nur auf Restart-Zähler.
Woher die Daten kommen
- Metriken, die die Applikation bereitstellt, gescrapt per annotationsbasierter Autodiscovery (im Stil der Community-Annotation
prometheus.io/scrapeoder einer Collector-spezifischen Annotation), über ServiceMonitor-, PodMonitor- und Probe-Objekte aus dem Prometheus-Operator-Ökosystem oder über fertige Integrationen für Datenbanken und Infrastruktur (die Referenzimplementierung bringt unter anderem PostgreSQL, MySQL, etcd und cert-manager mit). - Logs. Container schreiben nach stdout und stderr, die Runtime legt den Stream unter
/var/log/pods/ab, und das Kubelet rotiert ihn (standardmässig 10 MiB, fünf Dateien). Ein DaemonSet liest die Dateien aller Pods auf seinem Node. Man schreibt strukturiertes JSON, ein Event pro Zeile, mit Trace-IDs, und loggt nie Secrets oder Personendaten. - Traces. Mit OpenTelemetry-SDKs instrumentieren, den W3C-
traceparent-Header über jeden Hop weitergeben und Metriken mit Exemplars mit Traces verknüpfen. Wo man noch nicht instrumentieren kann, nimmt man eBPF. Sampling behandelt das Kapitel Collector-Topologie.
Stolperfallen
- Eine zu aggressive Liveness Probe startet einen langsamen, aber gesunden Service neu; eine Readiness Probe, die eine geteilte Abhängigkeit prüft, nimmt alle Replicas auf einmal aus dem Verkehr.
- Ein fehlender Request macht einen Pod zum ersten Kandidaten für die Eviction und untergräbt die Kapazitätsplanung.
- Unbegrenzte Labels (User-IDs, Request-IDs, vollständige URLs) in Applikationsmetriken sind der schnellste Weg zu einer schlechten Rechnung (siehe Kardinalität und Kosten).
Netzwerk quer durch alle Layer
Das Netzwerk ist kein eigener Layer; es läuft durch alle fünf, und ein verworfenes Paket sieht aus wie ein Timeout, weshalb zuerst «das Netzwerk» beschuldigt wird. Die Tabelle ordnet Netzwerksignale dem Stack zu; wo ein Layer-Kapitel eines bereits behandelt, sagt das die letzte Spalte.
| Layer | Signal | Metrik oder Quelle | Warum es wichtig ist |
|---|---|---|---|
| Hardware und Kernel | TCP-Retransmits und -Resets | node_netstat_Tcp_RetransSegs, _Tcp_OutRsts, _TcpExt_TCPTimeouts | Paketverlust zeigt sich hier, bevor Applikationen in Timeouts laufen. NIC-Drops und Conntrack: Layer 1 |
| Nodes | NetworkPolicy-Drops | CNI-Drop-Counter; Ciliums Hubble hubble_drop_total nach reason | Ein verworfenes Paket ist ein stiller Timeout. CNI-Gesundheit und kube-proxy: Layer 2 |
| Control Plane | Client-seitiges DNS | Applikations-Lookups gegenüber der CoreDNS-Query-Rate, NXDOMAIN-Anteil | Die Verstärkung versteckt sich in der Differenz. CoreDNS selbst: Layer 3 |
| Cluster State | Service ohne bereite Endpoints | kube_endpoint_address{ready}, kube_endpoint_info; kube_endpointslice_endpoints{ready} | Ein Service ohne Backends verwirft Traffic |
| Cluster State | LoadBalancer ohne Adresse | kube_service_spec_type{type="LoadBalancer"} ohne kube_service_status_load_balancer_ingress | Die Cloud-Integration oder die Quota versagt |
| Workloads | Ingress- oder Gateway-RED | Die Request-, 5xx-, Latenz- und Upstream-Fehler-Metriken Ihres Controllers (Namen variieren) | Das benutzernahe Symptom, pro Host und Route |
| Workloads | Ablauf von TLS-Zertifikaten | certmanager_certificate_expiration_timestamp_seconds | Ein Ablauf ist ein geplanter Ausfall |
| Beliebig | Zonenübergreifender Traffic | Flow-Daten mit Zonen-Labels (eBPF, Hubble) | Er kostet Geld und Latenz |
Policy-Drops. Die Durchsetzung geschieht im CNI, also liegt dort auch der Beleg: Cilium zählt Drops nach Reason über Hubble (standardmässig aus), andere CNIs bieten eigene Counter. Ohne sie ist «connection timed out» zwischen zwei Pods ein Ratespiel.
DNS aus Client-Sicht. Mit dem Default ndots:5 durchläuft der Lookup eines externen Namens zuerst die Search Domains des Clusters, sodass aus einem Applikations-Lookup mehrere Queries und ein Haufen NXDOMAIN-Antworten werden. Man beobachtet den NXDOMAIN-Anteil und die CoreDNS-Query-Rate im Verhältnis zur Request-Rate. Gegenmassnahmen: vollqualifizierte Namen mit abschliessendem Punkt, ein tieferer ndots in der dnsConfig des Pods und NodeLocal DNSCache, ein Cache pro Node, der wiederholte Lookups lokal beantwortet.
Endpoints. Endpoints werden durch EndpointSlices abgelöst. In kube-state-metrics sind die kube_endpoint_*-Metriken stabil und die EndpointSlice-Metriken experimentell, und keine davon steht in der Default Allow List der Referenz; man ergänzt also bewusst diejenige, die man nutzt. Wer ein Service Mesh betreibt: Dessen Proxies exportieren Golden Metrics pro Workload-Paar und den mTLS-Status, eine nützliche optionale Quelle.
Teil 2: Wie einsammeln
Collector-Topologie
Der Collector-Balken in Abbildung 1 ist nicht ein einzelnes Ding. Das übliche Muster ist ein Agent pro Node (ein DaemonSet) für alles Node-Lokale, plus ein Gateway (ein Deployment) für Cluster-weite Entscheidungen: Redaction, Filtern, Sampling, Retries und Fan-out. Das ist notwendig, aber nicht ausreichend.
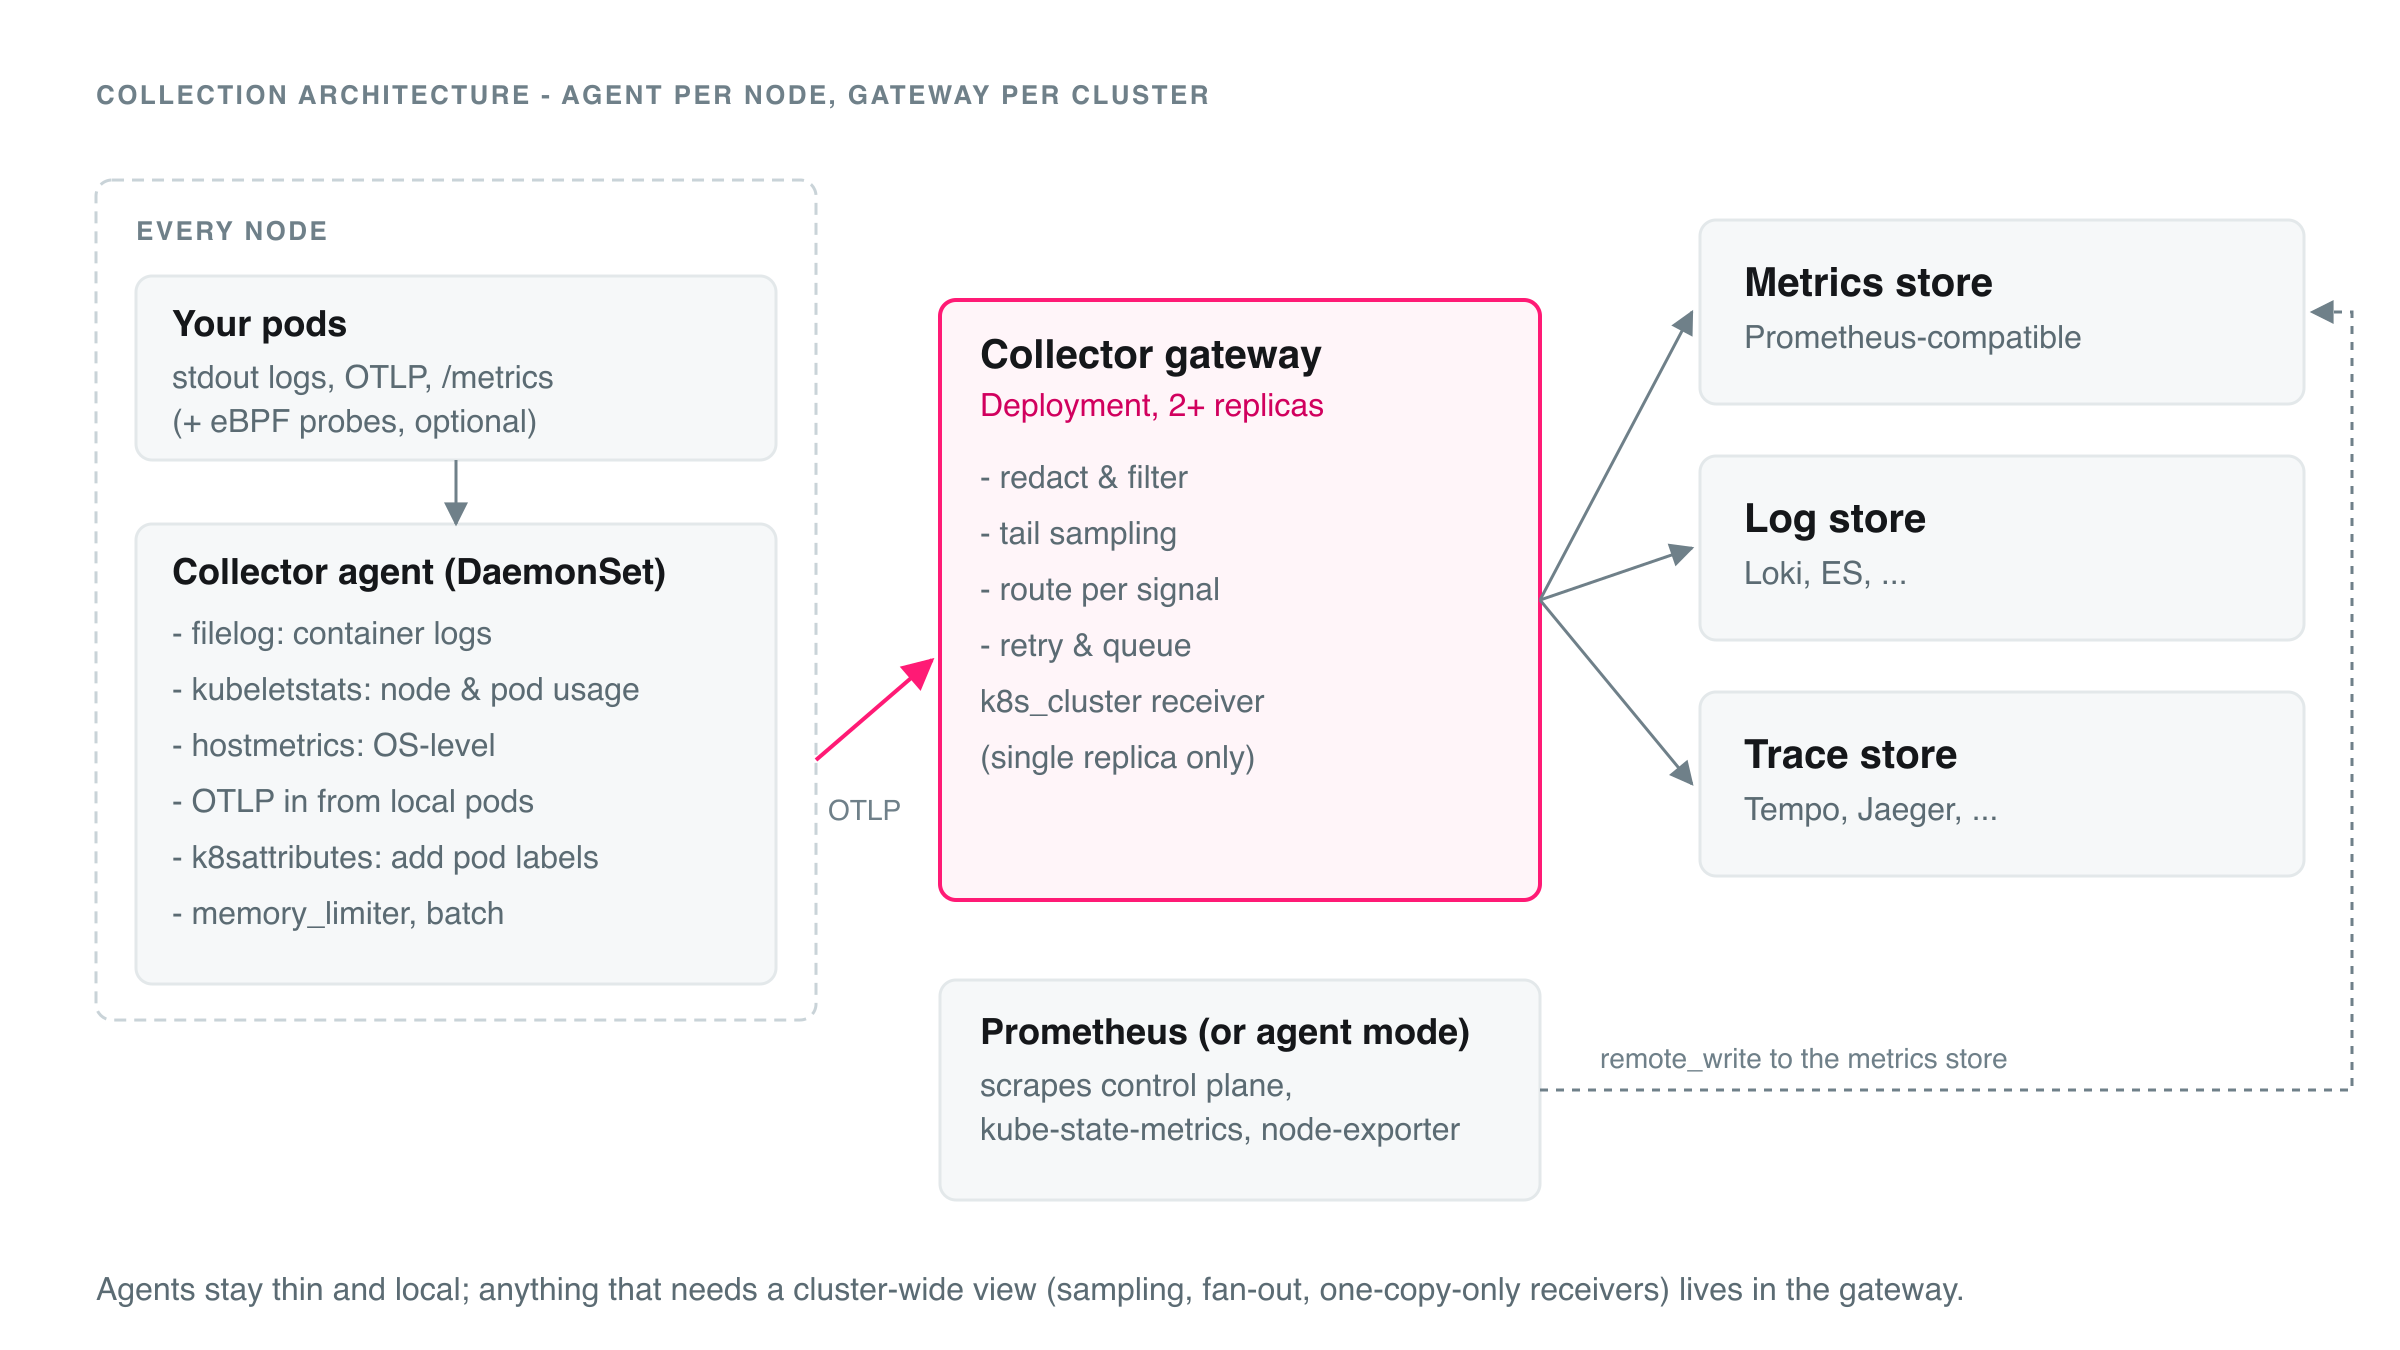
Drei Arten von Arbeit passen nicht zu «ein Agent pro Node»:
- Cluster-weite Scrape-Ziele. API Server, Scheduler, Controller Manager, CoreDNS, etcd und kube-state-metrics gibt es einmal pro Cluster. Scrapt sie jeder DaemonSet-Agent, bekommt man N Kopien jeder Serie. Man scrapt sie mit genau einem Collector oder shardet die Ziele über Replicas: Collector Clustering oder der OpenTelemetry Target Allocator mit dem Operator.
- Events und Cluster-Level-Receiver. Kubernetes-Events und Receiver wie
k8s_clustersind ebenfalls Cluster-weit; sie brauchen einen Singleton-Collector mit einer Replica. - Tail Sampling. Ein Tail Sampler entscheidet, nachdem ein Trace abgeschlossen ist, daher müssen alle Spans eines Traces denselben Sampler erreichen. Vor die Sampler gehört Trace-ID-bewusstes Load Balancing (der
loadbalancing-Exporter).
Die Referenzimplementierung (Grafanas k8s-monitoring Helm Chart, ein weit verbreitetes) betreibt Collectors nach Rolle:
| Rolle | Form | Sammelt | Warum getrennt |
|---|---|---|---|
| Metrics | Geclustert, skalierbar | Control Plane, Kubelet, cAdvisor, kube-state-metrics, annotierte Pods | Die Ziele werden über Replicas verteilt, sodass nichts doppelt gescrapt wird |
| Logs | DaemonSet | Pod-Logs, Node-Journal | Braucht Host-Dateien auf jedem Node |
| Receiver | Deployment oder DaemonSet | OTLP von Applikationen | Skaliert mit dem Traffic, nicht mit den Nodes |
| Singleton | Eine Replica | Cluster-Events | Cluster-weit, darf nicht dupliziert werden |
| Profiles | DaemonSet | Profiling-Daten | Node-lokal, braucht Privilegien |
| Sampler (optional) | Deployment hinter einem Load Balancer | Tail-gesampelte Traces | Trace-ID-Routing zu genau einem Sampler pro Trace |
Dieselbe Form erreicht man mit einfachen OpenTelemetry Collectors oder mit Prometheus als Scraper. Es geht um die Rollen, nicht um das Produkt. Und wenn die Plattform bereits Prometheus, kube-state-metrics und node-exporter mitbringt (OpenShift, Rancher Monitoring, KKP), zapft man diesen Stack an oder schreibt per Remote Write daraus, statt doppelt einzusammeln.
Eine Agent-Konfiguration als Skizze
receivers:
  otlp:
    protocols: { grpc: {}, http: {} }
  kubeletstats:
    collection_interval: 30s
    auth_type: serviceAccount
    endpoint: "https://${env:K8S_NODE_NAME}:10250"
    insecure_skip_verify: true          # kubelet certs are often self-signed; prefer a real CA
  hostmetrics:
    collection_interval: 30s
    scrapers: { cpu: {}, memory: {}, filesystem: {}, network: {}, load: {} }
  filelog:
    include: [ /var/log/pods/*/*/*.log ]
    exclude: [ /var/log/pods/observability_*/*/*.log ]   # not the collector itself
    include_file_path: true
    operators:
      - type: container                 # containerd / CRI-O / Docker log formats

processors:
  memory_limiter: { check_interval: 1s, limit_percentage: 80, spike_limit_percentage: 25 }
  k8sattributes: {}                     # configured in the next chapter
  batch: {}

exporters:
  otlp:
    endpoint: otel-gateway.observability.svc:4317
    tls: { insecure: true }             # in-cluster; use mTLS if your policy requires it

service:
  pipelines:
    metrics: { receivers: [ otlp, kubeletstats, hostmetrics ], processors: [ memory_limiter, k8sattributes, batch ], exporters: [ otlp ] }
    logs:    { receivers: [ otlp, filelog ],                   processors: [ memory_limiter, k8sattributes, batch ], exporters: [ otlp ] }
    traces:  { receivers: [ otlp ],                            processors: [ memory_limiter, k8sattributes, batch ], exporters: [ otlp ] }
Der Agent braucht den Node-Namen als Umgebungsvariable (Downward-API-Feld spec.nodeName). Den Monitor selbst überwachen: die eigenen Metriken des Collectors scrapen (Queue-Grösse, fehlgeschlagene Exporte, abgelehnte Daten), auf ausgefallene Scrape-Ziele alarmieren und einen Watchdog-Alert ergänzen, der immer feuert, damit Stille am Pager bedeutet, dass die Alert-Kette kaputt ist.
Kubernetes-Kontext mit k8sattributes anreichern
Eine Frage in fast jedem ersten Dashboard: «Ich sehe die CPU pro Pod, aber wie sehe ich sie pro Deployment?» Die Antwort steht nicht in der Metrik selbst.
Das Problem
Der kubeletstats-Receiver liefert die Nutzung mit einigen Resource Attributes: k8s.pod.uid, k8s.pod.name und k8s.namespace.name. Das Kubelet weiss nicht, welches Deployment, StatefulSet oder welcher CronJob den Pod erstellt hat, also existiert k8s.deployment.name noch nicht. Der k8sattributes-Processor ergänzt es.
So funktioniert es
- Er beobachtet Pods (und wo nötig ReplicaSets) über die API und hält einen lokalen Cache.
- Association entscheidet, zu welchem Pod ein Datenpunkt gehört, anhand geordneter
pod_association-Regeln: Für Kubelet-Metriken matcht man auf das Resource Attributek8s.pod.uid; für OTLP von Applikationen fällt man auf die Quell-IP der Verbindung zurück. Ohne Regeln assoziiert der Processor nur über die Verbindungs-IP, weshalb Kubelet-Metriken eine explizite Regel brauchen. - Owner Resolution folgt Pod, ReplicaSet, Deployment. Laut Dokumentation des Processors wird der Deployment-Name aus dem ReplicaSet-Namen abgeleitet, indem der Pod-Template-Hash entfernt wird, und man muss
k8s.deployment.nameinextract.metadataaufführen, damit es geschrieben wird. Derselbe Mechanismus liefert StatefulSet-, DaemonSet-, CronJob- und Node-Namen sowie ausgewählte Labels und Annotationen.
processors:
  k8sattributes:
    auth_type: serviceAccount
    filter:
      node_from_env_var: K8S_NODE_NAME  # only pods on this node
    extract:
      metadata: [ k8s.namespace.name, k8s.pod.name, k8s.pod.uid,
                  k8s.deployment.name, k8s.statefulset.name, k8s.daemonset.name,
                  k8s.node.name ]
      labels:
        - tag_name: app
          key: app.kubernetes.io/name
          from: pod
    pod_association:
      - sources: [ { from: resource_attribute, name: k8s.pod.uid } ]   # kubelet metrics
      - sources: [ { from: connection } ]                              # OTLP from apps
Das ist eine Skizze des Attribut-Flusses; prüfen Sie sie gegen das aktuelle README des k8sattributesprocessor.
RBAC: der klassische Fallstrick
rules:
  - apiGroups: [""]
    resources: ["pods", "namespaces", "nodes"]
    verbs: ["get", "list", "watch"]
  - apiGroups: ["apps"]
    resources: ["replicasets"]
    verbs: ["get", "list", "watch"]
Unvollständiges RBAC bricht die Pipeline nicht; es lässt Attribute fehlen, und der einzige Beleg sind «forbidden»-Fehler im Collector-Log. Ist k8s.deployment.name leer, prüft man die replicasets-Berechtigung und ob das Attribut in extract.metadata steht. Man macht «jede Pod-Metrik trägt einen Workload-Owner-Namen» zu einer Prüfung, die man nach jeder Änderung am Collector oder an seinem RBAC durchführt.
Association Keys sind keine Export Keys
k8s.pod.uid ist der ideale Schlüssel für die Association und ein schlechter zum Behalten: Er ändert sich mit jedem Pod. Man assoziiert damit und entfernt ihn vor dem Export, zusammen mit anderen Attributen mit hoher Fluktuation. Die Referenzimplementierung liefert eine Default Remove List: process.pid, process.parent_pid, process.executable.path, process.command_line, process.command_args, process.owner, process.runtime.version, process.runtime.description, host.ip, host.mac, k8s.pod.start_time, k8s.pod.uid, container.image.id, container.image.repo_digests, os.description und os.build_id. Das macht man einmal, nach der Anreicherung und vor dem letzten Export-Hop:
processors:
  resource/drop_noisy:
    attributes:
      - { key: k8s.pod.uid, action: delete }
      - { key: process.pid, action: delete }
      - { key: process.command_line, action: delete }
      - { key: container.image.id, action: delete }
Resource Attributes sind keine Metrik-Labels
Selbst wenn das Attribut vorhanden ist, findet man es bei der Abfrage vielleicht nicht. Resource Attributes beschreiben, woher Daten stammen; Prometheus-Labels sind das, wonach man filtert und gruppiert. Bei den Prometheus- und Remote-Write-Exportern landen Resource Attributes standardmässig nur in einer target_info-Metrik, die man zur Abfragezeit joint. resource_to_telemetry_conversion: { enabled: true } macht alle zu Labels auf jeder Serie, was funktioniert und Kardinalität kostet. Bei OTLP-nativer Ingestion kann Prometheus 3.x eine gewählte Liste befördern (promote_resource_attributes unter otlp), und Grafana Mimir hat eine ähnliche Option (-distributor.otel-promote-resource-attributes, zum Zeitpunkt des Schreibens experimentell); auch der transform-Processor kann nur das kopieren, was man braucht. Man befördert nur, wonach man filtert, typischerweise Namespace, Deployment und Node, und prüft die Optionsnamen gegen die eigene Version.
Der reine Prometheus-Weg
Ohne OpenTelemetry gibt es kein Deployment-Label auf cAdvisor-Metriken. Man joint zur Abfragezeit mit kube-state-metrics: kube_pod_owner ordnet Pods ReplicaSets zu, und kube_replicaset_owner ordnet ReplicaSets Deployments zu.
sum by (namespace, deployment) (
  sum by (namespace, replicaset) (
      sum by (namespace, pod) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))
    * on (namespace, pod) group_left (replicaset)
      label_replace(kube_pod_owner{owner_kind="ReplicaSet"}, "replicaset", "$1", "owner_name", "(.+)")
  )
  * on (namespace, replicaset) group_left (deployment)
    label_replace(kube_replicaset_owner{owner_kind="Deployment"}, "deployment", "$1", "owner_name", "(.+)")
)
Das funktioniert, aber man schreibt, wartet und bezahlt den Join bei jeder Abfrage. Einmal im Collector anzureichern verlagert diese Kosten auf die Ingestion; die Wahl der beförderten Attribute legt dann das Label-Set fest.
eBPF-Auto-Instrumentierung und Profiling
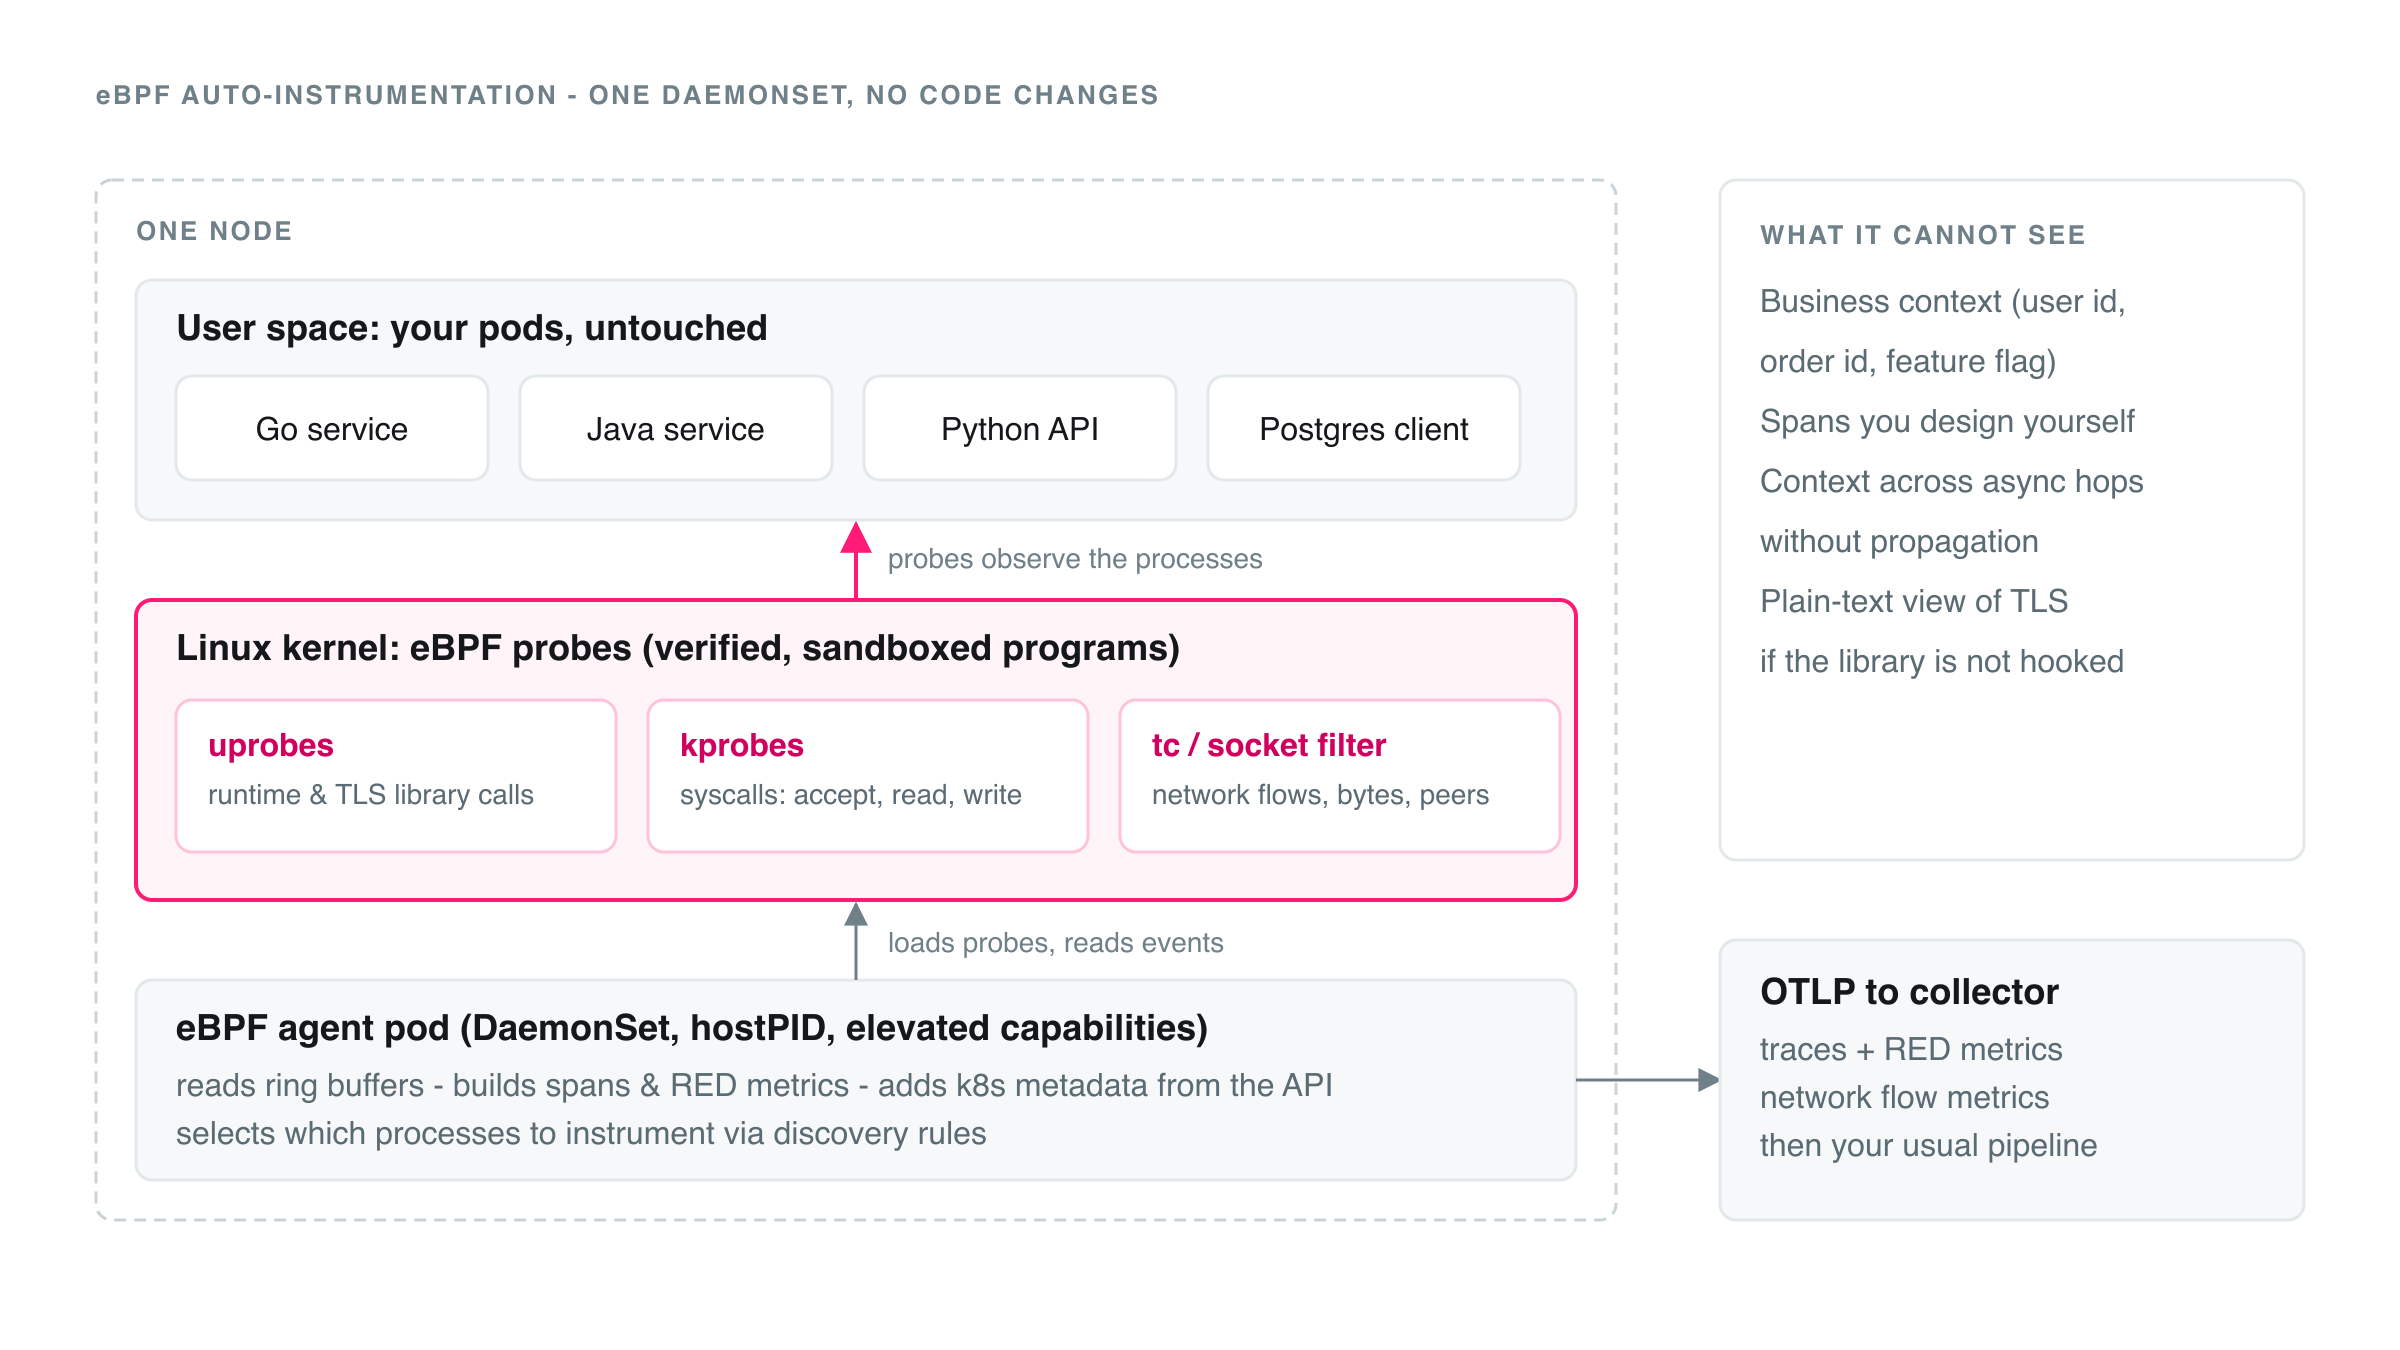
eBPF lässt kleine, verifizierte Programme im Linux-Kernel laufen und sich an User-Space-Bibliotheksfunktionen (Uprobes), Kernel-Funktionen und Systemaufrufe (Kprobes) und den Netzwerkpfad hängen. Ein Agent, der sie lädt, sieht jeden Prozess auf dem Node, ohne einen davon zu verändern. In Kubernetes entspricht das einem DaemonSet: ein Agent pro Node, keine Sidecars, keine Restarts. Die Besonderheit, die es hierher und nicht in ein Layer-Kapitel stellt: eBPF läuft im Infrastruktur-Layer, liefert aber Telemetrie auf Applikationsebene, APM ohne Code-Änderungen. Unten eingesammelt, oben genutzt.
Was man bekommt
- Zero-Code-Traces und RED-Metriken für HTTP, HTTP/2, gRPC und gängige Datenspeicher und Broker (das OpenTelemetry-eBPF-Projekt nennt PostgreSQL, MySQL, Redis, MongoDB, Kafka und weitere), für Go, Java, Python, Node.js, .NET, Rust und C/C++.
- Netzwerk-Flows: wer mit wem spricht, zwischen welchen Pods, Services und Nodes; die schnellste Service Map eines Clusters, den man nicht selbst gebaut hat.
- Continuous Profiling als viertes Signal. Profile (wohin die CPU-Zeit geht, als Flame Graphs) gesellen sich zu Metriken, Logs und Traces. eBPF-Profiler samplen Stack Traces über den ganzen Node ohne Code-Änderungen; Parca und Grafana Pyroscope sind die Open-Source-Optionen, und die Referenzimplementierung unterstützt zusätzlich Java- und pprof-Profiling.
Die wichtigsten Open-Source-Werkzeuge: OpenTelemetry eBPF Instrumentation (OBI), die Upstream-Zero-Code-Auto-Instrumentierung, die aus Grafana Beyla hervorgegangen ist (ihre Dokumentation nennt zum Zeitpunkt des Schreibens ein 0.x-Release, also Versionen pinnen); Cilium Hubble für Netzwerk-Flows auf Cilium-Clustern; Pixie, ein CNCF-Sandbox-Projekt, das erfasste Requests im Cluster behält; Parca und Pyroscope fürs Profiling; Tetragon für Runtime Security.
Voraussetzungen: Kernel und Privilegien
Für OBI nennt die Dokumentation Linux 5.8 oder neuer mit BTF (Kernel der Red-Hat-Familie mit 4.18 und Backports funktionieren ebenfalls), auf amd64 oder arm64; die Weitergabe von Trace Context auf Netzwerkebene braucht laut Dokumentation 5.17 oder neuer. Der Agent braucht CAP_BPF und, je nach Funktionen und Host-Einstellungen, CAP_PERFMON (oder CAP_SYS_ADMIN, wo perf_event_paranoid restriktiv ist), CAP_SYS_PTRACE, CAP_NET_RAW und einige weitere, dazu hostPID: true. Das einfachste Manifest startet den Container privilegiert; ein strengeres listet nur die nötigen Capabilities auf. Man rechnet mit einer Pod-Security-Ausnahme für seinen Namespace, damit, dass serverlose Node Pools (Fargate oder Autopilot-Stil) ihn ausschliessen, und auf OpenShift mit einer Security Context Constraint, die privileged, hostPath und hostNetwork erlaubt. Den Agent behandelt man als hochwertiges Ziel: Image pinnen und scannen und einschränken, wer das DaemonSet bearbeiten darf.
Ein DaemonSet-Beispiel
Die Skizze folgt der Form des Upstream-OBI-Kubernetes-Beispiels. Sie ist ein Ausgangspunkt: Version pinnen, die Upstream-Dokumentation lesen und auf einem Testcluster verifizieren. Sie braucht ausserdem einen ServiceAccount, dessen Rolle Pods, Services, Nodes und ReplicaSets für die Kubernetes-Metadaten listen und beobachten darf.
apiVersion: apps/v1
kind: DaemonSet
metadata: { name: obi, namespace: observability }
spec:
  selector: { matchLabels: { app: obi } }
  template:
    metadata: { labels: { app: obi } }
    spec:
      serviceAccountName: obi
      hostPID: true                     # see processes on the host
      containers:
        - name: obi
          image: otel/ebpf-instrument:<pinned-version>
          securityContext:
            privileged: true            # or: a capability list, see text
          env:
            - name: OTEL_EBPF_AUTO_TARGET_EXE        # which executables to instrument
              value: "*/my-service"
            - name: OTEL_EBPF_KUBE_METADATA_ENABLE   # add pod, namespace, node attributes
              value: "true"
            - name: OTEL_EXPORTER_OTLP_ENDPOINT      # the collector, not a backend
              value: "http://otel-agent.observability:4318"
Den Agent richtet man auf den lokalen Collector aus, nicht auf ein Backend, und wählt Services explizit aus statt «alles».
Betrieb und Grenzen
- Ein zentraler Metadata Cache. Beobachtet jeder DaemonSet-Pod die API für Pod-Metadaten, zahlt ein grosser Cluster das N-fach. Die Referenzimplementierung deployt für ihre eBPF-Agents ein separates Kubernetes-Cache-Deployment (Default-Ausgangspunkt: eine Replica pro 50 Nodes).
- Port-Konflikte bei hostNetwork. Manche eBPF-Agents laufen mit
hostNetwork: trueund binden auf jedem Node einen Port; zwei solche DaemonSets oder ein fremder Workload auf demselben Host-Port kollidieren. Ports plant man wie eine geteilte Ressource. - Overhead hängt vom Workload ab, und wir nennen keine Zahl: Man misst CPU und Memory des Agents pro Node und die Wirkung auf den meistbelasteten Service, bevor man breit ausrollt.
- Blinde Flecken. Verschlüsselter Traffic ist nur dort sichtbar, wo Probes die Bibliothek anhängen, die ihn verarbeitet (gängige TLS-Bibliotheken, Go-crypto/tls). Aufrufe zu einem Trace zu verknüpfen braucht Trace Context in den Requests: Der Agent kann einen vorhandenen
traceparentlesen, einen zu erzeugen braucht die privilegierteren Propagation-Funktionen, und asynchrone Hops bleiben schwierig. Er kann nicht wissen, welcher Kunde, welche Bestellung oder welches Feature Flag hinter einem Request steht. eBPF dient der Grundabdeckung und der Service Map, SDKs dort, wo Kontext sich auszahlt; beide sprechen OTLP. - Route-Muster konfigurieren, sodass
/orders/123zu/orders/{id}wird, und den Agent bei jedem Node-Image-Upgrade testen. Zu einer früheren Generation der Auto-Instrumentierung siehe Application observability: tracing with auto-instrumentation (auf Englisch).
Kardinalität und Kosten
Jede eindeutige Label-Kombination ist eine neue Zeitreihe, und Kubernetes wechselt laufend Identifikatoren: Jeder Rollout erzeugt neue Pod-Namen. Kardinalität ist der häufigste Grund, warum eine Monitoring-Rechnung oder ein Backend umfällt, deshalb gibt man ihr von Anfang an ein Budget:
- Nie unbegrenzte Werte als Labels verwenden: User-IDs, Request-IDs, vollständige URLs, rohe Fehlermeldungen. Stabile Identitäten (Deployment, Service) vor flüchtigen (Pod-UID) bevorzugen und fluktuierende Resource Attributes vor dem Export entfernen.
- Am Rand per Allow List freigeben, was man nutzt, ein Serien-Budget pro Team oder Namespace setzen und ganze Namespaces pro Quelle ein- oder ausschliessen. Recording Rules machen teure Abfragen billig; Advanced Prometheus Querying (auf Englisch) zeigt Muster für unbequeme Daten.
Das minimale Metrik-Set
Allow Lists sind der wirksamste Kostenhebel. Diese Tabelle ist die einzige Stelle, die die unverzichtbaren Serien pro Quelle nennt; die Layer-Kapitel erklären, warum jede wichtig ist. Sie stützt sich auf die bewusst minimalen Defaults der Referenzimplementierung (cAdvisor 19 Metriken, kube-state-metrics 43 Muster, Kubelet 36, node-exporter 10) und auf einen Keep-Regex aus einem echten Setup: Das Minimum als Keep-Regex zu schreiben ist die Art, es durchzusetzen.
| Quelle | Unverzichtbare Metriken | Eingesammelt durch | Hinweis |
|---|---|---|---|
| node-exporter | node_cpu_seconds_total, node_memory_MemTotal_bytes und _MemAvailable_bytes, node_filesystem_size_bytes und _avail_bytes, node_disk_io_time_seconds_total, node_network_{receive,transmit}_{bytes,drop}_total, node_nf_conntrack_entries und _limit, node_netstat_Tcp_RetransSegs, node_pressure_* | node-exporter oder der hostmetrics-Receiver des Collectors | Der Default der Referenz behält 10 Muster (kein Conntrack, kein Netstat, keine PSI): ergänzen. _avail_bytes ist _free_bytes vorzuziehen: Free enthält für root reservierte Blöcke, Avail ist das, was Workloads nutzen können. node_cpu_core_throttles_total ist Hardware-Throttling (thermisch) aus dem cpu-Collector, nicht das CFS-Throttling von Containern. instance_device:node_disk_io_time_seconds:rate1m ist eine Recording Rule aus dem node-mixin und nur vorhanden, wenn dessen Regeln geladen sind; die Rohmetrik ist node_disk_io_time_seconds_total. hostmetrics verwendet system.*-Namen und deckt vielleicht nicht alles davon ab. |
| Kubelet | kubelet_pleg_relist_duration_seconds, kubelet_pod_start_duration_seconds, kubelet_runtime_operations_errors_total, kubelet_volume_stats_used_bytes, _capacity_bytes, _available_bytes, _inodes, _inodes_used | Scrape des Kubelet-/metrics; kubeletstats-Receiver für Volumes | Volume-Serien gibt es nur, wenn der CSI-Treiber NodeGetVolumeStats implementiert; sonst existieren sie stillschweigend nicht. Die kubeletstats-Entsprechungen sind k8s.volume.available, capacity, inodes, inodes.free, inodes.used. |
| cAdvisor | Die 19 Serien unten, plus container_cpu_cfs_throttled_seconds_total, machine_cpu_cores und die sechs container_pressure_*-PSI-Serien | Scrape des Kubelet-/metrics/cadvisor | container_memory_usage_bytes enthält den Page Cache; der OOM Killer reagiert auf container_memory_working_set_bytes. PSI ist Opt-in, siehe unten. |
| kube-state-metrics | kube_deployment_spec_replicas und kube_deployment_status_replicas_{available,ready,unavailable}, kube_pod_status_phase, kube_pod_container_status_*, kube_pod_owner, kube_node_status_*, kube_pod_container_resource_requests und _limits, kube_persistentvolumeclaim_status_phase, kube_horizontalpodautoscaler_*, kube_resourcequota, kube_namespace_created, kube_job_status_failed | Scrape, durch genau einen Collector | Labels brauchen eine explizite Allow List. |
| Control Plane | apiserver_request_total und _duration_seconds; etcd_server_has_leader, etcd_server_leader_changes_seen_total, etcd_disk_backend_commit_duration_seconds und etcd_disk_wal_fsync_duration_seconds; scheduler_pending_pods; workqueue_depth, workqueue_queue_duration_seconds | Scrape (in der Referenz standardmässig aus; etcd auf eigenem Port) | Gehostete Plattformen legen nur einen Teil offen (Layer 3). |
| CoreDNS | coredns_dns_request_duration_seconds, coredns_dns_responses_total (nach rcode) | Scrape | Die Cache Hit Ratio ergänzen, wenn man DNS tunt. |
| Collection | up (Scrape-Gesundheit pro Ziel); optional prometheus_operator_ready | Scrape | Die Basis von «Scrape-Ziel ausgefallen». Die Operator-Metrik ist nur relevant, wenn man den Prometheus Operator betreibt. |
| Events (keine Metriken) | Warning Reasons: FailedScheduling, BackOff, Unhealthy, FailedMount, FailedAttachVolume, Evicted, FailedCreatePodSandBox, NodeNotReady; OOMKilling, wenn node-problem-detector läuft | k8sobjects-Receiver, Watch-Modus, Singleton | Wiederholungen kommen als ein Event mit Count. OOMKilling stammt vom Kernel-Monitor des node-problem-detector, nicht von Kubernetes selbst. |
Die 19 cAdvisor-Serien, die die Referenzimplementierung standardmässig behält, ein gutes Start-Budget:
container_cpu_cfs_periods_total          container_memory_cache
container_cpu_cfs_throttled_periods_total container_memory_rss
container_cpu_usage_seconds_total        container_memory_swap
container_fs_reads_bytes_total           container_memory_usage_bytes
container_fs_reads_total                 container_memory_working_set_bytes
container_fs_writes_bytes_total          container_network_receive_bytes_total
container_fs_writes_total                container_network_receive_packets_dropped_total
container_network_receive_packets_total  container_network_transmit_bytes_total
container_network_transmit_packets_dropped_total
container_network_transmit_packets_total  machine_memory_bytes
Container-PSI. Pressure Stall Information misst die Zeit, die Tasks beim Warten auf eine Ressource verlieren, was Nutzungs- und Throttling-Counter nicht zeigen können. Sechs Serien: container_pressure_cpu_waiting_seconds_total, container_pressure_cpu_stalled_seconds_total und dieselben zwei für Memory und für I/O. Waiting ist das «some» des Kernels (mindestens ein Task blockiert), stalled ist «full» (alle nicht untätigen Tasks blockiert). CPU Waiting ist ein besseres «verhungert dieser Container?»-Signal als die Throttling-Quote allein, Memory Stalled warnt vor einem OOM-Kill, und I/O Stalled entdeckt lärmige Nachbarn auf einer Disk. Sie stehen nicht in der Default Allow List der Referenz, man muss sich also aktiv dafür entscheiden. Laut Kubernetes-Dokumentation brauchen sie die PSI-Unterstützung des Kubelets (das Feature Gate KubeletPSI: alpha in 1.33, beta in 1.34, stable und fest eingeschaltet in 1.36; prüfen Sie Ihre Version), cgroup v2 und einen Kernel mit aktivierter PSI (4.20 oder neuer; manche Distributionen brauchen psi=1 auf der Kernel-Kommandozeile). Zwei Vorbehalte: Sie gelten pro Container, man achte also auf die Kardinalität, und ein Node ohne PSI kann Nullen statt nichts melden, Null ist also kein Beweis für Gesundheit.
Optionale Extras. OpenCost macht aus Nutzung und Preisen eine Kostenzuordnung nach Namespace und Workload, und Kepler schätzt den Energieverbrauch pro Node und Pod; beide sind separate Exporter mit eigenen Allow Lists.
Teil 3: Alarmieren, planen und handeln
Alerting
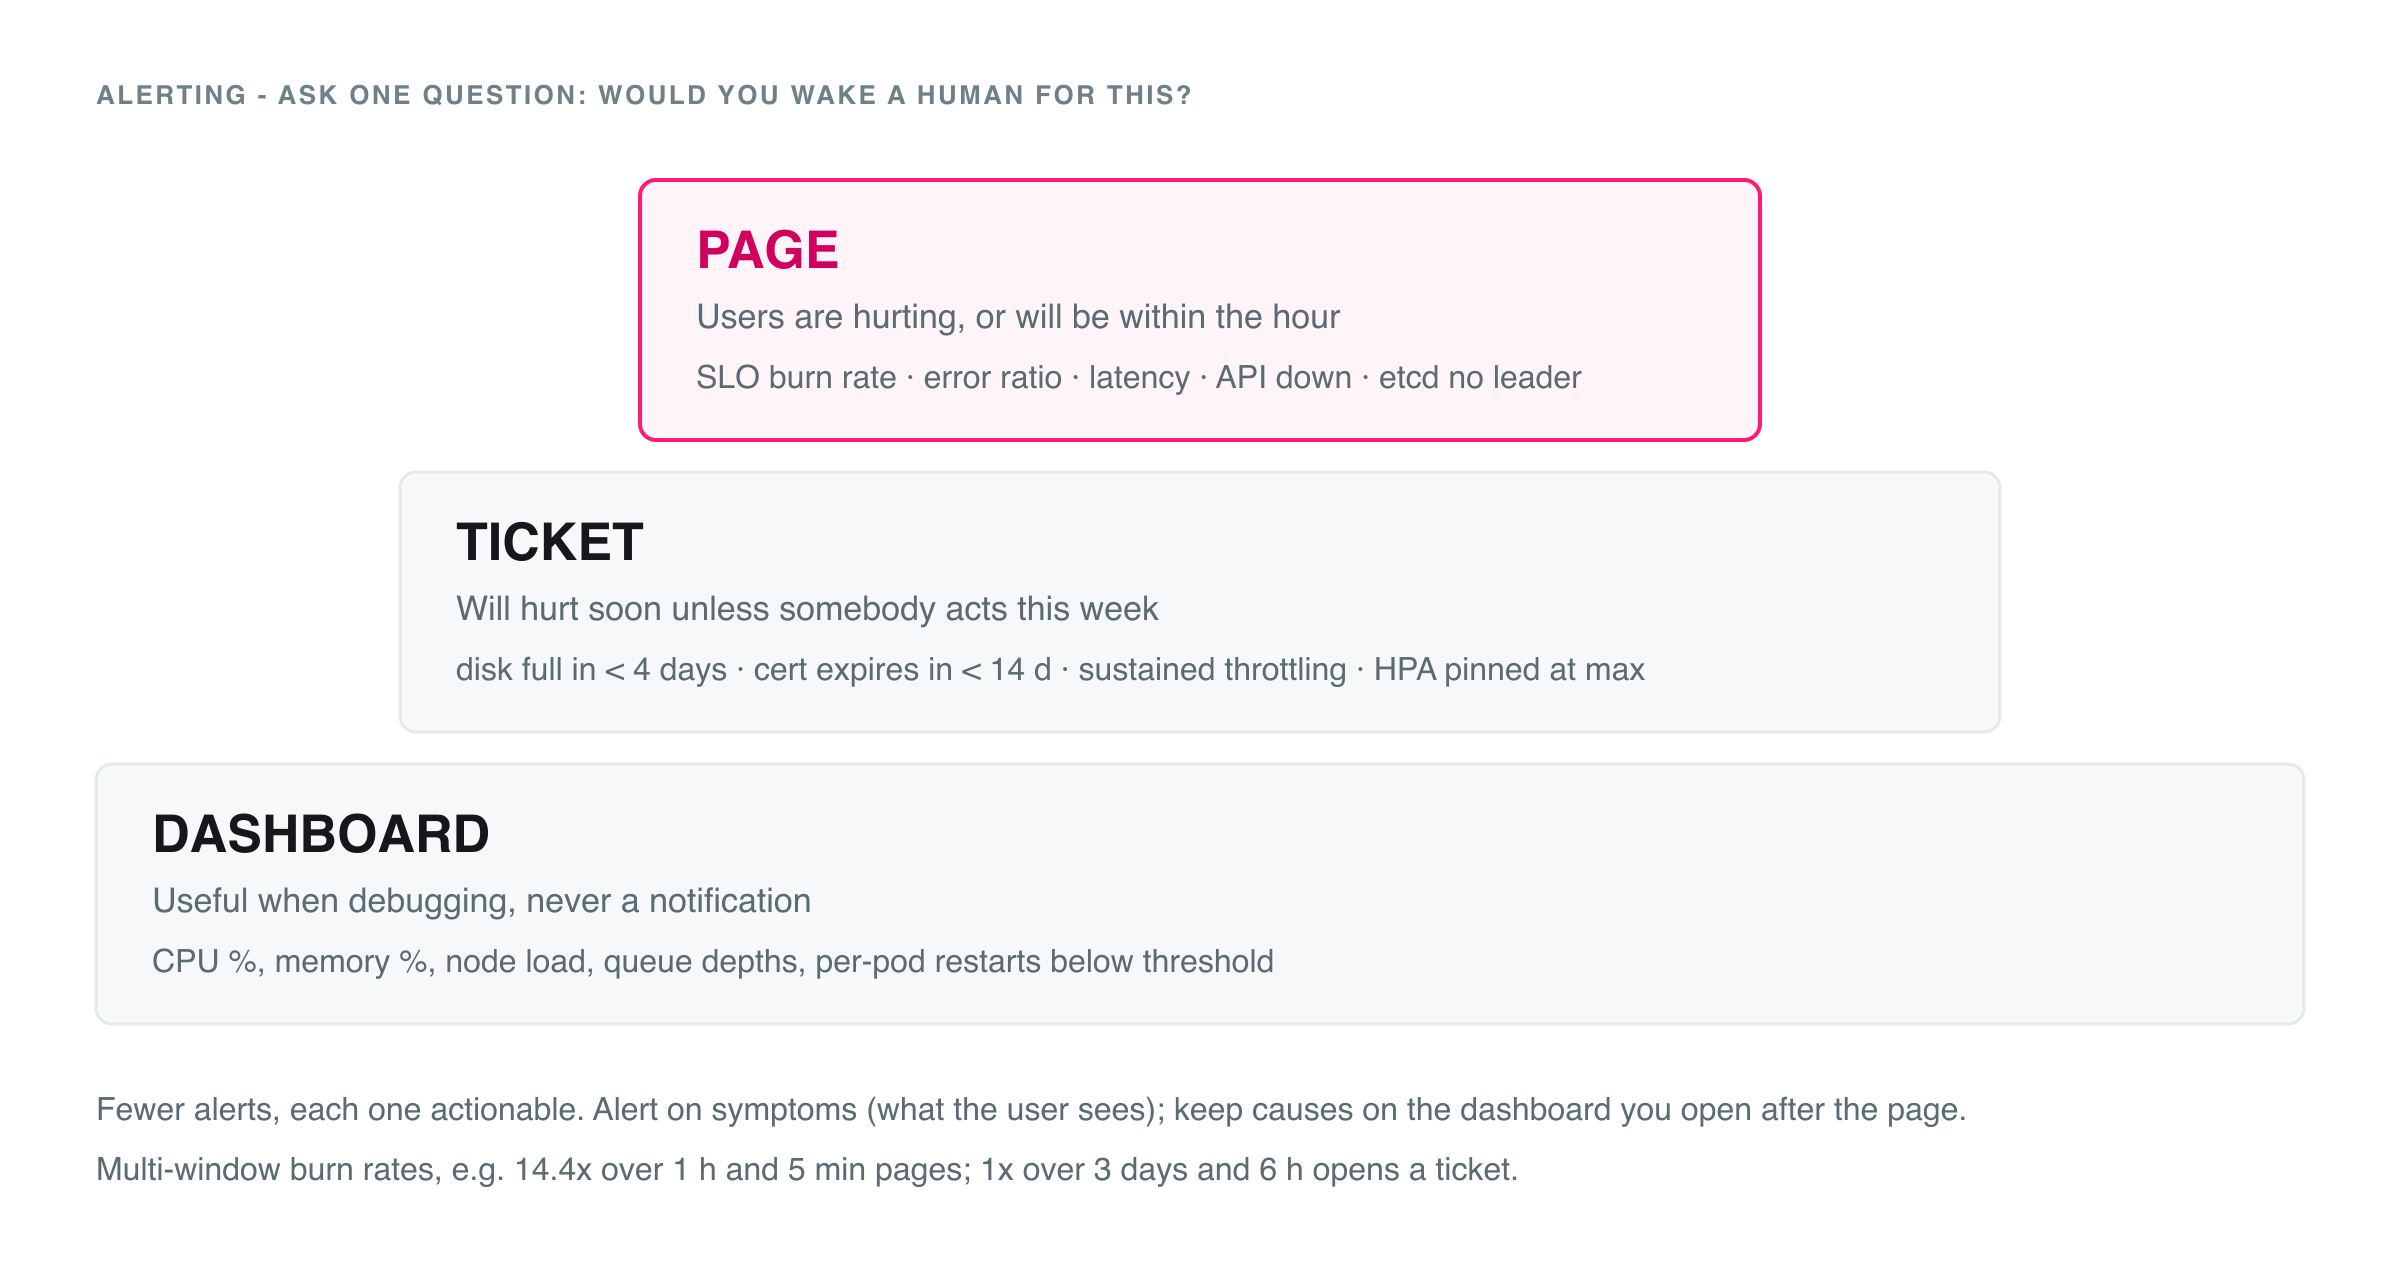
Man alarmiert auf Symptome und diagnostiziert mit Ursachen: Pages kommen fast nur aus der Application Observability (benutzernahe Symptome, SLO-Burn), während die Ursachen in der Platform und Infrastructure Observability liegen, auf Dashboards und in Tickets. Layer 3 löst nur bei einem ausgefallenen oder fehlerhaften API Server oder einem etcd ohne Leader eine Page aus, und Disk- und Kapazitäts-Alerts sollten vorausschauend sein (predict_linear), damit man sie bei Tageslicht behebt. Die Tabelle ist eine kuratierte Auswahl in Paging-Reihenfolge, mit den drei Stufen aus Abbildung 7. Für den langen Schwanz startet man beim kubernetes-mixin, dem De-facto-Standard-Regelwerk hinter kube-prometheus; die Referenzimplementierung liefert keine Alert-Regeln, sie synchronisiert nur PrometheusRule-Objekte.
| Alert | Ausdruck (kurz) | Stufe | For |
|---|---|---|---|
| Layer 5: Workloads | |||
| SLO Fast Burn | Fehlerquote über dem 14,4-Fachen des Budgets über 1h und 5m (99,9-%-SLO) | Page | - |
| SLO Slow Burn | Über dem 3-Fachen über 1d und 2h | Ticket | - |
| Crash Loop oder OOM-Kill | Waiting Reason CrashLoopBackOff oder Restarts mit Last Terminated Reason OOMKilled | Ticket | 15m |
| CPU-Throttling-Quote | rate(cfs_throttled_periods) / rate(cfs_periods) > 0.25 | Dashboard | - |
| Layer 4: Cluster State | |||
| Deployment nicht verfügbar | Spec Replicas weichen von Available Replicas ab | Ticket | 15m |
| Pods hängen in Pending | kube_pod_status_phase{phase="Pending"} > 0 | Ticket | 15m |
| HPA am Maximum, Job fehlgeschlagen | Current Replicas gleich Max Replicas; kube_job_status_failed > 0 | Ticket | 15m |
| Wiederholte FailedMount oder FailedCreatePodSandBox | Warning-Events mit diesem Reason, Count steigt für dasselbe Objekt | Ticket | 15m |
| Warning-Events | Warning-Events pro Reason und Namespace | Dashboard | - |
| Layer 3: Control Plane | |||
| API Server down oder fehlerhaft | up{job="apiserver"} == 0 oder 5xx-Quote über 1 % | Page | 2-10m |
| etcd ohne Leader | etcd_server_has_leader == 0 | Page | 1m |
| etcd mit langsamer Disk oder Leader-Wechseln | WAL fsync p99 über 10 ms; über 3 Leader-Wechsel pro Stunde | Ticket | 10m |
| Zertifikate laufen ab | Ablauf des API-Server-Client-Zertifikats in unter 7 Tagen | Ticket | - |
| Unerwartete Deletes | Audit-Log-Abfrage: Delete auf Deployments oder Namespaces in Produktion durch einen unerwarteten User | Ticket | - |
| API-Latenz, Queues, Scheduler | Request p99 pro Verb, workqueue_depth, scheduler_pending_pods | Dashboard | - |
| Layer 2: Nodes | |||
| Node not ready oder unter Pressure (Page, wenn mehrere) | Ready false oder eine Pressure Condition true | Ticket | 10m |
| Volume füllt sich | predict_linear(kubelet_volume_stats_available_bytes[6h], 4*86400) < 0 | Ticket | - |
| Anhaltender Container Memory Stall | rate(container_pressure_memory_stalled_seconds_total[5m]) über einem kleinen Anteil (zum Beispiel 0.05) | Ticket | 15m |
| Container-CPU- oder I/O-Pressure, Kubelet-Gesundheit | PSI-Waiting-Raten; PLEG Relist p99, Pod Start p99, Runtime-Fehler | Dashboard | - |
| Layer 1: Hardware und Kernel | |||
| Disk oder Inodes füllen sich | predict_linear(node_filesystem_avail_bytes[6h], 4*86400) < 0, dasselbe für files_free | Ticket | 1h |
| Conntrack fast voll | Einträge über 80 % des Limits | Ticket | 10m |
| CPU, Memory, I/O pro Node | Auslastung und Pressure pro Node | Dashboard | - |
| Netzwerk | |||
| Service ohne bereite Endpoints (Produktion) | kube_endpoint_info unless on(namespace,endpoint) kube_endpoint_address{ready="true"} | Page | 5m |
| Ingress-5xx-Quote (Ticket, ausser sie ist das benutzernahe SLO) | 5xx über alle Requests pro Host über 1 %; Namen variieren je nach Controller | Page | 10m |
| Zertifikat läuft in unter 14 Tagen ab | certmanager_certificate_expiration_timestamp_seconds - time() < 14*86400 | Ticket | - |
| CoreDNS-Fehler | SERVFAIL-Quote über 1 % | Ticket | 10m |
| TCP-Retransmits, Policy-Drops, zonenübergreifende Flows | node_netstat_Tcp_RetransSegs-Rate, hubble_drop_total nach Reason | Dashboard | - |
| Kapazität | |||
| Requests-Commitment über 80 % | Requests laufender Pods über Allocatable, CPU oder Memory | Ticket | 1h |
| Kein N+1-Headroom | Requests über (Allocatable minus der grösste Node) grösser als 1 | Ticket | 1h |
| ResourceQuota über 90 % | Used über Hard, kube_resourcequota | Ticket | 15m |
| Pods pro Node über 90 % | Laufende Pods über Allocatable Pods pro Node | Ticket | - |
| PVC zu über 85 % belegt | kubelet_volume_stats_used_bytes / kubelet_volume_stats_capacity_bytes > 0.85 | Ticket | 15m |
| Limits-Overcommit, Verschwendung | Limits über Allocatable; Requests gegenüber tatsächlicher Nutzung | Dashboard | - |
| Collection | |||
| Scrape-Ziel ausgefallen | up == 0 | Ticket | 10m |
| Collector lehnt Daten ab, scheitert oder staut | otelcol_receiver_refused_*, otelcol_exporter_send_failed_*, Queue über 80 % der Kapazität | Ticket | 10m |
| Watchdog (löst eine Page aus, wenn er verstummt) | vector(1), feuert immer | Page | - |
Spielregeln: Jeder Alert hat einen Owner, einen Runbook-Link und eine Aktion; man verwendet for:-Dauern und Inhibition, damit nicht vierzig Pod-Alerts feuern, wenn ihr Node ausgefallen ist; man routet über ein team- oder namespace-Label; man prüft monatlich und löscht oder stuft herab, worauf niemand reagiert hat. Collector-Metriknamen variieren je nach Version, prüfen Sie also Ihre.
Kapazität und Headroom
Worum es geht
Wenn die Kapazität ausgeht, kündigt sich das selten an. Der Scheduler platziert Pods nach Requests, nicht nach Nutzung, ein Cluster kann also voll sein, während die CPUs im Leerlauf sind; die Folge sind Pending Pods, blockierte Rollouts oder ein Node-Verlust, der Workloads mitreisst. Kapazitäts-Monitoring beantwortet drei Fragen: wie viel sich noch platzieren lässt, wie viel verschwendet wird und was passiert, wenn ein Node oder eine Zone ausfällt.
Wichtige Signale
| Signal | Metrikbeispiel | Warum es wichtig ist |
|---|---|---|
| Allocatable gegenüber Capacity | kube_node_status_allocatable gegenüber _capacity (cpu, memory, pods, ephemeral_storage) | kube-reserved, system-reserved und die Eviction-Schwelle liegen dazwischen; man plant mit Allocatable |
| Requests-Commitment | Requests laufender Pods über Allocatable, pro Node und Cluster | Die Schlüsselzahl: was der Scheduler als voll betrachtet |
| Limits-Overcommit und Verschwendung | Limits über Allocatable; Requests gegenüber tatsächlicher Nutzung über Tage | Throttling- und OOM-Risiko, wenn alle gleichzeitig bursten; verschwendetes Geld |
| N+1-Headroom | Requests gegenüber Allocatable minus dem grössten Node oder der grössten Zone | Ob der Rest einen Ausfall auffangen kann |
| Pod-, IP- und Storage-Limits | kube_node_status_allocatable{resource="pods"} gegenüber laufenden Pods; CNI-Adresspools; Ephemeral Storage | Nodes können bei Pods oder Adressen «voll» sein, bevor es die CPU ist |
| Quotas und Autoscaler | kube_resourcequota used gegenüber hard; nicht schedulbare Pods, gescheiterte Scale-ups, Node Group am Maximum | Ein blockiertes Deployment sieht nach gar nichts aus; Elastizität funktioniert womöglich nicht |
Requests-Commitment pro Cluster, nur laufende Pods gezählt (abgeschlossene Pods behalten ihre Requests in der Metrik, man filtert sie also heraus):
sum by (resource) (
    kube_pod_container_resource_requests{resource=~"cpu|memory"}
  * on (namespace, pod) group_left ()
    (kube_pod_status_phase{phase="Running"} == 1)
)
/
sum by (resource) (kube_node_status_allocatable{resource=~"cpu|memory"})
Für die Sicht pro Node gruppiert man statt nach resource nach node; für Overcommit setzt man kube_pod_container_resource_limits ein, wo ein Verhältnis deutlich über 1 normal ist und die Frage lautet, wie weit. Der N+1-Headroom ist dieselbe Summe gegen einen kleineren Nenner: Wenn der grösste Node verschwindet, können die anderen die heutigen Requests halten?
sum(kube_pod_container_resource_requests{resource="cpu"}
    * on (namespace, pod) group_left () (kube_pod_status_phase{phase="Running"} == 1))
/
(sum(kube_node_status_allocatable{resource="cpu"}) - max(kube_node_status_allocatable{resource="cpu"}))
Über 1 heisst: Der Ausfall eines Nodes lässt Pods ohne Platz zurück. Für Zonen zieht man die Allocatable der grössten Zone ab, mit einem Zonen-Label aus kube_node_labels (per Allow List freigeben). Das ignoriert DaemonSets, Affinity, Taints und Disruption Budgets, ist aber als Frühwarnung schwer zu schlagen.
Woher die Daten kommen
- kube-state-metrics für Allocatable und Capacity, Requests und Limits, Phasen und Quotas sowie Kubelet und cAdvisor für die tatsächliche Nutzung (siehe Das minimale Metrik-Set).
- Right-Sizing-Vorschläge kommen vom Vertical Pod Autoscaler im Recommendation-Modus (
updateMode: "Off"), der empfohlene Requests berechnet, ohne etwas zu ändern. Man behandelt sie als Input für ein Review, nicht als Policy. - Der Cluster Autoscaler liefert Metriken standardmässig auf Port 8085, darunter
cluster_autoscaler_unschedulable_pods_count,cluster_autoscaler_failed_scale_ups_total,cluster_autoscaler_nodes_countundcluster_autoscaler_max_nodes_count(Namen wie in seiner Metrik-Dokumentation aufgeführt; prüfen Sie Ihre Version), dazu eine Status-ConfigMap und Events wieNotTriggerScaleUp. Eine Node Group am Maximum plus nicht schedulbare Pods heisst, dass der Autoscaler nicht helfen kann. - Forecasting:
predict_linearüber ein aufgezeichnetes Verhältnis macht aus einer Momentaufnahme einen Trend, zum Beispielpredict_linear(commitment[14d:1h], 30*24*3600) > 1, mit der Commitment-Abfrage als Subquery oder Recording Rule.
Stolperfallen
- Falsche Requests machen das Verhältnis bedeutungslos: aufgeblähte Requests sehen nach einem vollen Cluster aus, fehlende nach einem leeren. Zuerst die Requests korrigieren (Layer 5).
- Ein gesunder Durchschnitt verbirgt Fragmentierung: viele Nodes bei 70 Prozent und keiner, auf den ein grosser Pod passt.
- Pod-Dichte und Adressen können zuerst ausgehen: Manche CNIs beziehen Pod-IPs aus den Adressbereichen des Netzwerks (das AWS VPC CNI ist ein Beispiel), sodass Subnetze und nicht die CPU das Wachstum begrenzen können.
- Ein
ResourceQuota-Fehler erzeugt keinen Pending Pod, man alarmiert also auf die Quota-Nutzung, bevor sie 100 Prozent erreicht, und prüft die Kapazität wöchentlich, nicht nur wenn ein Alert feuert.
Security ist ein eigenes Thema. Ein eigener Beitrag zu Kubernetes Security Monitoring ist in Vorbereitung. Dieser Leitfaden berührt es nur dort, wo sich Monitoring überschneidet: Audit-Logs (Layer 3) und eBPF-Runtime-Sichtbarkeit. Die wichtigsten Bausteine sind Runtime Threat Detection (Regeln im Stil von Falco), Audit-Log-Analyse sowie Image- und Supply-Chain-Signale.
Best-Practices-Checkliste
Layer 1: Hardware und Kernel
- CPU, Memory, Disk (Platz und Inodes), I/O und Netzwerk-Saturation werden pro Node eingesammelt, nicht nur als Cluster-Durchschnitte; Disk- und Inode-Alerts sind vorausschauend. Kubelet-, Runtime- und Kernel-Logs kommen aus dem Node-Journal.
Layer 2: Nodes
- Kubelet und cAdvisor werden von jedem Node gescrapt, mit verworfenen Serien mit leeren Labels; CPU-Throttling, Container-PSI (wo Kernel und Kubelet es unterstützen) und das Memory Working Set werden gemessen. Volume-Metriken sind vorhanden, was bedeutet, dass der CSI-Treiber sie meldet.
- Node Conditions und Eviction-Schwellen werden alarmiert, nicht nur beobachtet.
Layer 3: Control Plane
- Man weiss, welche Komponenten man auf seiner Plattform scrapen kann (inklusive des separaten etcd-Metrik-Ports) und welche verborgen sind; externe Probes und ein Canary Workload gleichen das aus.
- Control-Plane- und Audit-Logs werden eingesammelt (bei gehosteten Clustern über den Export des Providers), mit einer Audit Policy, die Secrets nur auf Metadata-Level loggt. Security Monitoring darüber hinaus liegt ausserhalb dieses Leitfadens; ein eigener Beitrag ist in Vorbereitung.
Layer 4: Cluster State
- kube-state-metrics wird einmal gescrapt, und Warning-Events werden als Logs durch einen Singleton eingesammelt, samt ihren Counts. Rollout-Lücken, Crash Loops, OOM-Kills, Pending Pods, PVCs, HPAs, fehlgeschlagene Jobs und Quota-Nutzung sind alarmierbar.
Layer 5: Workloads
- Jeder Container hat Requests, Memory Limits sind bewusst gesetzt, Probes existieren und hängen nicht von geteilten Downstream-Services ab.
- Services liefern Rate, Errors und Duration, loggen strukturiertes JSON mit Trace-IDs und werden per Annotation, Monitor-Objekt oder Integration gescrapt.
Netzwerk
- Services ohne bereite Endpoints, Ingress-Fehler und Zertifikatsablauf werden alarmiert; DNS-Verstärkung, TCP-Retransmits und Policy-Drops stehen auf einem Dashboard.
Collection
- Agents laufen pro Node; Cluster-weite Scrape-Ziele werden einmal gescrapt oder geshardet (oder aus dem eigenen Stack der Plattform angezapft); Events und Cluster-Receiver laufen als Singletons; Tail Sampling sitzt hinter Trace-bewusstem Load Balancing.
- Jede Pod-Metrik trägt einen Workload-Owner-Namen, das RBAC für die Anreicherung (inklusive ReplicaSets) ist verifiziert, und fluktuierende Attribute wie die Pod-UID werden vor dem Export entfernt.
- Serien haben ein Budget, das minimale Metrik-Set ist die Baseline, und nur die Resource Attributes, nach denen man filtert, werden zu Labels.
- eBPF ist, falls eingesetzt, auf ausgewählte Services beschränkt, läuft mit minimalen Capabilities und wird bei jedem Node-Image-Upgrade getestet. Die Pipeline überwacht sich selbst, und ein Watchdog-Alert belegt, dass der Alert-Pfad funktioniert.
Alerting und Kapazität
- Pages beschränken sich auf Symptome, SLO-Burn und die wenigen Control-Plane-Ausfälle, die selbst Ausfälle sind; alles andere ist ein Ticket oder ein Dashboard, mit Owner, Runbook und Aktion.
- Requests-Commitment, N+1-Headroom, Quotas und Pod-Dichte werden pro Cluster und pro Node beobachtet, und die Kapazität wird wöchentlich mit einem Forecast geprüft.
Quellen und weitere Literatur
- Kubernetes-Dokumentation: Metrics for Kubernetes system components, Understand PSI metrics, Auditing und kubeadm implementation details
- etcd-Dokumentation: Metrics. Google SRE Workbook: Alerting on SLOs. kubernetes-mixin: das Standard-Set an Alerts und Dashboards hinter kube-prometheus
- Referenzimplementierung: Grafanas k8s-monitoring Helm Chart (Default Allow Lists, Collector-Rollen, Remove List), ein weit verbreitetes Beispiel für die obigen Muster
- OpenTelemetry: eBPF Instrumentation (OBI), der k8sattributes-Processor und die Receiver k8sobjects und kubeletstats
- Metrik-Referenzen: node-exporter, kube-state-metrics, cAdvisor, Cluster Autoscaler, cert-manager, Cilium Hubble, node-problem-detector und Prometheus as an OpenTelemetry backend
- Plattformen: EKS control plane logs, EKS metrics, GKE metrics, GKE logs, AKS metrics, AKS resource logs, OpenShift monitoring, Rancher monitoring, RKE2 server configuration, K3s architecture, Kubermatic Kubernetes Platform concepts
- eBPF-basierte Werkzeuge: Cilium Hubble, Pixie, Parca. Unsere verwandten Beiträge (auf Englisch): Kubernetes CronJob monitoring, Cut your observability bill at the source