Fortgeschrittene Prometheus-Abfragen für sparse Daten


«Sparse Metriken mit PromQL abzufragen ist, wie darauf zu warten, dass der Teenager zurückschreibt - es passiert einmal am Tag, meistens um 2 Uhr nachts, und die Antwort ist nur ‹k›.»
opensight.ch - roman hüsler
Wer schon eine Weile mit Prometheus und PromQL arbeitet, kennt diesen Moment wahrscheinlich: Man starrt auf ein Grafana-Dashboard und fragt sich, warum eine völlig gesunde Metrik einfach verschwunden ist. Warum Messspitzen verschwinden, sobald man den Zeitbereich vergrössert. Oder warum rate() für eine Metrik, die eindeutig Daten hat, gelegentlich nichts zurückgibt. Nicht, weil die Daten fehlten — sondern weil das Staleness Handling und die Lookback-Mechanik von PromQL entschieden haben, dass sie nicht mehr relevant sind.
Genau darum geht es in diesem Beitrag. Darum, was unter der Haube passiert, wenn die Sample-Rate einer Metrik unter 5 Minuten fällt, und welche fortgeschrittenen Abfragetechniken man dann braucht.
Inhalt
- TL;DR
- PromQL in 60 Sekunden
- Instant vs. Range Queries
- Instant Vectors vs. Range Vectors
- Das 5-Minuten-Lookback-Delta
- Step-Intervalle: Warum Spikes beim Herauszoomen verschwinden
- Staleness Markers: der stille Killer
- Range Vectors als Rettung
- rate() und increase(): die Counter-Falle
- Subqueries: wenn man eine Aggregation aggregieren muss
- absent() vs. absent_over_time(): Lücken erkennen
- Praxismuster für typische Szenarien
- Die wichtigsten Erkenntnisse
TL;DR
PromQL hat ein 5-Minuten-Lookback-Fenster und Staleness Markers, die sparse Metriken stillschweigend verschlucken können. Ist das Scrape-Intervall lang (5 Minuten und mehr), sind die Metriken bursty oder arbeitet man mit Batch-Jobs, lassen einen Standard-Queries im Stich. Ob man Vanilla-Prometheus, Grafana Mimir oder Thanos betreibt: Die PromQL-Engine darunter ist dieselbe, und damit auch diese Eigenheiten. Dieser Beitrag richtet sich an SREs und erklärt die Mechanik dahinter sowie die fortgeschrittenen Techniken, um sie zu umgehen.
PromQL in 60 Sekunden
Bevor wir zu den Eigenheiten kommen, klären wir die Begriffe. PromQL ist die Abfragesprache, die Prometheus, Grafana Mimir, Thanos und andere kompatible Backends gemeinsam haben. Das hier beschriebene Staleness- und Lookback-Verhalten gilt für alle. PromQL kennt zwei grundlegende Query-Typen und zwei Datentypen, deren Zusammenspiel bei sparse Daten entscheidend ist.
Instant vs. Range Queries
Eine Instant Query wertet einen Ausdruck zu einem einzigen Zeitpunkt aus und liefert eine Momentaufnahme. Das bekommt man, wenn man eine Query in den Expression Browser von Prometheus eintippt. Eine Range Query wertet denselben Ausdruck wiederholt über ein Zeitfenster aus, in regelmässigen Abständen, den sogenannten Steps. Damit zeichnet Grafana seine Graphen: Es schickt eine Range Query mit den Parametern start, end und step.
# Instant query — evaluated once at "now":
http_requests_total{job="api"}

# Range query — Grafana asks Prometheus:
# "evaluate this expression every 15s from 10:00 to 11:00"
# → returns an array of results, one per step
Instant Vectors vs. Range Vectors
Ein Instant Vector ist eine Menge von Zeitreihen, in der jede Zeitreihe genau ein Sample hat — einen einzelnen Wert zu einem Zeitpunkt. Die meisten PromQL-Ausdrücke liefern Instant Vectors. Ein Range Vector ist eine Menge von Zeitreihen, in der jede Zeitreihe mehrere Samples über ein Zeitfenster enthält. Einen Range Vector erzeugt man, indem man eine Dauer in eckigen Klammern anhängt:
# Instant vector — one value per series:
http_requests_total{job="api"}

# Range vector — all samples from the last 5 minutes per series:
http_requests_total{job="api"}[5m]

Range Vectors lassen sich nicht direkt als Graph darstellen — sie müssen mit Aggregationsfunktionen wie rate(), avg_over_time() oder max_over_time() auf Instant Vectors reduziert werden. Diese Funktionen nehmen die vielen Samples eines Range Vectors und fassen sie pro Zeitreihe zu einem einzigen Wert zusammen.
# rate() takes a range vector and returns an instant vector:
rate(http_requests_total{job="api"}[5m])

# max_over_time() returns the highest sample in the window:
max_over_time(cpu_usage{instance="web-1"}[1h])

# last_over_time() returns the most recent sample in the window:
last_over_time(batch_job_status{job="etl"}[30m])
Ausserdem begegnet man der Subquery-Syntax [range:resolution] — sie nimmt einen Instant-Vector-Ausdruck, wertet ihn wiederholt in einer bestimmten Auflösung über ein Zeitfenster aus und erzeugt so einen Range Vector. So verschachtelt man Aggregationen:
# Subquery syntax: <instant_expr>[range:resolution]
#
# [2m:15s] means:
#   "evaluate this expression every 15s over the last 2 minutes"
#   → produces a range vector with ~8 samples
#
# Example: average of 5-minute rates, computed every 15s over 2 minutes:
avg_over_time(rate(http_requests_total[5m])[2m:15s])
Die zentrale Erkenntnis für diesen ganzen Beitrag: Instant Vectors unterliegen dem 5-Minuten-Lookback und den Staleness-Regeln. Range Vectors nicht. Dieser Unterschied macht die *_over_time()-Funktionen zum wichtigsten Werkzeug für Abfragen auf sparse Daten.
Das 5-Minuten-Lookback-Delta
Was den meisten an PromQL nicht bewusst ist: Jede Instant Query hat ein verstecktes 5-Minuten-Fenster. Wertet Prometheus eine Query zum Zeitpunkt T aus, sucht es nicht nur nach einem Sample genau bei T — es schaut bis zu 5 Minuten zurück (das --query.lookback-delta) und nimmt das jüngste Sample.
Das funktioniert bestens, solange das Scrape-Intervall kurz ist, etwa 15s oder 30s. Dann liegt immer ein aktuelles Sample im Fenster. Sobald die Daten aber sparse werden — Batch-Jobs, die alle 10 Minuten oder einmal am Tag melden, ein Service, der Metriken nur bei Events emittiert, oder ein Target, das gelegentlich Scrapes verpasst —, wird dieses 5-Minuten-Fenster zur Klippe.

# This looks fine with 15s scrape intervals
up{job="my-service"}

# But with a 10-minute scrape interval?
# At evaluation time T, if the last sample was 6 minutes ago — gone.
# PromQL returns nothing. No error. No warning. Just empty.
Und es wird noch schlimmer. Bei Range Queries wertet Prometheus den Ausdruck bei jedem step innerhalb des Bereichs aus. Ist der Step 1 Minute, die Daten treffen aber nur alle 10 Minuten ein, finden die meisten Auswertungspunkte nichts — das Ergebnis ist ein Graph mit riesigen Lücken oder gar keinen Daten.
Step-Intervalle: Warum Spikes beim Herauszoomen verschwinden
Das ist wohl das verwirrendste PromQL-Verhalten für alle, die neu mit Prometheus arbeiten: Man schaut auf ein Dashboard und sieht einen klaren Spike. Man vergrössert den Zeitbereich, um mehr Kontext zu bekommen — und der Spike ist einfach weg. Die Daten sind immer noch in Prometheus. Die Metrik hat sich nicht verändert. Aber die Query findet sie nicht mehr.
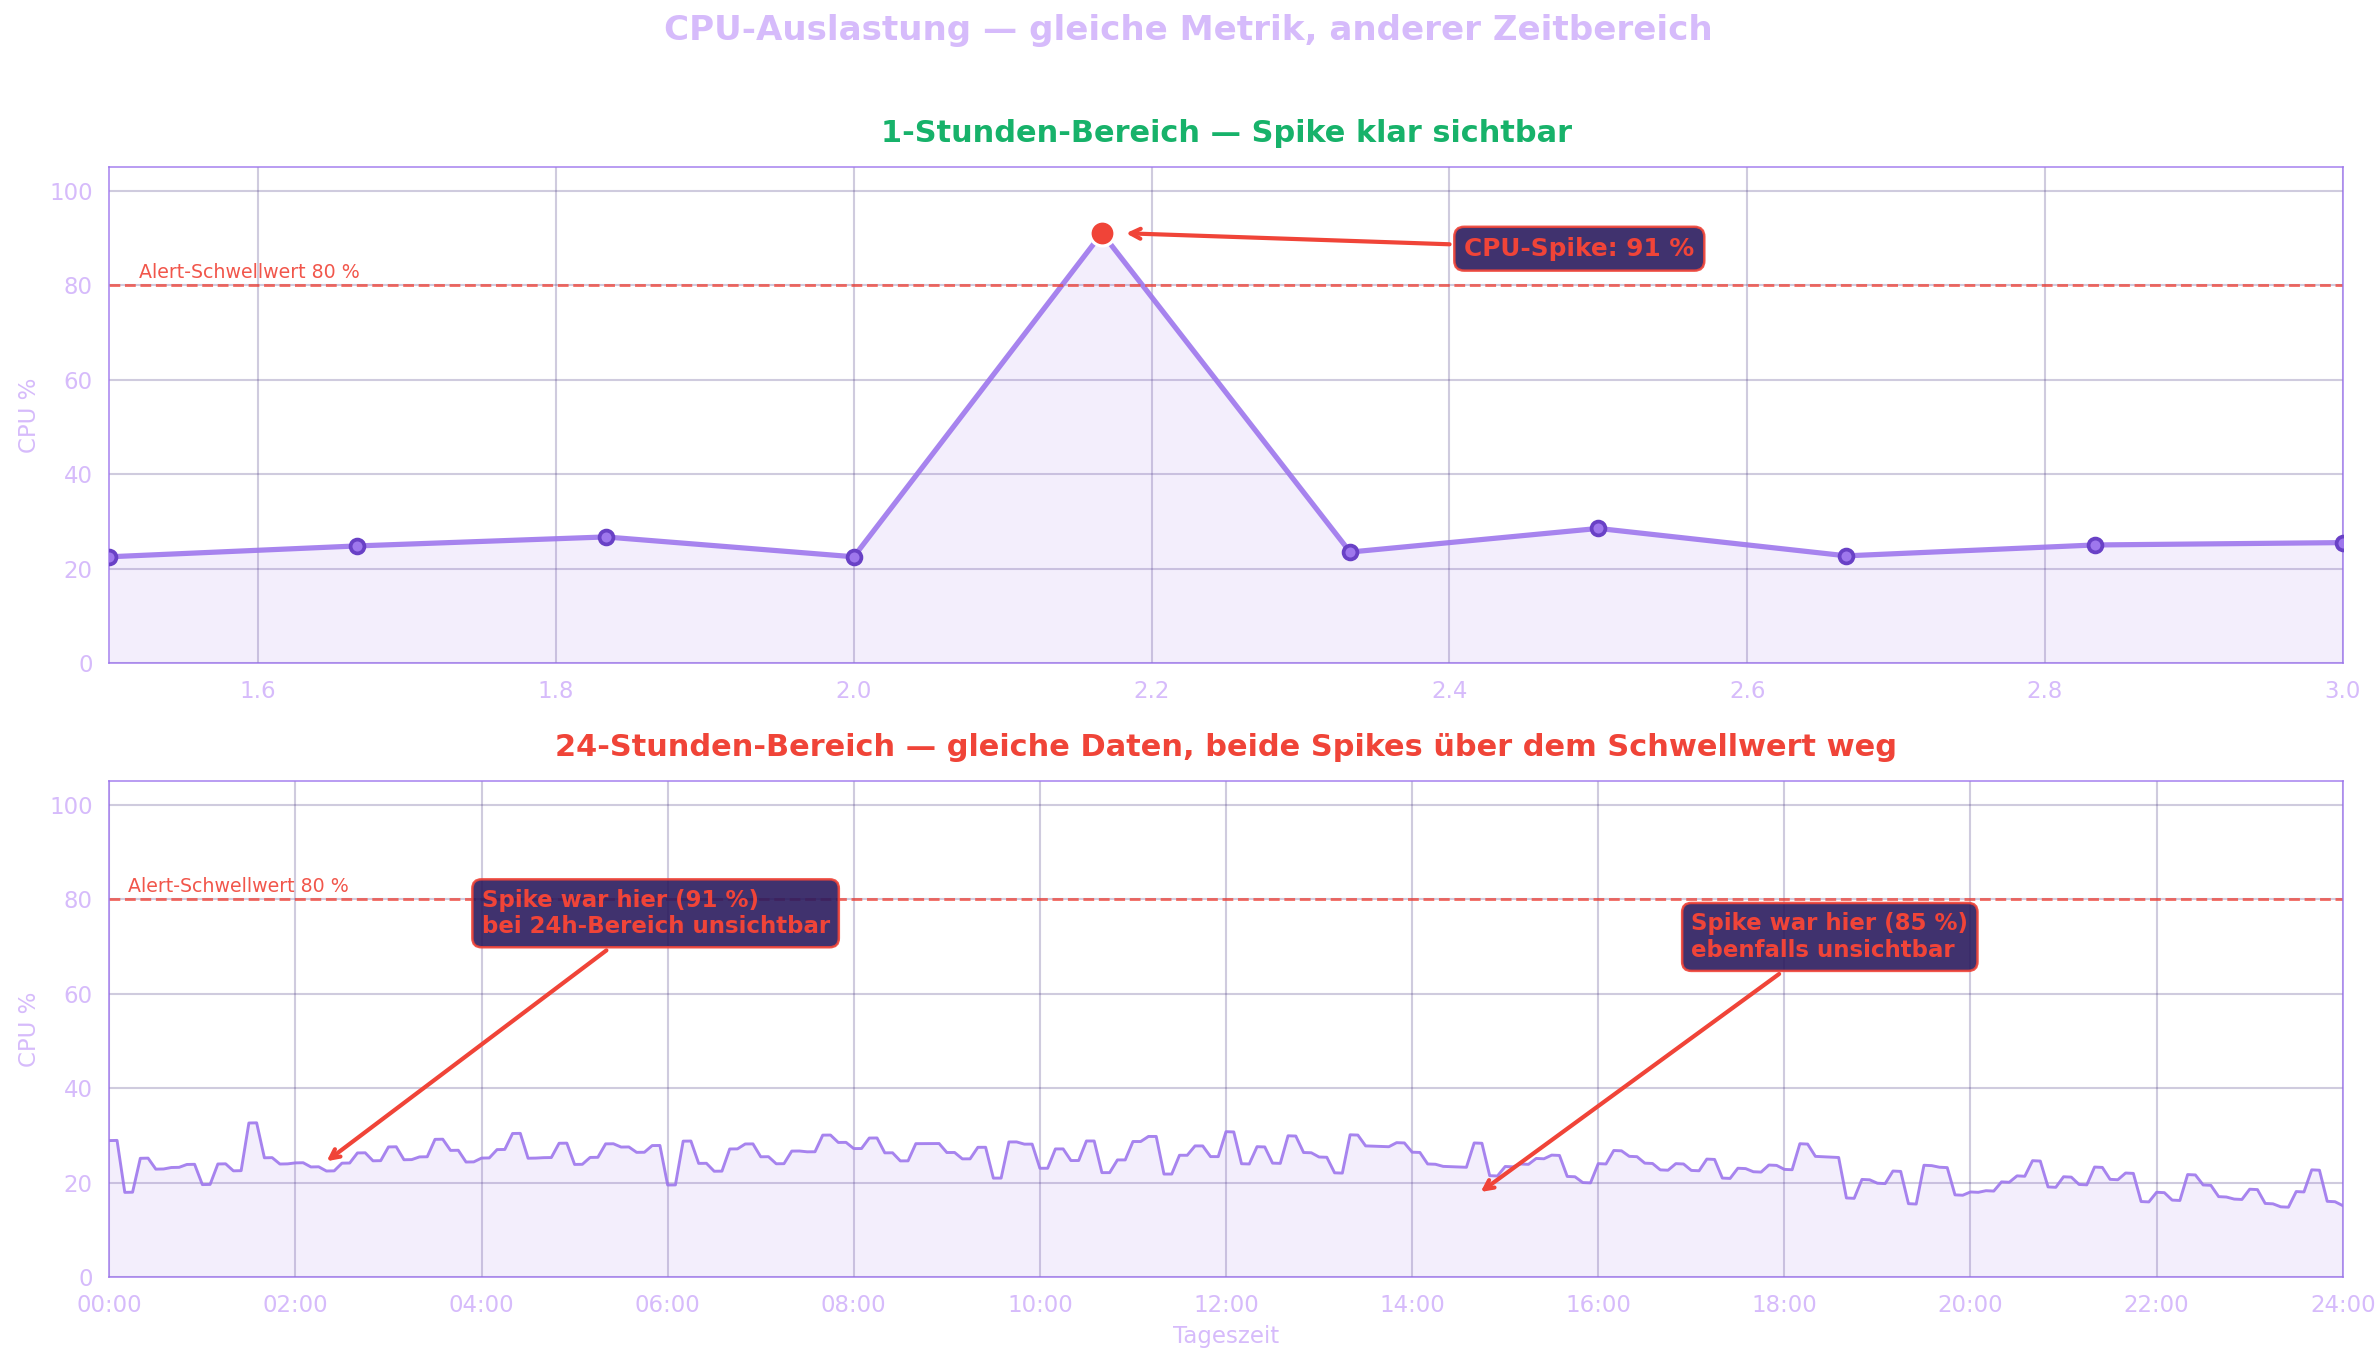
Der Grund: Wenn Grafana (oder ein anderer PromQL-Client) eine Range Query ausführt, holt es nicht jedes einzelne gespeicherte Sample. Stattdessen wird der Query-Ausdruck in regelmässigen Abständen ausgewertet, den Steps. Die Step-Grösse ergibt sich aus Zeitbereich und Panel-Breite — Grafana berechnet sie typischerweise als time_range / panel_width_in_pixels und zielt auf ungefähr einen Datenpunkt pro Pixel.
- 1-Tages-Bereich auf einem 1000px-Panel → Step ≈ 86s → ~1000 Auswertungspunkte
- 7-Tages-Bereich auf einem 1000px-Panel → Step ≈ 10min → ~1000 Auswertungspunkte
- 30-Tages-Bereich auf einem 1000px-Panel → Step ≈ 43min → ~1000 Auswertungspunkte
Bei jedem Step wendet Prometheus den 5-Minuten-Lookback an, um das jüngste Sample zu finden. Und hier ist die Rechnung, die sparse Daten zum Verhängnis wird:
Mit einem Step-Intervall von 1 Stunde und einem 5-Minuten-Lookback «sieht» jeder Step nur ein 5-Minuten-Fenster von je 60 Minuten. Das sind 8,3 % Abdeckung. Die restlichen 91,7 % der Zeit sind ein Blind Spot. Landet der Datenpunkt in diesem Blind Spot — und bei sparse Daten tut er das fast sicher —, ist er für die Query unsichtbar.
Formal lässt sich das als zeitliche Abdeckungsrate ausdrücken — der Anteil der Zeitachse, den die Query-Engine tatsächlich sieht:
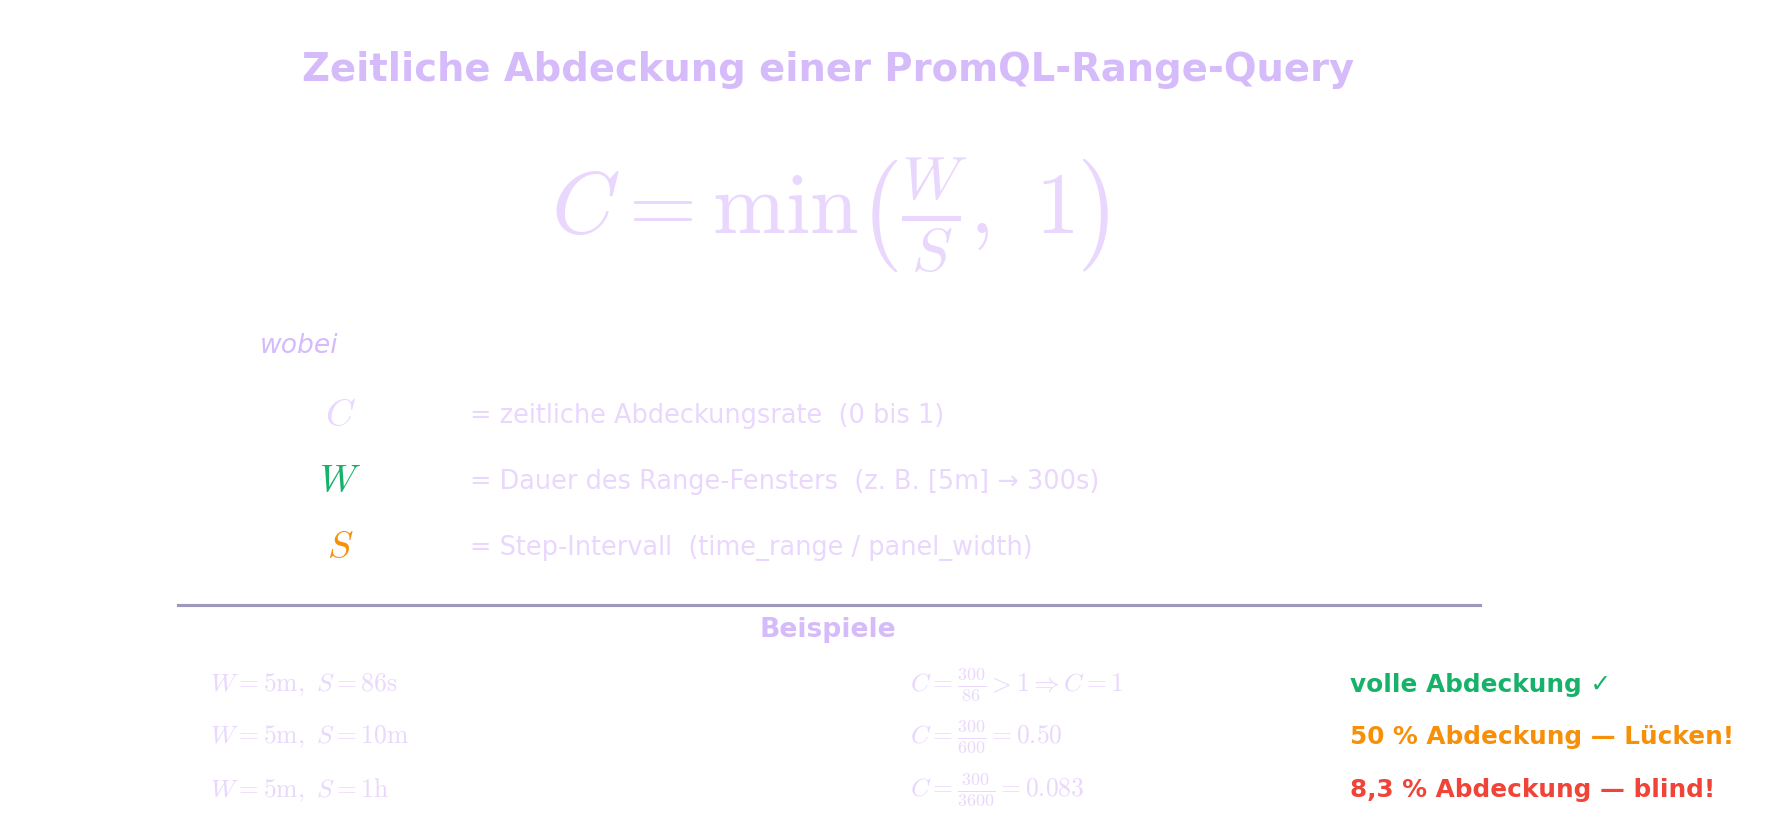

Zoomen wir hinein und schauen, was rund um den Spike tatsächlich passiert:

Das ist kein Bug — PromQL-Range-Queries sind so konstruiert. Das Step-Intervall ist eine Optimierung, damit nicht Millionen von Punkten ausgewertet werden müssen. Bei sparse Daten entsteht dadurch aber ein Sampling-Problem: Das Auswertungsraster der Query und das Timing der Daten sind völlig unabhängig voneinander.
Die Lösung folgt demselben Prinzip wie zuvor: *_over_time()-Funktionen mit einem Range-Fenster verwenden, das breiter ist als das Step-Intervall. Packt man die Query in max_over_time(my_metric[1h]), wertet jeder Step einen 1-Stunden-Range-Vector aus, statt nach einem einzelnen Zeitpunkt zu suchen — und Range Vectors sammeln alle Samples im Fenster ein, egal wann sie aufgetreten sind.
# Instant query — spike visible at 1-day range, gone at 7-day range:
my_sparse_metric{job="batch"}

# Range vector — spike visible at ANY time range:
max_over_time(my_sparse_metric{job="batch"}[1h])

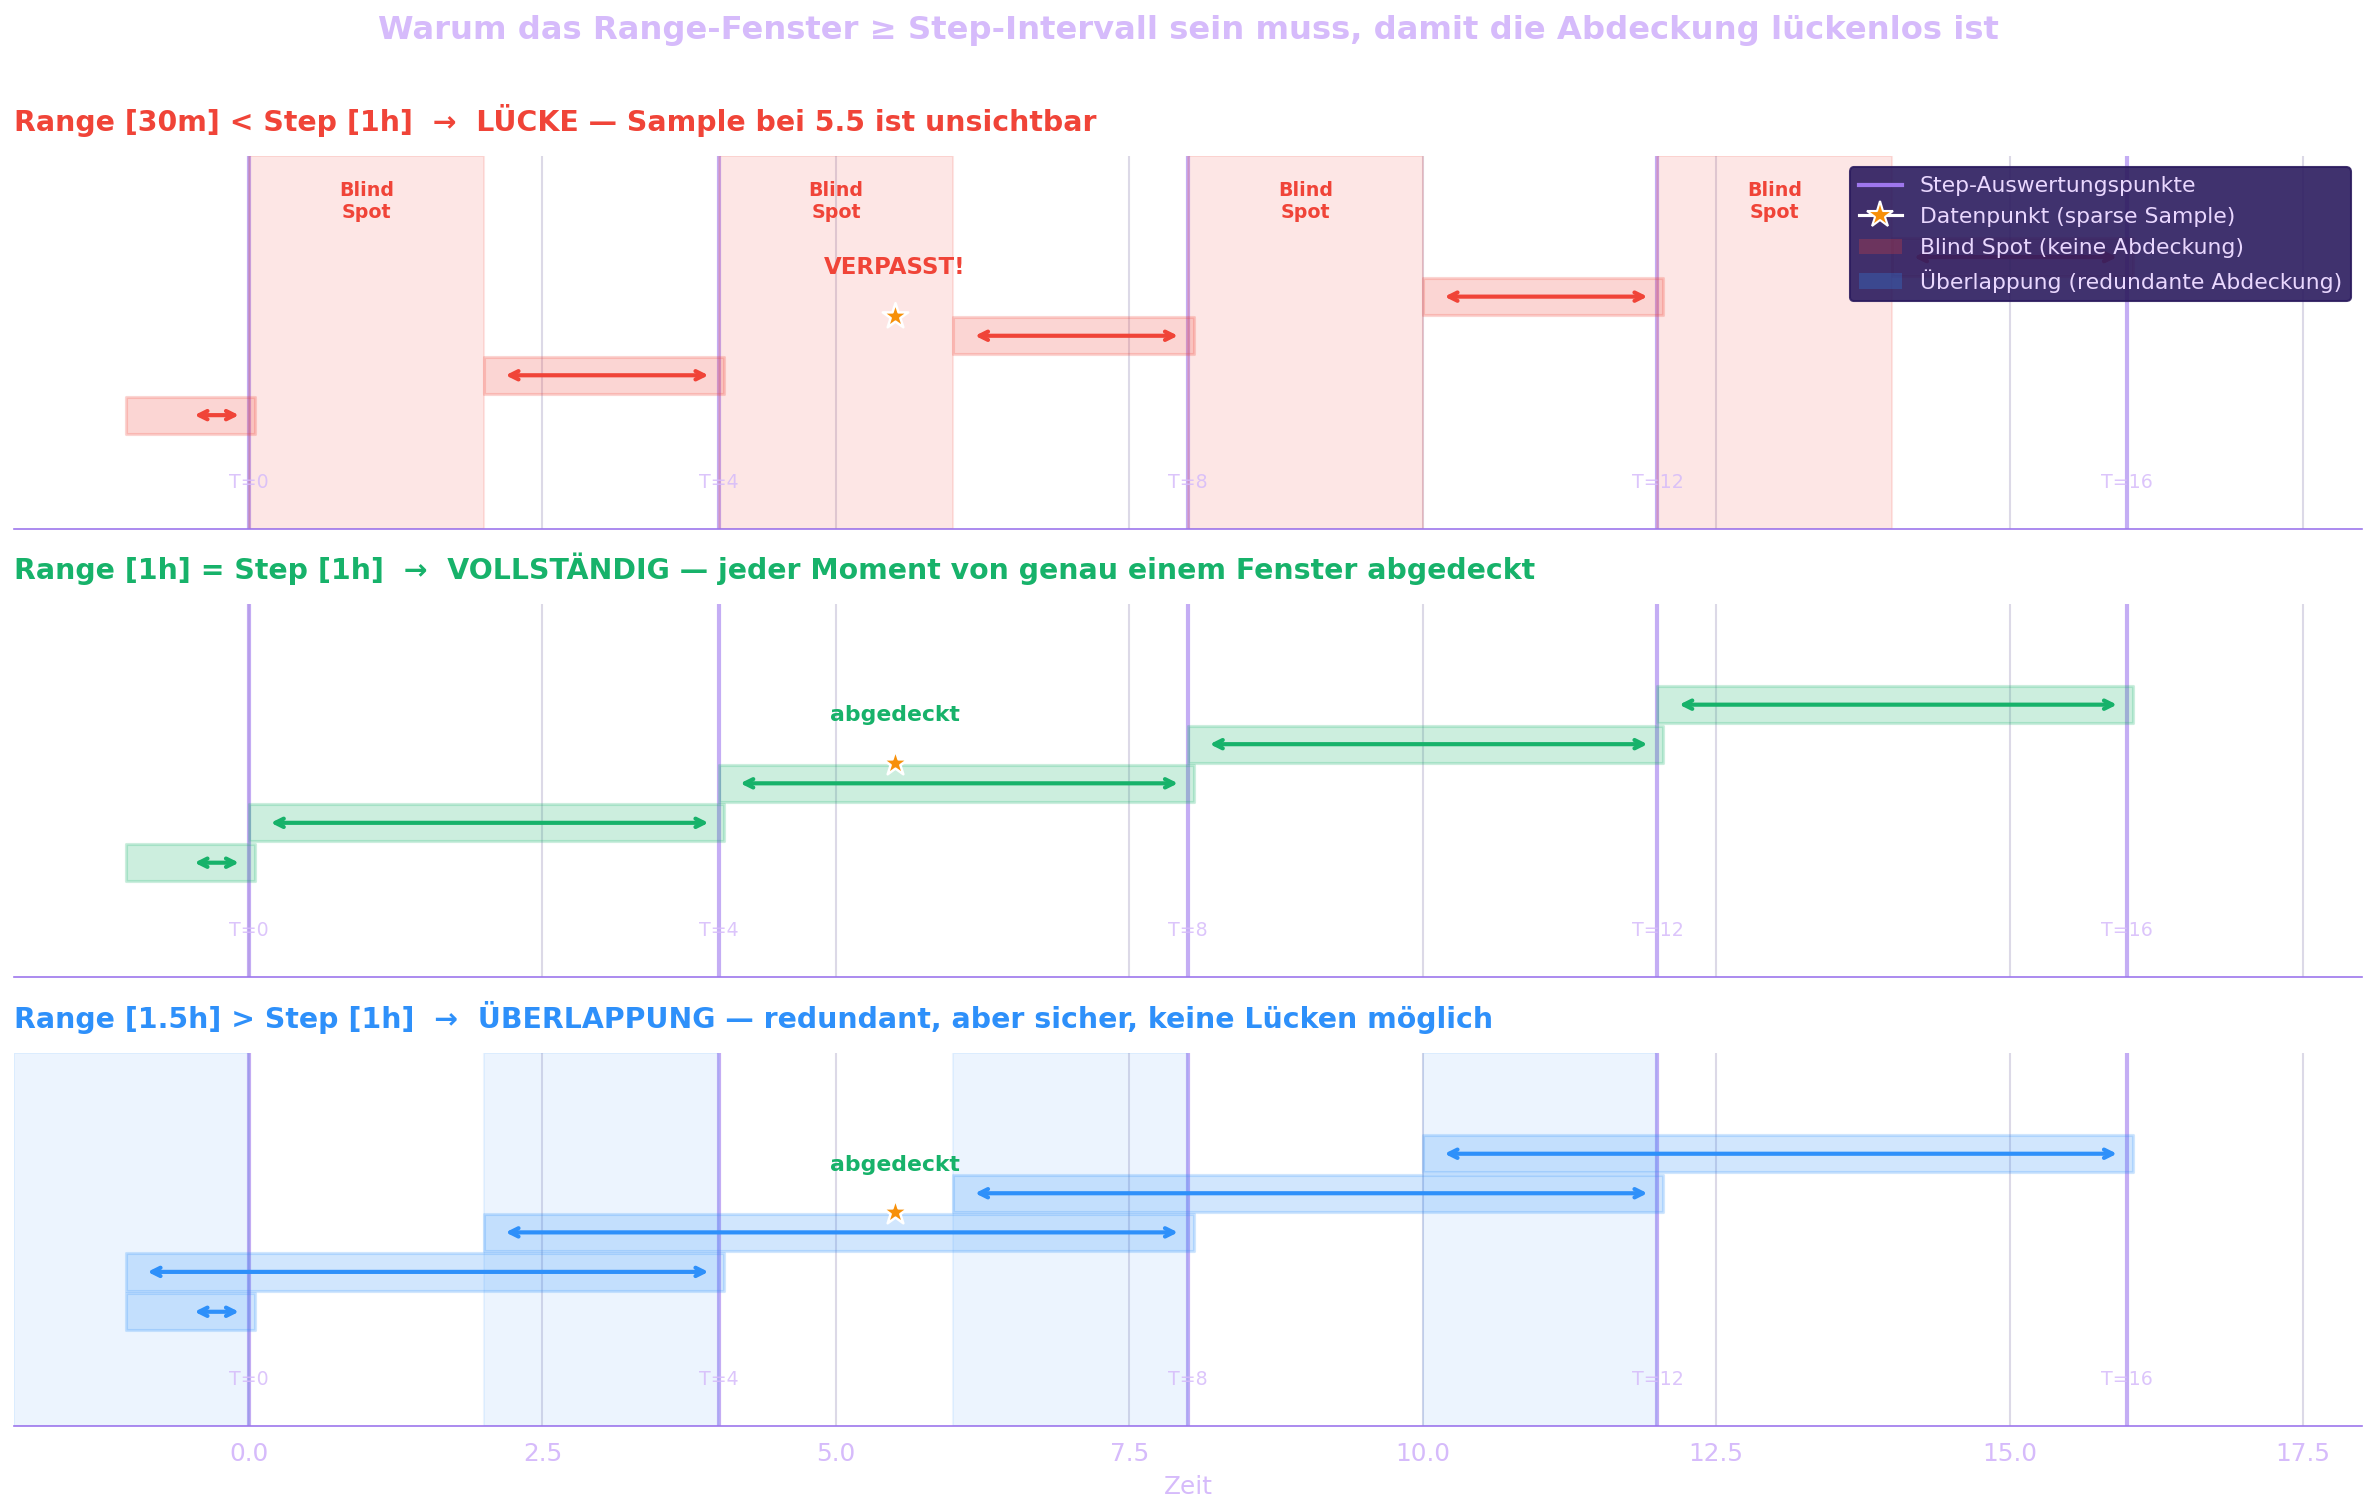
# The range window must be equal to (or greater than) your step interval
# for complete temporal coverage — ensuring all samples are considered
# For 7-day dashboards: steps are ~10min, so [15m] is safe
# For 30-day dashboards: steps are ~43min, so [1h] is safe
# For 90-day dashboards: steps are ~2h, so [3h] is safe
Warum muss das Range-Fenster mindestens so breit sein wie der Step? Weil sich die Range-Fenster aufeinanderfolgender Steps berühren oder überlappen müssen, damit garantiert kein Sample durch die Maschen fällt. Ist die Range kleiner als der Step, entsteht zwischen den Lookback-Fenstern der einzelnen Steps ein Blind Spot, in dem Datenpunkte unsichtbar sind. Ist die Range gleich dem Step, wird jeder Moment auf der Zeitachse von genau einem Auswertungsfenster abgedeckt — vollständige zeitliche Abdeckung ohne Lücken.
Staleness Markers: der stille Killer
Mit Prometheus 2.0 kamen Staleness Markers: spezielle NaN-Werte, die eingefügt werden, wenn eine Zeitreihe aus einem Scrape-Target verschwindet. Die Absicht ist gut — wird eine Metrik nicht mehr exponiert, markiert Prometheus sie als stale, damit die Query-Engine nicht endlos den letzten bekannten Wert zurückgibt.
Bei sparse Daten wird es hier aber heikel:

- Ein Target wird gescrapt, die Metrik ist da → Sample wird gespeichert
- Beim nächsten Scrape fehlt die Metrik (vielleicht eine Batch-Metrik oder ein bedingter Gauge) → Staleness Marker wird eingefügt
- Die Query trifft auf den Staleness Marker → PromQL sagt «diese Zeitreihe ist weg» und liefert nichts
- Zwei Scrapes später ist die Metrik zurück → es gibt wieder Daten, aber die Lücke ist real
Das Ergebnis: Dashboards mit sporadischen Löchern, flappende Alerts und SREs, die an ihrem Verstand zweifeln.
Range Vectors als Rettung
Hier die erste zentrale Erkenntnis: Range-Vector-Selektoren ignorieren Staleness Markers. Das ist zwar dokumentiert, wird aber selten betont. Verwendet man einen Range-Selektor wie [10m], sammelt Prometheus alle Roh-Samples in diesem Fenster ein — Stale Markers werden einfach übersprungen.

Damit lassen sich die Lücken mit *_over_time()-Funktionen überbrücken:
# Instead of this (fails with sparse data):
my_batch_metric{job="etl"}

# Use this — grabs the last value within a 15m window:
last_over_time(my_batch_metric{job="etl"}[15m])

# Or if you want the max value seen in the last hour:
max_over_time(my_batch_metric{job="etl"}[1h])
last_over_time() ist der beste Freund für sparse Gauge-Metriken. Die Funktion liefert das jüngste Sample innerhalb der Range und ignoriert dabei die Staleness. Das Range-Fenster sollte man deutlich grösser wählen als das erwartete Meldeintervall.
rate() und increase(): die Counter-Falle
Counter und sparse Daten sind eine besonders üble Kombination. rate() braucht mindestens zwei Samples im Range-Fenster, um eine Rate pro Sekunde zu berechnen. Bei sparse Daten bekommt man oft nur eines — oder gar keines.

# With a 15s scrape interval, this works fine:
rate(http_requests_total{job="api"}[5m])

# But with sparse data (scrape every 5m), you need a wider window:
rate(http_requests_total{job="api"}[15m])

# Rule of thumb: range window >= 4x your scrape interval
# Why 4x? You need at least 2 samples, plus margin for missed
# scrapes and staleness. This is the Prometheus docs recommendation.
Und dann ist da noch der Sonderfall increase(). Prometheus extrapoliert den Anstieg auf das ganze Range-Fenster, was selbst bei ganzzahligen Countern gebrochene Werte ergeben kann. Bei sparse Daten wird diese Extrapolation noch unzuverlässiger, weil die Abstände zwischen den Samples unregelmässig sind.
Braucht man exakte Zählwerte aus sparse Countern, sollte man Recording Rules in Betracht ziehen, die in einem bekannten Intervall voraggregieren, oder auf rate() umsteigen und selbst mit der Fenstergrösse multiplizieren.
Subqueries: wenn man eine Aggregation aggregieren muss
Manchmal muss man ein bereits aggregiertes Ergebnis noch einmal über die Zeit aggregieren. Dafür gibt es Subqueries. Mit einer Subquery wertet man eine Instant Query über eine Range in einer frei wählbaren Auflösung aus:
# Syntax: <instant_query>[range:resolution]

# Average rate over the last hour, evaluated every 5 minutes:
avg_over_time(rate(http_requests_total[5m])[1h:5m])

# Max CPU usage (already aggregated by instance) over 24h:
max_over_time(
  max by (instance) (rate(node_cpu_seconds_total{mode!="idle"}[5m]))
[24h:5m])
Für sparse Daten sind Subqueries mächtig, weil man die innere Auflösung an die Datenfrequenz anpassen und die äussere Range so wählen kann, dass sie die Lücken abdeckt. Man sollte sie aber mit Bedacht einsetzen — sie sind teuer. Jeder Subquery-Step erzeugt eine vollständige innere Auswertung. Eine [24h:1m]-Subquery bedeutet 1440 innere Auswertungen. Verwendet man dieselbe Subquery in mehreren Dashboards, lohnen sich Recording Rules.
absent() vs. absent_over_time(): Lücken erkennen
Wer auf fehlende sparse Daten alarmieren will, muss das richtige Werkzeug wählen:

# absent() — fires when the metric has NO current value
# Respects staleness, so it fires immediately after a stale marker
absent(my_batch_metric{job="etl"})

# absent_over_time() — fires when NO samples exist in the window
# Ignores staleness markers, looks at actual samples
absent_over_time(my_batch_metric{job="etl"}[30m])
Bei sparse Metriken feuert absent() zwischen den Datenpunkten ständig — nicht hilfreich. Was man will, ist absent_over_time() mit einem grosszügigen Fenster. Das Fenster sollte das 2- bis 3-Fache des erwarteten Meldeintervalls betragen, damit man nur dann alarmiert, wenn die Daten wirklich fehlen, und nicht schon, wenn sie bloss sparse sind.
Praxismuster für typische Szenarien
Batch-Jobs (Pushgateway oder eigener Exporter)
# Last known status of a batch job
last_over_time(batch_job_success{job="nightly-etl"}[25h])

# Alert if batch job hasn't reported in 25 hours
absent_over_time(batch_job_success{job="nightly-etl"}[25h])
Event-getriebene Metriken (nur bei Aktivität emittiert)
# Total errors in the last hour, even if metric is sparse
max_over_time(errors_total{service="payments"}[1h])
  -
min_over_time(errors_total{service="payments"}[1h])

# Or use increase with a wide enough window
increase(errors_total{service="payments"}[1h])
Lange Scrape-Intervalle (Kostenoptimierung)
# If scraping every 5m, use at least 20m windows for rate:
rate(requests_total[20m])

# For dashboards, match your $__rate_interval or set a minimum:
rate(requests_total[$__rate_interval])
# Grafana's $__rate_interval auto-adjusts based on scrape interval
Recording Rules zum Glätten
# rules.yml — pre-compute at a consistent interval
groups:
  - name: sparse_metrics
    interval: 5m
    rules:
      - record: job:batch_status:last
        expr: last_over_time(batch_job_success[25h])
      - record: job:request_rate:5m
        expr: rate(requests_total[20m])
Recording Rules werden in einem festen Intervall ausgewertet, unabhängig von der zugrunde liegenden Scrape-Frequenz. Das ergibt eine konsistente Zeitreihe, auf die sich nachgelagerte Queries verlassen können, ohne sich um Sparsity kümmern zu müssen.
Die wichtigsten Erkenntnisse
- Das 5-Minuten-Lookback-Delta ist die Ursache der meisten Probleme mit «verschwindenden Metriken». Sind die Daten dünner als alle 5 Minuten, haben normale Instant Queries Lücken. Mit
--query.lookback-deltalässt sich das global anpassen, aber das wirkt sich auf alles aus. - Step-Intervalle verschärfen das Problem. Breitere Zeitbereiche bedeuten breitere Steps, und damit deckt der 5-Minuten-Lookback jedes Auswertungspunkts einen kleineren Teil der Zeitachse ab. Ein Spike, der in der 1-Tages-Ansicht sichtbar ist, kann in der 7-Tages-Ansicht verschwinden — nicht weil die Daten weg sind, sondern weil zufällig kein Lookback-Fenster eines Steps auf ihm landet.
- Staleness Markers killen sparse Gauge-Metriken. Ist eine Metrik nicht in jedem Scrape vorhanden, wird sie als stale markiert. Mit
last_over_time()schaut man durch die Staleness hindurch. - Range Vectors ignorieren Staleness. Der Wechsel von Instant-Selektoren zu
*_over_time()-Funktionen ist die mit Abstand wirksamste Technik für sparse Daten. - rate() braucht mindestens 2 Samples. Bei sparse Countern sollte das Range-Fenster mindestens das 4-Fache des Scrape-Intervalls betragen.
- Subqueries sind mächtig, aber teuer. Man setzt sie ein, wenn man eine bereits aggregierte Metrik über die Zeit aggregieren muss. Für alles, was an mehreren Stellen verwendet wird, sind Recording Rules die bessere Wahl.
- absent_over_time() statt absent() für Alerts auf sparse Metriken. Ersteres sucht nach tatsächlichen Samples im Fenster; Letzteres respektiert die Staleness und schlägt zwischen sparse Samples fälschlich an.
- Recording Rules sind der Stabilisator. Sie erzeugen eine konsistente Ausgabezeitreihe, egal wie sparse die Eingabe ist. Alles, was man häufig abfragt, sollte man vorberechnen.
PromQL ist eine mächtige Sprache — ob man nun Prometheus direkt, Grafana Mimir oder Thanos abfragt —, aber die Staleness- und Lookback-Mechanik wurde für den Normalfall entworfen: dicht gescrapte Infrastrukturmetriken in Intervallen von 15 bis 30 Sekunden. Sobald man diese Komfortzone verlässt — Batch-Jobs, event-getriebene Systeme, kostenoptimierte lange Scrape-Intervalle —, muss man diese Interna verstehen, um Queries zu schreiben, die tatsächlich funktionieren.