Application Observability: Tracing mit Auto-Instrumentation


Heute untersuche ich, was Tracing out of the box für die Application Observability leisten kann, zusammen mit RED-Metriken (Rate, Errors und Duration). Im Idealfall verteilt man einen Agent samt Konfiguration auf die Linux-VMs und erhält damit nahtlose Service Discovery und Distributed Tracing.
opensight.ch - roman huesler
Lässt sich das erreichen? Ich teile hier meine Erfahrungen. Einige der verwendeten Playbooks finden Sie im GIT-Repository.
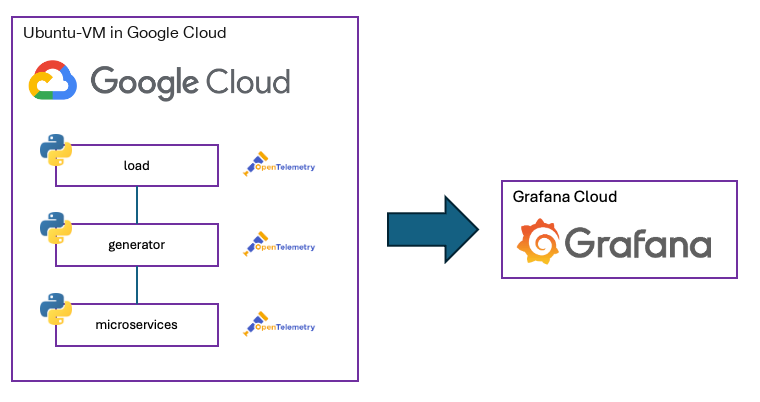
Für diesen Test habe ich einen Ubuntu-Host mit mehreren Microservices aufgesetzt, als Observability-Backend dient Grafana Cloud. Das Ziel war einfach: einen schlanken Agent auf der virtuellen Maschine installieren (oder nur minimal konfigurieren), der alle laufenden Applikationen automatisch instrumentiert und so Distributed Tracing, Service Discovery und RED-Metriken (Rate, Errors, Duration) out of the box liefert, ohne dass man den Code anfassen muss.
TL;DR - der Realitätscheck Kurz gesagt: Ganz «zero-touch» habe ich es nicht geschafft. Wir sind deutlich vorangekommen, mit teilweise funktionierender Auto-Instrumentation für einige Runtimes und einer soliden Erfassung der Metriken. Nahtloses, sprachunabhängiges Distributed Tracing über alle Applikationen auf dem Host verlangte aber mehr Handarbeit als erwartet.
Ende 2025 ist die Technologie weit gekommen, aber für wirklich heterogene Umgebungen ist sie noch nicht «einrichten und vergessen».
Inhalt
- Demo-Applikation installieren
Installation der Microservices-Demo-Applikation, die wir mit Tracing instrumentieren - Grafana Alloy mit Beyla eBPF
Einen Grafana Alloy Agent auf der VM installieren und eBPF-Tracing konfigurieren - OpenTelemetry Zero-Code Auto-Instrumentation
Die Applikationen mit dem Zero-Code-Ansatz von OpenTelemetry instrumentieren - OpenTelemetry Injector
Erster Kontakt mit dem OpenTelemetry Injector - Fazit
Demo-Applikation installieren
Ich habe eine einfache Demo-Applikation verwendet: einen Passwort-Generator, der in diesem Git-Repository liegt (Link zum Repo). Er besteht aus mehreren Python-Flask-Microservices und ist eigens für Experimente mit Tracing und Instrumentierung gebaut. Ein loader spricht mit verschiedenen Backends, um ein Passwort zu erzeugen:
generatorerzeugt das Passwort, indem er alle anderen Services mehrmals aufruftspecialerzeugt Sonderzeichenuppererzeugt Grossbuchstabenlowererzeugt Kleinbuchstaben (und schlägt manchmal fehl)digiterzeugt Ziffern
Zu Beginn habe ich ein Ansible Playbook namens main_uninstrumented.yml erstellt. Es installiert die gesamte Passwort-Generator-Applikation auf einer einzigen Ubuntu-Maschine und richtet jeden Service als systemd-Unit ein, damit die Prozesse sauber verwaltet und bei Bedarf automatisch neu gestartet werden.
Grafana Alloy mit Beyla eBPF
Versuchen wir, einen Alloy Agent auf der VM zu installieren, der mit eBPF-Technologie alles beobachtet und tracet. Das wäre schliesslich die Gans, die goldene Eier legt: Wir installieren einen Agent auf allen virtuellen Maschinen und sind fertig. Er sammelt alle Traces ein und erstellt uns eine Service Map. Ich habe aber schnell gemerkt, dass die Technologie noch nicht ganz so weit ist.
Schauen Sie sich das Playbook main_instrumented_alloy.yml im Repository an, mit dem Alloy konfiguriert wurde.
Meine wichtigste Erkenntnis aus diesem Ansatz:
Alloy mit Beyla eBPF ist ein hervorragender Weg, um die RED-Metriken aller Services auf allen VMs einzusammeln.
opensight.ch - roman huesler
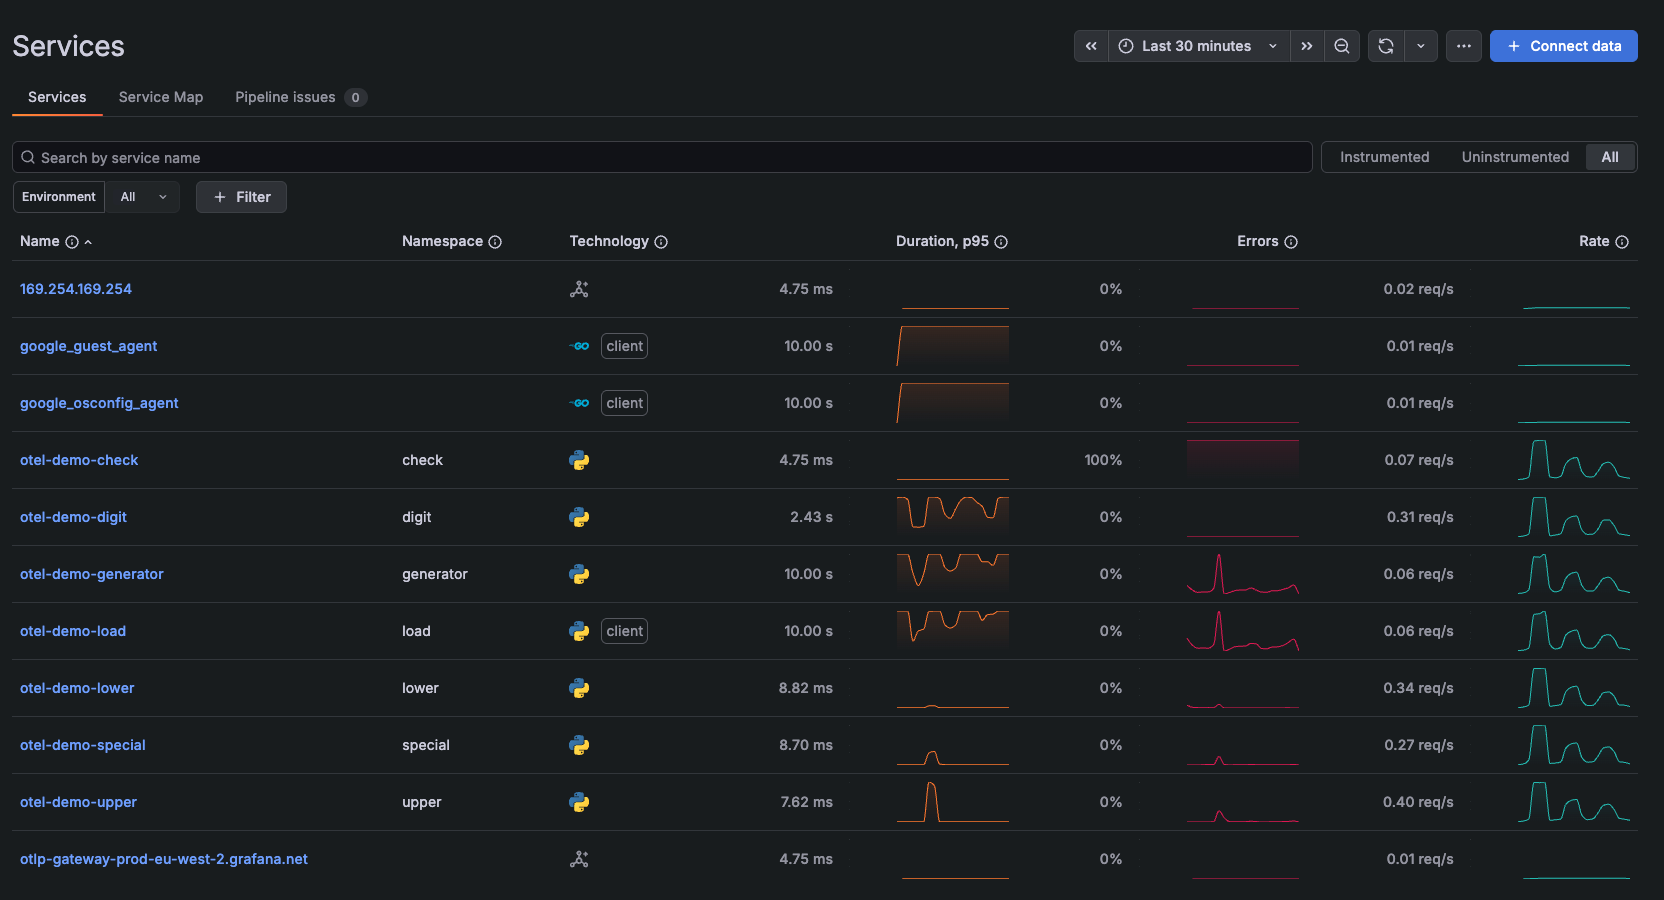
Grafana verwendet die Metrik traces_spanmetrics_calls_total für die Spalten Name, Rate und Error Rate und traces_spanmetrics_latency_bucket für die Spalte Duration. Diese Metriken müssen in der Prometheus-Datenquelle vorhanden sein und wurden von unserem Alloy eingesammelt.
Obwohl ich ebpf.context_propagation aktiviert hatte, entstand kein End-to-End-Tracing mit Context Propagation, sondern nur einzelne, unverbundene Spans.
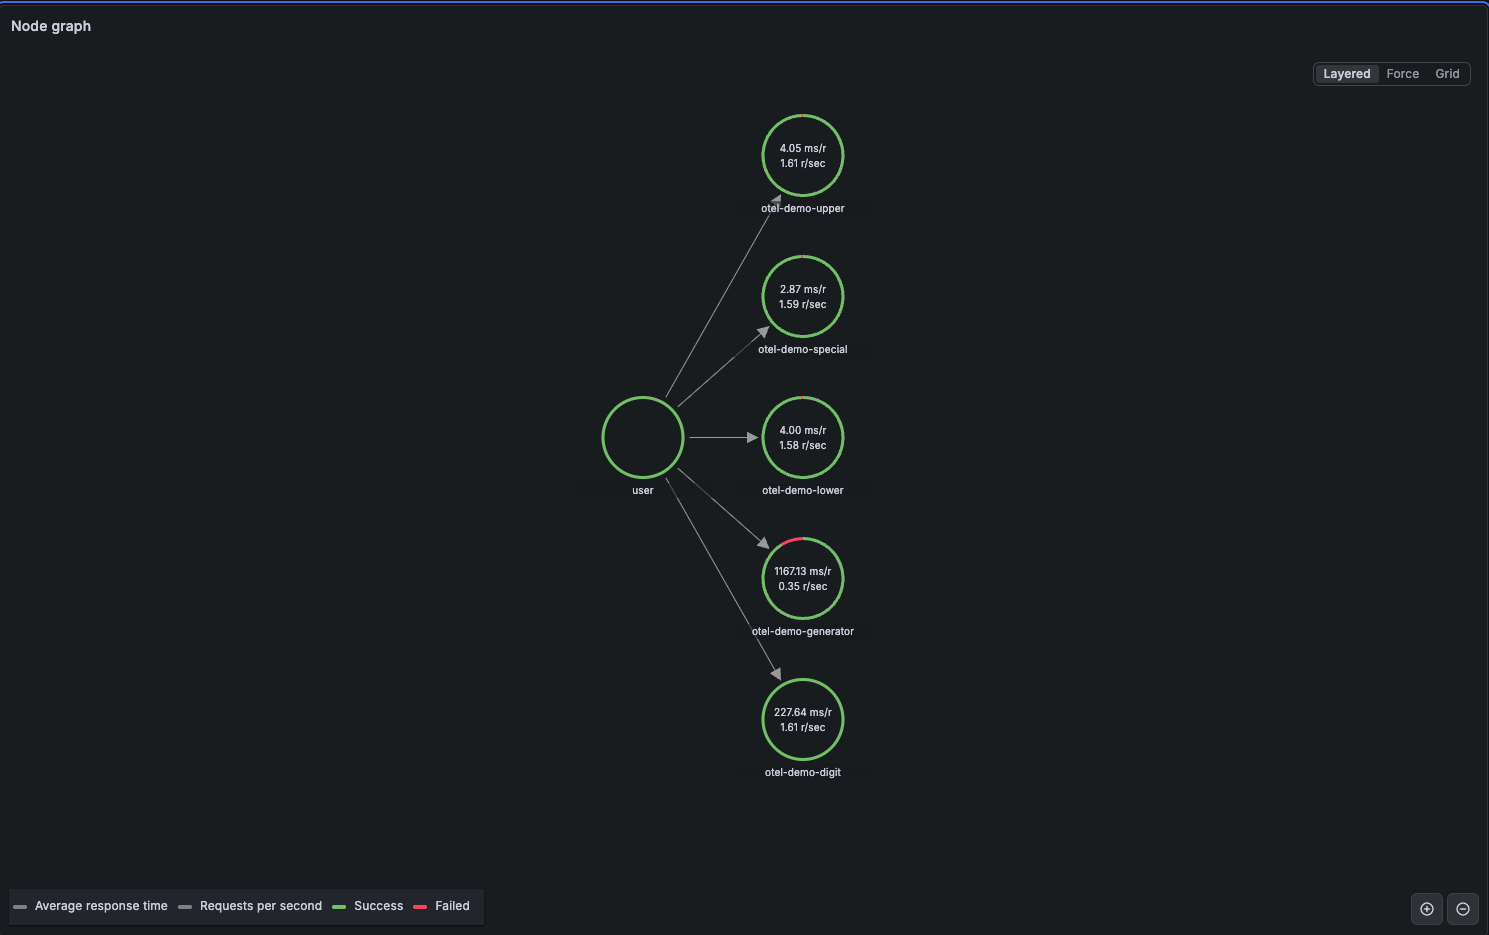
Alles in allem ist Alloy mit Beyla eBPF heute ein sehr guter Weg, um RED-Metriken von Applikationen breit auf allen virtuellen Maschinen einzusammeln. Für Distributed Traces und Service Maps taugt es aber noch nicht.
OpenTelemetry Zero-Code Auto-Instrumentation
Als Nächstes habe ich Alloy entfernt und versucht, das ganze Deployment mit der Zero-Code-Instrumentierung von OpenTelemetry zu instrumentieren. Laut der OpenTelemetry-Dokumentation funktioniert das nicht nur mit Python, sondern auch mit .NET, PHP, Java und JavaScript.
Mal sehen, wie das läuft.
Ich habe die nötigen Abhängigkeiten für die Python-Instrumentierung installiert, allen voran das OpenTelemetry SDK.
sudo pip3 install opentelemetry-distro opentelemetry-exporter-otlp
opentelemetry-bootstrap -a install
Für jeden Service habe ich die systemd-Unit-Datei angepasst:
[Unit]
Description=OpenTelemetry Demo - load Service
After=network.target

[Service]
WorkingDirectory=/home/romanhuesler/opentelemetry-demo/uninstrumented/load
ExecStart=/usr/local/bin/opentelemetry-instrument /usr/bin/python3 load.py
Restart=always
RestartSec=3
Environment=PYTHONUNBUFFERED=1
Environment=OTEL_EXPORTER_OTLP_ENDPOINT=https://my_grafana_otlp
Environment=OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf
Environment=OTEL_EXPORTER_OTLP_HEADERS="*******"
Environment=OTEL_RESOURCE_ATTRIBUTES=service.name=otel-demo-load,service.namespace=load
Environment=OTEL_TRACES_SAMPLER=always_on
Environment=OTEL_METRICS_EXPORTER=otlp
Environment=OTEL_LOGS_EXPORTER=otlp

[Install]
WantedBy=default.target
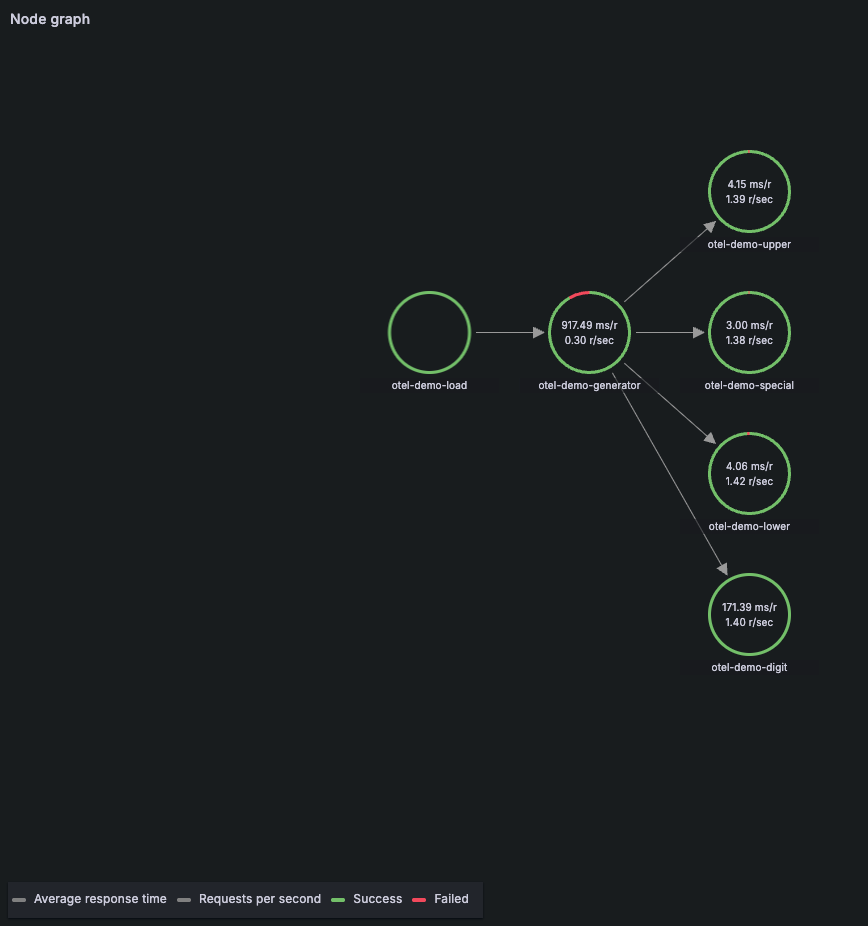
Jetzt haben wir offenbar richtiges Distributed Tracing mit Context Propagation. Die Service Map entspricht der Realität. Genau das wollen wir. Ich wünschte mir nur, es ginge noch einfacher, ohne dass wir systemd-Unit-Dateien ändern und Umgebungsvariablen setzen müssen.
OpenTelemetry Injector
Der Injector ist eine Spende von Splunk an die OpenTelemetry-Community: ein hostbasierter Mechanismus, der die OpenTelemetry Automatic Instrumentation auf jedem Linux-Host automatisch in Ihre Applikation einschleust. Er kann einen /etc/preload.so-Hook einrichten, der Prozessaufrufe überwacht, sie abfängt und die Umgebungsvariablen für OpenTelemetry ergänzt.
Der Injector unterstützt kein Python, deshalb habe ich die Microservices um zwei eigene, zusätzliche Microservices auf Basis von NodeJS erweitert.
wget https://github.com/open-telemetry/opentelemetry-injector/releases/download/v0.0.2-20251216/opentelemetry-injector_0.0.2-20251216_amd64.deb
dpkg -i opentelemetry-injector_0.0.2-20251216_amd64.deb
Das deb-Paket habe ich von der Releases-Seite heruntergeladen und installiert.
Beim ersten Versuch habe ich mich an die Installationsanleitung gehalten und die virtuelle Maschine komplett zerschossen. Sie war nicht mehr benutzbar. Beim zweiten Versuch habe ich ihn nicht zum Laufen gebracht. In Produktion wäre die Fehlersuche damit ein Albtraum. An diesem Punkt also: nein danke. Fairerweise muss ich erwähnen, dass es erst Version v0.0.2 ist, also ein Pre-Release. Geben wir ihm Zeit.
Fazit
- Grafana Alloy mit Beyla (eBPF-basiert) liefert hervorragende RED-Metriken (Rate, Errors, Duration), praktisch sofort und mit minimalem Overhead. In meiner Python-Flask-Demo auf einer einzelnen VM war das Distributed Tracing aber weniger ergiebig als erhofft: Die Context Propagation funktionierte nicht, und ich bekam meist isolierte, einzelne Spans statt durchgehend korrelierter End-to-End-Traces. Ende 2025 (Beyla 2.0+) ist sprachunabhängiges Distributed Tracing für HTTP-Services deutlich besser geworden, am stärksten ist es aber in Umgebungen mit mehreren Nodes oder in Kubernetes, wo Beyla/Alloy auf allen beteiligten Hosts läuft.
- OpenTelemetry Zero-Code Auto-Instrumentation liefert alles, was wir wollen. Wirklich einheitlich «zero-touch» über alle VMs ist sie aber nicht: In der Regel braucht es runtimespezifische Anpassungen oder eine Konfiguration pro Prozess statt eines einzigen universellen Agents, der alles von selbst entdeckt und instrumentiert.
- OpenTelemetry Injector ist ein Pre-Release und aus meiner Sicht noch nicht so weit: In Produktion lässt er sich nicht einsetzen.
Wie schafft Dynatrace seine magische Auto-Instrumentation fürs Tracing? Mit einem proprietären, stark optimierten einzelnen Agent pro Host (OneAgent), der tiefe Injektion auf Code-Ebene, Prozess-Monitoring und Netzwerkanalyse kombiniert. Keine Open-Source-Option erreicht bisher das mühelose «einmal installieren und fertig» von Dynatrace für heterogene VM-Flotten. Die Kombination aus OpenTelemetry Injector und den Auto-Instrumentation-Agents der einzelnen Sprachen (oder Beyla für eBPF-fokussierte Setups) könnte uns aber bald dorthin bringen.
Schauen Sie sich auch den Grafana Tempo Community Call an, in dem ich einige Fragen zur OpenTelemetry-Instrumentierung und zur eBPF-Instrumentierung mit Alloy gestellt habe.
