Enterprise-taugliches Kubernetes zu Hause: K3s auf Ryzen-Mini-PCs mit Cloudflare Tunnel

«Um Kubernetes richtig zu betreiben, braucht es keinen Cloud-Vertrag. Drei Mini-PCs liefern eine echte HA-Control-Plane, replizierten Storage und null offene Ports. Nehmen Sie Ihre Monatsrechnung und rechnen Sie die Differenz aus. Startups, aufgepasst.»
— Roman Hüsler, opensight.ch
TL;DR — Drei amd64-Nodes, eine zertifizierte Kubernetes-Distribution und ein Tunnel, der von innen nach aussen aufgebaut wird, statt eines Ports, der offen steht. Zwei Ryzen-Mini-PCs und ein Desktop, der ohnehin schon Staub angesetzt hat, ergeben eine echte hochverfügbare Control Plane, replizierten Storage und GitOps, für ungefähr den Preis von vier Monaten eines vergleichbaren Managed Clusters. Kein Raspberry Pi, keine öffentliche IP und nichts, was durch die Firewall weitergeleitet wird.
Alle paar Monate macht auf LinkedIn ein Homelab-Build die Runde, und die Kommentare teilen sich in dieselben zwei Lager: die, die einen Cluster zu Hause für ein Spielzeug halten, und die, die einen Raspberry Pi für einen Server halten. Beide liegen auf interessante Weise falsch, und das zweite Lager kommt teuer zu stehen.
Hier ist der Build, den ich tatsächlich zusammenstellen würde — und, nützlicher, die Überlegung hinter jeder Entscheidung, inklusive der Teile, die ich bewusst weggelassen habe.
- Die Anforderungen
- Warum in diesem Build kein Raspberry Pi steckt
- Die Hardware
- Warum K3s, und warum genau drei Server
- Aus dem Internet erreichbar, ohne einen Port zu öffnen
- Wofür pfSense hier eigentlich da ist
- Storage, der einen toten Node überlebt
- GitOps, Secrets und Zertifikate
- Observability
- Was ich bewusst weggelassen habe
- Was der Dauerbetrieb kostet
- Scale-up, Scale-out und der Schritt zu Hybrid
- Das Wichtigste in Kürze
Die Anforderungen
«Homelab» deckt alles ab, vom einzelnen Docker-Host bis zum Rack in der Garage. Was diesen Build interessant macht, ist die Bedingung, dass er sich wie etwas verhalten muss, das man einem Kunden übergeben würde:
- Eine echte Control Plane. Drei API-Server, nicht ein Master mit einem Post-it darauf.
- Aus dem Internet erreichbar — ohne öffentliche IP, ohne Dynamic-DNS-Skript und ohne weitergeleiteten Port.
- Storage, der den Ausfall eines Nodes überlebt, denn ein Node wird ausfallen, und es wird der mit der Datenbank darauf sein.
- Aus Git reproduzierbar. Wenn ich es nicht aus einem Repository neu aufbauen kann, ist es ein Haustier.
- Leise, kühl und günstig im Betrieb — er steht in einer Wohnung, nicht in einem Rechenzentrum.
Alles Weitere folgt aus diesen fünf Punkten. Wenn Ihre Bedingungen andere sind, sollte es Ihr Build auch sein. Wenn Sie auf dem Weg noch nicht so weit sind, beginnen Sie mit Was ist Kubernetes und kommen Sie dann zurück.
Warum in diesem Build kein Raspberry Pi steckt
Hier trenne ich mich von den meisten Builds, die Sie lesen werden, also werde ich lieber konkret als snobistisch.
Ein Pi 5 mit 8 GB ist eine schöne Maschine. Aber bis Sie ein anständiges Netzteil, einen NVMe-HAT, eine SSD und ein Gehäuse dazugekauft haben, sind Sie in Griffweite eines gebrauchten Ryzen-Mini-PCs, der Ihnen das Vierfache an RAM gibt, einen echten M.2-Slot an einer echten PCIe-Lane und — das, worauf es wirklich ankommt — dieselbe CPU-Architektur wie alles andere im Cluster.
Wer einen Pi in einen Allzweck-Cluster mischt, handelt sich drei konkrete Probleme ein:
- Der arm64-Long-Tail. Die grossen Charts sind inzwischen Multi-Arch. Der eine Operator, den Sie an einem Dienstagabend tatsächlich brauchen, ist es nicht, und das merken Sie während
helm install. - Scheduling von Hand. Ein Cluster mit gemischten Architekturen bedeutet Node-Affinities und Tolerations auf Workloads, denen eigentlich egal sein sollte, wo sie laufen. Das ist Hausaufgabe, kein Homelab.
- I/O. Replizierter Block-Storage ist gnadenlos, was Disk-Latenz angeht, und etcd ist es auch. SD-Karten und USB-Gehäuse sind in diesem Handel das falsche Ende.
Nichts davon macht den Pi zu einem schlechten Computer. Es macht ihn zu einem schlechten Allzweck-Cluster-Node. Als dedizierter DNS-Resolver, als Monitoring-Probe am anderen Ende der Wohnung oder als serielle Konsole — hervorragend, und ich würde mir immer noch einen kaufen. Nur nicht dafür.
Die Hardware
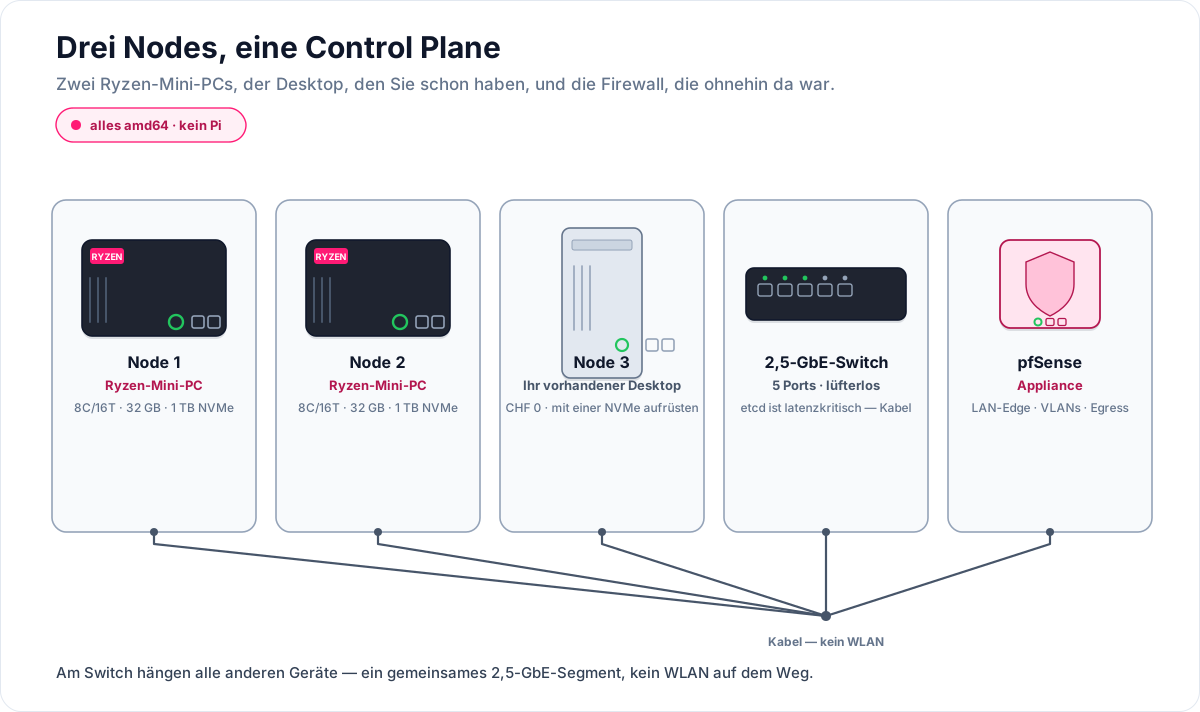
Drei Nodes, und der dritte kostet nichts, weil Sie ihn bereits besitzen. Der Desktop im Schrank — der, den Sie nicht mehr benutzt haben, seit der Laptop gut genug wurde — ist sehr wahrscheinlich ein Quad-Core mit 16 GB RAM und einem freien M.2-Slot. Das ist ein absolut respektabler Kubernetes-Node.
| Komponente | Spezifikation | Richtpreis |
|---|---|---|
| Node 1 — Ryzen-Mini-PC | 8C/16T, 32 GB DDR5, 1 TB NVMe | CHF 350–550 |
| Node 2 — Ryzen-Mini-PC | 8C/16T, 32 GB DDR5, 1 TB NVMe | CHF 350–550 |
| Node 3 — der Desktop, den Sie besitzen | was immer er ist, plus ein NVMe-Laufwerk | CHF 0–80 |
| 2,5-GbE-Switch | 5 Ports, lüfterlos | CHF 50–80 |
| pfSense-Appliance | steht schon am Rand des Netzwerks | CHF 0 |
| Neue Ausgaben | ≈ CHF 800–1200 |
Zwei ehrliche Anmerkungen zu dieser Tabelle. Erstens: Die Spanne ist echt. Mini-PC-Preise schwanken je nach Generation stark, und der Ryzen vom letzten Jahr mit 32 GB ist der Sweet Spot, nicht der von diesem Jahr mit 16 GB. Kaufen Sie RAM statt Taktrate — der Speicher geht Ihnen lange vor den Kernen aus. Zweitens: Preise bewegen sich. Prüfen Sie sie selbst, statt einer Tabelle in einem Blog zu vertrauen, diese hier eingeschlossen.
Verkabeln Sie die drei Nodes mit dem Switch. WLAN ist gut für Ihren Laptop und eine schlechte Idee für ein verteiltes Konsensprotokoll.
Warum K3s, und warum genau drei Server
K3s ist eine CNCF-zertifizierte Kubernetes-Distribution — dieselbe API, dieselben Manifeste, dasselbe kubectl. Was sie wegnimmt, ist Betriebsaufwand: Sie kommt als einzelnes Binary und bringt ihren eigenen Ingress-Controller, Service-Load-Balancer, lokalen Storage-Provisioner und Helm-Controller mit. Auf Hardware dieser Grösse spart Ihnen das ein Wochenende und etwa ein Gigabyte RAM.
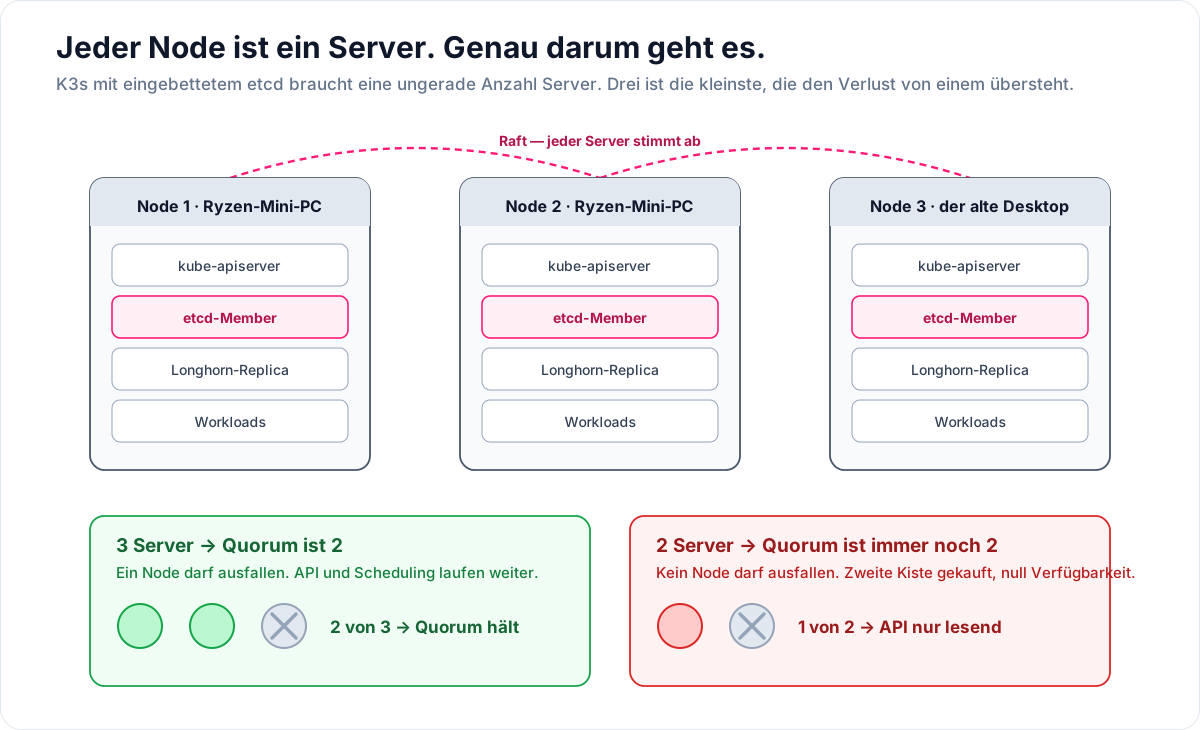
Die wichtige Designentscheidung ist, dass alle drei Nodes Server sind, nicht ein Server und zwei Agents. K3s kann seinen Datastore als eingebetteten etcd-Cluster betreiben, und die K3s-Dokumentation ist unmissverständlich, was die Bedingung angeht: Ein HA-Cluster mit eingebettetem etcd muss eine ungerade Anzahl Server haben, weil das Quorum für n Server (n/2)+1 beträgt.
Rechnen Sie das für zwei Server durch, und Sie erhalten das Ergebnis, das viele überrascht: Das Quorum ist immer noch 2, ein Cluster mit zwei Servern toleriert also null Ausfälle. Sie haben eine zweite Maschine gekauft und keinerlei Verfügbarkeit. Drei Server ergeben ein Quorum von 2, das heisst, ein Node kann ausfallen — durch einen Defekt oder weil Sie ihn gerade aktualisieren — und der Cluster bedient weiter.
Den ersten Node bootstrappen:
curl -sfL https://get.k3s.io | sh -s - server \
  --cluster-init \
  --write-kubeconfig-mode 644
Den Join-Token holen und dann die anderen beiden ebenfalls als Server hochfahren:
# on node 1
sudo cat /var/lib/rancher/k3s/server/node-token

# on nodes 2 and 3
curl -sfL https://get.k3s.io | sh -s - server \
  --server https://192.168.20.11:6443 \
  --token <token> \
  --write-kubeconfig-mode 644
Prüfen:
kubectl get nodes
# NAME    STATUS   ROLES                       AGE   VERSION
# k3s-1   Ready    control-plane,etcd,master   4m    v1.33.x+k3s1
# k3s-2   Ready    control-plane,etcd,master   2m    v1.33.x+k3s1
# k3s-3   Ready    control-plane,etcd,master   1m    v1.33.x+k3s1
Ein Fallstrick, den man klar aussprechen sollte: etcd-Writes sind an fsync gebunden. Jeder Server ist jetzt ein etcd-Member, auch der wiederverwendete Desktop. Wenn dieser Desktop noch von der drehenden Festplatte bootet, mit der er 2016 ausgeliefert wurde, wird etcd Ihnen das in den Logs mitteilen, und der ganze Cluster wird sich träge anfühlen. Bauen Sie ein NVMe-Laufwerk ein, bevor er beitritt. Diese CHF 60 sind das Geld mit der grössten Hebelwirkung im ganzen Build.
Aus dem Internet erreichbar, ohne einen Port zu öffnen
Das ist der Teil, den die meisten Homelab-Beschreibungen falsch machen, und es ist der Teil, der entscheidet, ob der Build «produktionsnah» ist oder nur «läuft zu Hause».
Die klassische Antwort ist Dynamic DNS plus Portweiterleitung, also die IP-Adresse eines Privatanschlusses mit offenem Port 443 zum Internet und ein Reverse Proxy, um dessen CVE-Feed Sie sich jetzt kümmern müssen. Die bessere Antwort ist, die Richtung der Verbindung umzukehren.
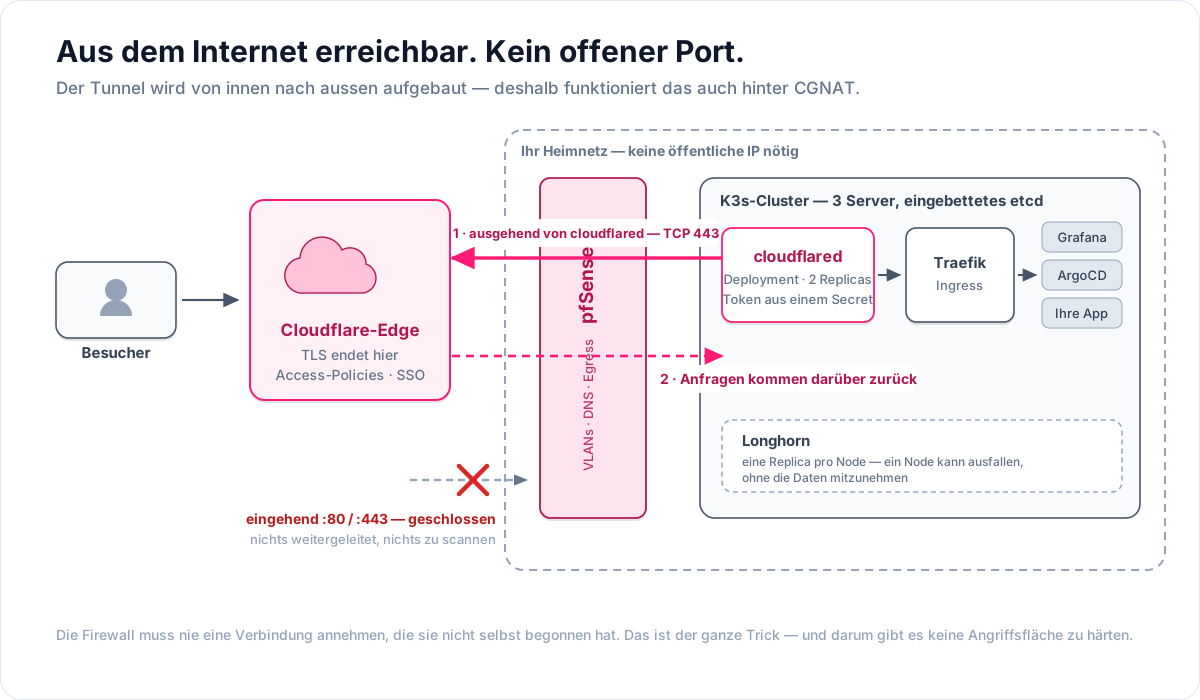
Ein Cloudflare Tunnel funktioniert so, dass ein kleiner Daemon, cloudflared, innerhalb Ihres Netzwerks läuft. Er baut eine ausgehende Verbindung zur Cloudflare-Edge auf, und Anfragen für Ihren Hostnamen kommen über diese Verbindung zurück. Auf Ihrem WAN-Interface lauscht nichts. Es gibt keine Portweiterleitung, kein Dynamic-DNS-Skript und keine eingehende Firewall-Regel — und weil die Verbindung ausgehend ist, funktioniert sie auch hinter CGNAT, wie es bei immer mehr Schweizer und europäischen Anschlüssen der Fall ist.
Zwei kommerzielle Anmerkungen, weil sie die Rechnung verändern: Der Tunnel selbst ist kostenlos, und Cloudflares Zero-Trust-Free-Plan deckt bis zu 50 Benutzer ab. Der zweite Punkt wiegt schwerer, als er klingt. Er bedeutet, dass Sie vor Ihre Grafana- und ArgoCD-Dashboards eine echte Identitätsprüfung setzen können — SSO, nicht ein Passwort in einem Lesezeichen — ohne Lizenz. Für ein Homelab ist das das grösste Sicherheits-Upgrade, das es für null Franken gibt.
Wo cloudflared laufen soll — drei Optionen, und welche ich wählen würde
Option A — im Cluster, als Deployment. Meine Wahl. Sie bekommen zwei Replicas auf zwei Nodes gratis dazu, die Konfiguration liegt mit allem anderen in Git, und der Tunnel hat denselben Lebenszyklus wie das, was er exponiert.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cloudflared
  namespace: cloudflare
spec:
  replicas: 2
  selector:
    matchLabels: { app: cloudflared }
  template:
    metadata:
      labels: { app: cloudflared }
    spec:
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: kubernetes.io/hostname
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels: { app: cloudflared }
      containers:
        - name: cloudflared
          image: cloudflare/cloudflared:latest
          args: ["tunnel", "--no-autoupdate", "run"]
          env:
            - name: TUNNEL_TOKEN
              valueFrom:
                secretKeyRef:
                  name: cloudflared-token
                  key: token
          resources:
            requests: { cpu: 50m, memory: 64Mi }
            limits:   { memory: 128Mi }
Richten Sie im Cloudflare-Dashboard den öffentlichen Hostnamen auf Ihren Ingress-Service im Cluster — http://traefik.kube-system.svc.cluster.local:80 — und lassen Sie Traefik das hostbasierte Routing machen, das es ohnehin schon macht. TLS wird an der Cloudflare-Edge terminiert; innerhalb des Clusters sind Sie im Pod-Netzwerk.
Option B — auf dem Desktop-Node, als systemd-Service. Einfacher zu durchschauen und für den Anfang wirklich in Ordnung. Aber es ist ein Single Point of Failure ausserhalb Ihres GitOps-Repositorys, und genau diese Art Ding läuft sechs Monate später immer noch, mit einer Konfiguration, die niemand mehr findet.
Option C — auf der pfSense-Box. Architektonisch ist das die saubere Antwort: Der Tunnel endet am Netzwerkrand, dort, wo das Edge-Gerät steht. Ich habe nachgeforscht, wie man das ordentlich macht, und das ehrliche Ergebnis ist: Man sollte es nicht tun.
Es gibt kein offizielles pfSense-Paket für cloudflared. Der Feature-Request ist seit August 2023 offen; ein Entwickler schrieb dort, er habe den Grossteil eines Pakets gebaut, kämpfe aber damit, die rc.d-Start/Stop-Skripte zum Laufen zu bringen. Sie können auf pfSense das Upstream-FreeBSD-Repository aktivieren und das FreeBSD-Paket cloudflared von Hand installieren, und manche tun das auch — aber cloudflared service install wird unter FreeBSD nicht unterstützt, Sie schreiben die Service-Skripte also selbst, und Pakete, die ausserhalb von pfSenses eigenem Repository installiert wurden, müssen Firmware-Upgrades nicht zwingend überleben.
Für eine Box, deren ganze Aufgabe es ist, das langweiligste und verfügbarste Gerät im Netzwerk zu sein, ist das ein schlechter Tausch. Wenn sich die Antwort ändert und ein ordentliches Paket erscheint, wird es zur eleganten Option. Heute ist es eine Wartungslast. Der Tunnel kommt in den Cluster.
Wofür pfSense hier eigentlich da ist
Vom Tunnel-Dienst befreit, erledigt die Firewall die drei Dinge, die diesen Build «enterprise-tauglich» statt bloss «funktionierend» machen — und es sind genau die drei Dinge, die Homelab-Beiträge überspringen:
- Segmentierung. Der Cluster bekommt sein eigenes VLAN. Er kann das Familien-NAS, den Fernseher oder den Drucker nicht erreichen, und die erreichen ihn nicht. Wenn Sie um Mitternacht etwas von Docker Hub deployen, ist das die Kontrolle, die dafür sorgt, dass es nicht sonderlich ins Gewicht fällt.
- Egress-Regeln. Das Lab-VLAN braucht ausgehend 443 für den Tunnel und Registry-Pulls, DNS zur Firewall und NTP. Das ist schon fast die ganze Liste. Default-Deny für ausgehenden Traffic ist einen Nachmittag lang lästig und für immer still wertvoll.
- Split-Horizon-DNS. Lösen Sie
*.lab.example.chim LAN auf die interne Ingress-Adresse auf und von aussen über Cloudflare. Dieselbe URL am Schreibtisch und auf dem Handy im Mobilnetz, ohne dass der Traffic per Hairpinning zur Edge und zurück läuft.
Wenn Sie beim Härten dessen, was hinter dem Ingress liegt, weiter gehen wollen, gilt das WAF-Material nach wie vor: Kubernetes NGINX WAF — Ingress-Härtung mit mod_security und OWASP CRS.
Storage, der einen toten Node überlebt
K3s bringt local-path als Standard-Storage-Class mit, die auf die eigene Disk des Nodes schreibt. Für Wegwerfdaten ist das in Ordnung, für alles, was Ihnen wichtig ist, fatal: Das Volume ist an diesen Node gebunden, und wenn der Node weg ist, sind es die Daten auch.
Longhorn repliziert Block-Volumes über Nodes hinweg. Es hat zwei Voraussetzungen, die man kennen sollte, bevor man anfängt: open-iscsi muss auf jedem Node installiert sein und iscsid dort laufen, und die standardmässige Replica-Anzahl von drei braucht drei Nodes, auf die sie verteilt werden kann — genau das, was wir haben.
# every node, before installing Longhorn
sudo apt install -y open-iscsi nfs-common
sudo systemctl enable --now iscsid
Dann die Kapazitätsrechnung, an der viele hängen bleiben: Drei Replicas von allem bedeuten, dass 3 TB rohe NVMe-Kapazität ungefähr 1 TB nutzbar ergeben. Wenn das schmerzt, setzen Sie die Standard-Replica-Anzahl auf 2 — Sie überleben immer noch den Ausfall eines Nodes und bekommen die Hälfte Ihrer Disk zurück. Bei drei Nodes hätte ich lieber die Kapazität.
Und der Satz, der in jeden Storage-Abschnitt gehört: Replikation ist kein Backup. Longhorn schützt Sie vor einer toten Disk. Es schützt Sie nicht vor kubectl delete pvc, und es repliziert Ihre Fehler in Leitungsgeschwindigkeit. Richten Sie das Backup-Target von Longhorn auf Object Storage und prüfen Sie, dass ein Restore tatsächlich funktioniert — dieselbe Disziplin wie bei Simple do-it-yourself backup with Google Cloud Storage, eine Schicht tiefer.
GitOps, Secrets und Zertifikate
Anforderung vier war «aus Git reproduzierbar», was in der Praxis ArgoCD bedeutet und ein Repository, das den Cluster beschreibt. Bootstrappen Sie ArgoCD einmal von Hand, richten Sie es auf das Repo und lassen Sie es alles andere verwalten — sich selbst eingeschlossen. Ab dann ist der ehrliche Test des Builds, ob Sie einen Node plattmachen, neu aufbauen und die Reconciliation ihn wiederherstellen lassen können, ohne dass Sie sich an irgendetwas erinnern müssen.
Zwei unterstützende Bausteine:
- Secrets. Nichts im Klartext in Git, niemals, auch nicht in einem privaten Repo. Sealed Secrets ist hier der richtige erste Schritt — mit dem Public Key des Clusters verschlüsseln, den Ciphertext committen, und nur dieser Cluster kann ihn öffnen. Greifen Sie zu Vault, wenn Sie wirklich dynamische, kurzlebige Credentials brauchen statt verschlüsselter statischer; auf drei Nodes sind das viele bewegliche Teile für etwas, das Sealed Secrets bereits erledigt.
- Zertifikate. Cloudflare terminiert TLS an der Edge für alles, was durch den Tunnel kommt, aber intern wollen Sie trotzdem echte Zertifikate. cert-manager mit der DNS-01-Challenge gegen Ihre Cloudflare-Zone stellt sie aus, ohne etwas zum Internet hin zu exponieren — genau dafür gibt es DNS-01 überhaupt.
Wer die CI-Hälfte dieser Geschichte sucht: Container mit GitLab und Kaniko auf einem privaten Cluster bauen behandelt das Bauen von Images auf derselben Hardware, auf der sie laufen.
Observability
Installieren Sie kube-prometheus-stack, und Sie haben Prometheus, Alertmanager, Grafana sowie die Node- und Control-Plane-Dashboards in einem einzigen Helm-Release. Behalten Sie bei drei Nodes vor allem zwei Dinge im Auge: die etcd-Schreiblatenz, die Ihnen sofort zeigt, wenn die Disk eines Nodes das schwache Glied ist, und die Gesundheit der Longhorn-Volumes.
Zwei Dinge würde ich am ersten Tag einrichten statt am neunzigsten. Geben Sie Prometheus ein Longhorn-Volume, sonst wirft jeder Neustart Ihre Historie weg, und Sie verlieren die Möglichkeit, die Frage «war das schon immer so?» zu beantworten. Und stellen Sie den Grafana-Ingress hinter eine Cloudflare-Access-Policy — ein Dashboard, das über einen Tunnel exponiert ist, ist trotzdem exponiert.
Wenn die Graphen bei grossen Zeitbereichen zu verschwinden beginnen, steht die Erklärung in Fortgeschrittene Prometheus-Abfragen für sparse Daten. Und wenn Sie Telemetrie lieber über OpenTelemetry Collectors schicken, statt alles direkt zu scrapen, steht das Kostenargument dafür, sie an der Quelle zu formen, in Observability-Kosten an der Quelle senken.
Was ich bewusst weggelassen habe
Die Stack-Listen, die auf LinkedIn kursieren, sind meist additiv — jedes Tool, das irgendwer erwähnt hat, steht im Diagramm. Hier ist, was ich auf drei Nodes nicht installieren würde, und warum:
- kube-vip. Eine Floating-VIP ist die Standardantwort für einen hochverfügbaren API-Endpunkt. Aber wenn jede eingehende Anfrage durch den Tunnel kommt, gibt es keine Ingress-VIP, die wandern müsste. Es lohnt sich trotzdem, wenn
kubectlden Verlust genau des Nodes überstehen soll, auf den Ihre kubeconfig zeigt — ein echtes Ärgernis, nur ein kleineres, als es klingt. - Rancher. Eine Management-UI für einen Cluster, den Sie bereits deklarativ aus Git verwalten, ist hauptsächlich Ballast. Sie verdient ihren Platz, wenn Sie mehrere Cluster haben und andere Leute sie nutzen.
- Ein Service Mesh. Drei Nodes und eine Handvoll Services haben kein Service-to-Service-Problem, das eine zusätzliche Control Plane wert wäre. Kommen Sie darauf zurück, wenn Sie Anforderungen an Mutual TLS oder Traffic-Splitting haben, die Sie laut benennen können.
- Ein zweites Storage-System. Longhorn für Block-Storage und Object Storage ausserhalb der Box für Backups. MinIO auf Longhorn auf NVMe zu stapeln, sind drei Schichten für ein Lab dieser Grösse — legen Sie die S3-Schicht dorthin, wo sie hingehört: weg von dem Cluster, den Sie sichern.
Jedes davon ist in einer grösseren Umgebung vertretbar. Die Disziplin besteht darin, sagen zu können, warum es hier nicht steht, statt es hinzuzufügen, weil das Diagramm leer aussah.
Was der Dauerbetrieb kostet
Der Kaufpreis ist die Zahl, die alle nennen. Die Betriebskosten sind die Zahl, die entscheidet, ob das Ding nächstes Jahr noch eingeschaltet ist — und die Rechnung ist einfach genug, um sie für Ihre eigene Hardware zu machen:
Watt × 24 × 365 ÷ 1000 = kWh pro Jahr
kWh per year × your tariff = the bill
Nehmen wir plausible Zahlen: zwei Mini-PCs im Leerlauf mit je etwa 15 W, der alte Desktop mit etwa 50 W, weil Desktop-Netzteile am unteren Ende ihres Bereichs ineffizient sind, und 5 W für den Switch. Das sind rund 85 W Dauerlast oder etwa 745 kWh pro Jahr.
Was das kostet, hängt enorm davon ab, wo Sie wohnen, und in der Schweiz ist die Spanne grösser, als die meisten erwarten. Für 2026 zahlt ein Haushalt je nach Gemeinde zwischen knapp 10 Rp./kWh und mehr als 43 Rp./kWh, wobei der nationale Durchschnitt etwa 4 % unter 2025 liegt. Dieselben 745 kWh kosten also in den günstigsten Gemeinden rund CHF 75 pro Jahr, bei mittleren 28 Rp./kWh etwa CHF 210 und in den teuersten rund CHF 325. Schlagen Sie Ihren eigenen Tarif im Strompreis-Portal der ElCom nach, bevor Sie entscheiden, ob dieser Build günstig ist.
An welchem Ende Sie auch landen, das Verhältnis liefert die wirklich nützliche Erkenntnis dieses ganzen Builds: Der Gratis-Node ist der teure. Bei diesen Zahlen zieht der wiederverwendete Desktop knapp 60 % des Stroms für einen Bruchteil der Rechenleistung. Mit ihm anzufangen, ist trotzdem absolut richtig — er kostet nichts und macht den Cluster heute real. Aber wenn er irgendwann stirbt, ersetzen Sie ihn durch einen dritten Mini-PC statt durch einen weiteren Tower. Bei einem mittleren Tarif amortisiert sich der Ersatz über den Strom in etwa zwei Jahren, und er ist leiser.
Messen Sie Ihre eigenen Werte, statt meinen Zahlen zu vertrauen. Ein Zwischenstecker-Strommessgerät für CHF 20 verrät Ihnen mehr über Ihren Build als jeder Blogbeitrag, dieser eingeschlossen.
Scale-up, Scale-out und der Schritt zu Hybrid
Der naheliegende Einwand gegen alles oben ist, dass drei Nodes in einer Wohnung eine Demo sind, keine Plattform. Das stimmt genau so lange, bis Sie den vierten Node brauchen — und dann zählt nur noch die Frage, ob der Build wächst oder neu gebaut wird. Dieser wächst, in drei Schritten, und ihre Reihenfolge ist wichtiger als jeder einzelne davon.
Zuerst Scale-up, weil es der günstigste Schritt ist
Die erste Grenze auf dieser Hardware ist der Speicher, nicht die CPU. Kubernetes überbucht CPU bereitwillig und Speicher überhaupt nicht, also ist der Pod, der an einem Dienstagabend evicted wird, knapp an RAM. Mini-PCs dieser Klasse nehmen in der Regel zwei SO-DIMMs auf, damit sind 32 GB bis 64 GB ein Schraubenzieher und zwanzig Minuten — und, wichtiger noch, es ändert sonst nichts. Kein neues etcd-Member, keine neue Failure Domain, kein Rebalancing, keine zusätzliche Konsenslatenz.
Mit der Disk ist es dasselbe: Eine grössere NVMe gibt Longhorn einfach mehr Platz, und die Kapazitätsrechnung von vorhin gilt weiterhin — bei drei Replicas ist jedes zusätzliche Terabyte ein Drittel Terabyte nutzbar. Skalieren Sie hoch, bis die Kisten voll sind. Es ist der einzige Schritt auf dieser Liste, der Kapazität hinzufügt, ohne etwas hinzuzufügen, das Sie danach betreiben müssen.
Dann Scale-out — und zwar mit Agents, nicht mit Servern
Wenn die Kisten voll sind, liegt es nahe, eine vierte Maschine zu kaufen und sie genau so zu installieren wie die ersten drei. Tun Sie es nicht.
Die Quorum-Rechnung hört oberhalb von drei nicht auf zu gelten. K3s verlangt für einen HA-Cluster mit eingebettetem etcd eine ungerade Anzahl Server, und die eigene Guidance von etcd ist deutlicher, als die meisten erwarten: Ein Member hinzuzufügen, das den Cluster auf eine gerade Anzahl bringt, bringt überhaupt keine zusätzliche Fehlertoleranz, und ein Write ist erst abgeschlossen, wenn eine Mehrheit der Member ihn bestätigt hat — jedes zusätzliche Member ist also eine weitere Maschine, auf die ein Write am Ende warten kann. Drei Server sind eine gute Zahl. Fünf sind das, worauf Sie wechseln, wenn Sie wirklich den gleichzeitigen Ausfall von zweien überleben müssen. Sieben ist die praktische Obergrenze, und die erreichen Sie in einer Wohnung nicht.
Lassen Sie die Control Plane also bei drei und fügen Sie stattdessen Agents hinzu:
curl -sfL https://get.k3s.io | sh -s - agent \
  --server https://192.168.20.11:6443 \
  --token <token>
Agents führen Workloads aus und halten kein etcd. Fügen Sie so viele hinzu, wie Sie sich leisten können, und keiner davon kann den Konsens verlangsamen — genau darum geht es bei der Aufteilung.
Hier beginnen auch zwei der Dinge, die ich weggelassen habe, ihren Platz zu verdienen. Wenn die Workloads auf Agents leben, versehen Sie die Server mit einem Taint, damit Benutzer-Pods von der Control Plane fernbleiben — K3s nimmt genau dafür --node-taint CriticalAddonsOnly=true:NoExecute entgegen —, und kube-vip wird den Aufwand wert, denn jetzt gibt es eine Flotte von Maschinen, und Ihre kubeconfig sollte keine bestimmte davon nennen. Ein Longhorn-Detail, über das viele stolpern: Nicht jeder Agent muss ein Storage-Node sein. Labeln Sie die mit echter NVMe darin und lassen Sie die Replicas dort schedulen statt auf der günstigen Kiste, die Sie für Rechenleistung gekauft haben.
Dann hybrid — zwei Cluster, nicht ein gestreckter
«Hybrid Cloud» wird in dieser Grössenordnung meist verkehrt herum angegangen: eine VM mieten, sie als vierten Node in den Heim-Cluster aufnehmen, sich clever fühlen. Was Sie tatsächlich gebaut haben, ist eine Konsensgruppe mit dem öffentlichen Internet mittendrin. etcd ist an fsync und Round-Trips gebunden — derselbe Grund, warum der alte Desktop eine NVMe braucht und die Nodes am Kabel statt am WLAN hängen, nur dass eine WAN-Verbindung um eine Grössenordnung schlechter ist als beides. Strecken Sie keine Control Plane über eine Leitung, die Ihnen nicht gehört.
Die Variante, die funktioniert, sind zwei Cluster und eine Beschreibung davon. Bauen Sie einen zweiten K3s-Cluster in einer Cloud auf — oder in einem Colo, oder am anderen Ende eines Familien-VPN — und richten Sie dasselbe ArgoCD-Repository auf beide. Hier zahlt sich Anforderung vier still und leise aus: Wenn der Cluster wirklich aus Git reproduzierbar ist, ist der zweite ein Verzeichnis in einem Repo und ein Nachmittag, kein Projekt. Dann teilen Sie die Workloads danach auf, wo sie leben wollen:
- Zu Hause. Alles mit Data Gravity, alles, dessen Kosten von CPU-Stunden dominiert werden, die Sie schon bezahlt haben — CI-Runner, Batch-Jobs, Indexierung, das Modell, mit dem Sie diesen Monat experimentieren.
- In der Cloud. Alles, was weiterlaufen muss, während Sie Möbel am Switch vorbeitragen, und alles, dessen Verfügbarkeit Sie jemand anderem schriftlich versprochen haben.
Die Naht zwischen beiden ist Cloudflare, und hier zahlt die Entscheidung für den ausgehenden Tunnel eine Dividende aus, mit der bei drei Nodes niemand rechnet: Beide Standorte werden auf genau dieselbe Weise erreicht, aus Sicht des Internets gibt es also kein «zu Hause» und keine «Cloud» — es gibt zwei Origins hinter einem Hostnamen. Cloudflares Empfehlung dafür ist ein Tunnel pro Standort und ein Load-Balancer-Pool pro Tunnel, was Health Checks, Steering und Failover an die Edge verlegt statt in DNS hinter eine TTL, die Sie aussitzen müssen. Load Balancing ist ein kostenpflichtiges Add-on ab $5 pro Monat — ungefähr der Moment, in dem ein Homelab aufhört, ein Hobbybudget zu sein, und ein guter Moment, sich zu fragen, ob Sie es schon gebraucht haben.
Symmetrisch muss es auch nicht sein. Ein Single-Node-Cluster in der Cloud, dessen ganze Aufgabe es ist, eine Statusseite auszuliefern, während die Wohnung keinen Strom hat, ist ein vollkommen legitimes Hybrid-Setup.
Das ist auch die ehrliche Antwort auf die SLA-Frage, und es lohnt sich, sie von der Zuverlässigkeitsfrage zu trennen. Drei Nodes in einer Wohnung sind tatsächlich verfügbarer als eine einzelne Cloud-VM — der Quorum-Rechnung ist egal, wo die Maschinen stehen. Was die Wohnung Ihnen nicht geben kann, ist eine Zusage: ein Uplink, ein Stromzähler, ein Vermieter und niemand auf Pikett ausser Ihnen. Eine Verfügbarkeitszahl, die Sie in einen Vertrag schreiben können, braucht eine zweite Failure Domain und den Pikettdienst von jemand anderem dahinter. Deshalb lebt das SLA an der Edge statt im Keller — der Load-Balancer-Pool antwortet weiter, während ein Origin dunkel ist.
Damit kommt die Zahl ins Spiel, die Texte über Enterprise-Tauglichkeit meist ganz auslassen: Vier Neunen schafft jeder mit unbegrenztem Budget. Das interessante Problem ist die günstigste Architektur, die die unterschriebene Zusage trotzdem einhält — und jede Sprosse dieser Leiter, die Sie noch nicht erklimmen müssen, ist Marge.
Cloudflare dort einstreuen, wo es dem Cluster Arbeit abnimmt
Der beste Skalierungsschritt ist oft nicht, einen Node hinzuzufügen. Sondern die Arbeit gar nicht erst an einen zu schicken. Drei Dienste, die sich einzubinden lohnen, in der Reihenfolge, in der ich es tun würde:
- Caching an der Edge. Jede Anfrage durch den Tunnel läuft bereits über Cloudflares Netzwerk, Caching ist also eine Konfigurations- statt einer Architekturentscheidung. Mit Cache Rules — zehn davon im Free-Plan — markieren Sie Pfade als cachebar und setzen eine Edge-TTL, auch für Dinge, die nur dynamisch aussehen. Ein Cache-Hit läuft nie durch den Tunnel, erreicht nie einen Node und verbraucht nie Ihre Upload-Bandbreite, die auf einem privaten Anschluss mit Abstand die knappere Ressource ist.
- R2 für Object Storage. Das ist der Punkt «legen Sie die S3-Schicht dorthin, wo sie hingehört» von vorhin, konkret gemacht. Longhorn akzeptiert jedes S3-kompatible Backup-Target — Credentials plus einen AWS_ENDPOINTS-Wert in einem Secret —, und R2 funktioniert als solches. Standard-Storage kostet $0.015 pro GB-Monat, mit 10 GB-Monaten gratis und ohne Egress-Gebühren, und der letzte Teil ist die Zahl, auf die es wirklich ankommt: An dem Tag, an dem Sie das Backup brauchen, kostet es nichts als Zeit, mehrere hundert Gigabyte über die eigene Leitung zurückzuholen. Derselbe Bucket auf einer Custom Domain ist auch der richtige Ort für Benutzer-Uploads und Medien — ausgeliefert und gecacht von der Edge statt von einem Mini-PC im Schrank.
- Access vor allem Internen, nicht nur vor Grafana. Es kostet bis 50 Benutzer nichts, und der zusätzliche Aufwand für jeden neuen Service ist eine Policy statt einer Auth-Integration. Sobald Sie mehr Dashboards haben, als Sie sich merken können, ist das der Unterschied zwischen SSO und einem Lesezeichenordner voller Passwörter.
Einstreuen ist das richtige Wort dafür. Jeder dieser Dienste gibt ein Stück Ihrer Plattform an die eines anderen ab, und jeder, den Sie hinzufügen, ist eine Abhängigkeit, aus der sich der Cluster nicht herausreconcilen kann, wenn sie wegfällt. Für Caching und Backups lohnt sich dieser Tausch klar — die Daten existieren so oder so weiterhin zu Hause. Denken Sie deutlich länger nach, bevor irgendetwas nur dort oben lebt.
Die Leiter also: die Kisten füllen, dann Agents hinzufügen, dann einen zweiten Cluster, und die Edge abfangen lassen, was sie kann. Jede Sprosse lässt die früheren Entscheidungen intakt — immer noch drei Server, immer noch ein Repository, immer noch nichts, was durch die Firewall weitergeleitet wird. Bei Enterprise-Tauglichkeit ging es nie um die Grösse der Hardware. Es geht darum, ob Sie ein SLA zusagen und einhalten können — und ob der nächste Schritt nach oben ein Upgrade ist oder eine Neuentwicklung. Die Zusage ist das, was Kunden kaufen; die Kosten, sie einzuhalten, entscheiden, ob das Geschäft funktioniert. Die Finanzseite derselben Frage — warum die IT-Rechnung so oft auf dem falschen Tisch landet — bekommt eine eigene Antwort.
Das Wichtigste in Kürze
- Drei Nodes, alle als Server. Eingebettetes etcd braucht eine ungerade Anzahl; zwei Server tolerieren null Ausfälle und kosten Sie eine zweite Maschine für nichts.
- Für Cluster-Nodes den Pi weglassen. Einheitliche Architektur und NVMe sind mehr wert als der Preisunterschied, und ein gebrauchter Ryzen-Mini-PC ist kaum ein Preisunterschied.
- Die Verbindung umkehren. Ein ausgehender Tunnel beseitigt die gesamte eingehende Angriffsfläche, funktioniert hinter CGNAT und bringt kostenloses SSO für interne Dashboards gleich mit.
- Den Tunnel im Cluster betreiben, nicht auf der Firewall. pfSense hat kein offizielles cloudflared-Paket, und der Request ist seit 2023 offen — halten Sie das Edge-Gerät langweilig.
- Der Firewall die Aufgabe geben, die sie gut kann: VLAN-Segmentierung, Default-Deny für Egress, Split-Horizon-DNS.
- Replikation ist kein Backup. Longhorn überlebt eine tote Disk. Einen falschen
kubectl-Befehl repliziert es genauso zuverlässig. - Den Strom einrechnen, nicht nur den Kaufpreis. In der Schweiz je nach Gemeinde zwischen rund CHF 75 und CHF 325 pro Jahr — und den Grossteil davon verbraucht der Gratis-Node.
- In der richtigen Reihenfolge wachsen. Zuerst RAM, dann Agent-Nodes, dann ein zweiter Cluster, verbunden an der Edge. Zusätzliche Server kaufen Schreiblatenz statt Verfügbarkeit, und eine über eine WAN-Leitung gestreckte Control Plane kauft keins von beidem.
- Ein SLA ist eine Zusage, keine Anzahl Maschinen. Verfügbarkeit, die Sie in einen Vertrag schreiben können, braucht eine zweite Failure Domain und den Pikettdienst von jemand anderem — und das Handwerk besteht darin, die günstigste zu kaufen, die die unterschriebene Zahl trotzdem einhält.
Der Sinn eines solchen Builds ist nicht, dass er günstig ist. Sondern dass die Bedingungen echt sind: Die Quorum-Rechnung verhält sich auf drei Mini-PCs genauso wie auf drei Cloud-Instanzen, und ein Storage-System, das noch nie einen Node verloren hat, wurde noch nie getestet. Günstig ist das, was es möglich macht, Dinge absichtlich kaputtzumachen.
Mehr davon? Abonnieren — im nächsten Beitrag läuft Qwen3.8-27B auf Heim-Hardware, und wir rechnen aus, was das wirklich kostet.